
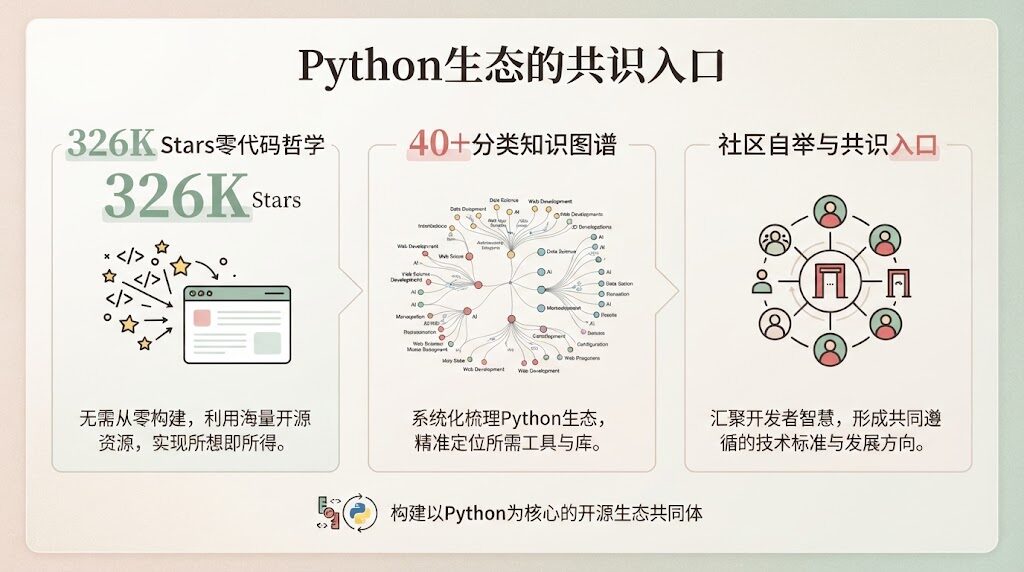
GitHub 上有一类项目,没有一行可执行代码,却常年霸榜:vinta/awesome-python 就是其中最极端的那个——326,432 颗星、28,907 个 Fork、十年累计维护。它回答的问题很简单:「我想用 Python 做 X,该用什么工具?」而它做对的事情,远不止于回答这个问题。
一、项目速览
| 字段 | 值 |
|---|---|
| 项目名 | vinta/awesome-python |
| GitHub | https://github.com/vinta/awesome-python |
| Stars | 326,432 ⭐ |
| Forks | 28,907 |
| 语言 | Python |
| 许可证 | CC0(公有领域,无版权限制) |
| 最新推送 | 2026-10-11 03:35 UTC(每日仍在更新) |
| 创建时间 | 2014-06-27(已持续维护 12 年) |
| 官网 | https://awesome-python.com/ |
| 话题标签 | awesome, awesome-list, python, python-frameworks, python-libraries, python-tools |
看不懂 326K stars 是什么概念?做个对比:Python 官方标准库的 GitHub 镜像只有 64K stars,知名 Web 框架 Flask 65K,Django 80K。一个文档型项目比绝大多数运行时框架都更受欢迎。
二、为什么是 vinta/awesome-python?
awesome-python 是 awesome-list 运动(GitHub 上「主题精华目录」这一类项目的总称)的开创者之一,仅次于 sindresorhus/awesome。它是 Python 开发者的事实标准参考——任何新手问「Python 该学哪个库」,高赞回答大概率是「去 awesome-python 看一眼」。
它的 Slogan 很直白:*"The definitive list that answers 'I want to do X in Python, which tool should I use?'"*(一份权威清单,回答「我想在 Python 里做 X,该用哪个工具?」)。这句 Slogan 解释了它成功的核心:它不创造工具,它做「工具的目录」。
2.1 它不做的事
它没有一行核心代码——README.md 是它的全部产品。仓库 99% 的内容是 Markdown 文本、链接和分类标签。它不写教程,不做评测,不提供安装命令。它只做一件事:把散落在 GitHub、PyPI、各类博客里的 Python 工具,按主题组织起来。
三、40+ 分类,本质是 Python 生态的「知识图谱」
awesome-python 的核心资产是它的分类体系——这不是普通的目录分类,而是对 Python 生态的结构化视图。理解这一点是看懂整个项目的关键。
3.1 六大主分类
| 主分类 | 包含的子分类(节选) |
|---|---|
| AI 与机器学习 | AI and Agents、Deep Learning、Machine Learning、NLP、Computer Vision、Recommender Systems |
| Web 开发 | Web Frameworks、Web APIs、Web Servers、WebSocket、Template Engines、Authentication、Admin Panels、CMS |
| 数据与科学 | Data Analysis、ETL、Data Validation、Data Visualization、Science、Quantum Computing |
| 开发者工具 | Algorithms & Design Patterns、Code Analysis、Testing、Debugging Tools、Build Tools |
| DevOps | DevOps Tools、Distributed Computing、Task Queues、Messaging、Job Schedulers、Logging |
| CLI / GUI / 文本媒体 | CLI Development、CLI Tools、GUI Development、Text Processing、HTML Manipulation |
看出端倪了吗?每个分类下收录的工具数量从十几个到上百个不等。一个 Python 开发者想「做爬虫」,打开 awesome-python 的 Networking 子分类,30 秒就能找到 5 个主流框架 + 各自的优劣短评。这就是它的产品体验:30 秒的检索时间 = 数小时的学习成本节省。
3.2 分类即架构
这 40+ 分类,本质上是 Python 生态的概念图谱。每个分类对应一个领域:领域内有什么工具、工具之间的关系是什么、新人该怎么进入这个领域——三个问题一次性回答。这不是「目录」,这是「架构文档」。
四、社区自举 + 零代码哲学
一个没有代码的项目,凭什么持续维护 12 年?答案藏在它的社区机制里。
4.1 PR 审核即质量控制
所有新增条目都通过 Pull Request(PR,一种合并代码修改的协作机制)提交,由维护者人工审核。审核标准很硬:
- 项目必须仍在活跃维护(近 6 个月有提交)
- 必须提供 README 且文档质量过关
- 必须有明确的 Python 使用场景
- 不能与已有条目重复
这套机制让 awesome-python 不只是一个静态清单,而是一个持续被社区筛选和更新的「共识目录」——任何低质量项目都会在 PR 阶段被卡掉,不会污染主分支。
4.2 零代码的最大化影响力
326K stars 完全靠文档和分类赢得认可。十年累计维护者不到 10 人,全职投入几乎为零。这印证了一个反直觉的事实:生态位的价值 > 实现细节。占据「共识入口」比写代码更有杠杆效应。
作为对比,很多技术更先进、设计更优雅的工具,可能只有几百颗星——因为它们没有进入 awesome-python的分类体系。
4.3 CC0 协议 + Sponsor 可持续
awesome-python 选择 CC0(Creative Commons Zero,意为「放弃所有版权」)许可证:所有内容进入公有领域,任何人都可以复制、修改、商用,无需授权。这意味着它不会被版权争议卡住传播路径。
与此同时,它在 README 顶部开放了 GitHub Sponsors(GitHub 官方赞助机制)位和品牌赞助位(当前赞助商是 iPulse AI),实现了零代码变现。开源项目常见的「维护者疲惫」问题被资金和品牌曝光同步缓解。
五、对 Agent 系统建设者的启示
如果你是 Agent 系统(能让 AI 自主执行任务的软件系统)建设者,正在搭建一套 Skill 体系(让 Agent 调用预置能力的机制),awesome-python 的设计有四个可借鉴之处。
5.1 分类体系可对应到 Agent Skills
| awesome-python 分类 | Agent Skills 对应 |
|---|---|
| AI and Agents | agent-.py / ai-.py(智能体调度类) |
| CLI Tools | shell / exec(本地命令执行) |
| Web APIs | http / browser(网络接口调用) |
| Data Analysis | data-research / query(数据检索) |
| Testing | testing SKILL(验证流程) |
| Code Analysis | academic-verify / concept-synthesis(学术与概念校验) |
5.2 五个值得抄的设计原则
- 分类即架构:建立 Skills 体系时,优先设计分类拓扑(决定「有哪些大类、大类下放什么」),而不是堆砌功能列表。好的分类 = 用户能自己找到答案。
- README 即产品:工具类项目投入文档质量 + 维护体验,回报高于投入代码行数。一份持续更新的文档比一份完美但冻结的代码更能留住用户。
- 生态位思维:在红海领域(竞争极度激烈的方向),高质量元数据(分类、描述、链接)比实现更重要——它决定你能否被检索到。
- 社区规范自举:建立贡献规范和审核机制,比写代码更能保障长期质量。一份清晰的 PR 指南 = 一支免费的审核队伍。
- Sponsor 可持续:开源项目通过 Sponsor 位实现零代码变现,降低维护者负担。资金和曝光同时到位,维护者才有动力持续投入。
六、结论:投资元数据比投资代码更有杠杆
vinta/awesome-python 不是一个技术项目,而是一个生态基础设施。326K stars 证明了:当一个项目能够成为某个领域的「共识入口」,它的价值将远超功能性项目。
对于 Agent 系统建设者,关键洞见只有一句话:投资元数据和分类体系,往往比投资底层代码更有杠杆效应。一个完美但无人知晓的工具,远不如一个「够用且人人可查」的工具。
对于所有「想被找到」的项目——开源工具、内部工作流、个人作品集——这一条都成立。共识入口 > 实现细节。