
一、Apache Maka是什么项目
apache/maka是 Apache 软件基金会 2026 年 8 月 13 日刚收进孵化器的、本地优先(local-first)的 AI Agent 工作台。
可能你会觉得 "Apache 孵化器"、"本地优先"、"工作台" 这几个词听着都不性感。但我看完它的核心架构之后,认为这是 2026 年 AI Agent 领域少见的底层范式突破——它做的不是给 Agent 加一个炫酷 UI,而是重写了 Agent 与"记忆"的关系。
接下来我用三段讲清楚:
- 它到底解决了什么问题(用 Claude Code 用户最痛的场景作为引子)
- 它用什么架构解决的(Event Sourcing + "Log is the Runtime")
- 这个范式对 OpenClaw、对所有 Agent 框架意味着什么(可借鉴的 4 个落地动作)
为什么说它是"基础设施型"
市场上多数 AI Agent 项目属于"应用层"——套壳大模型 + 一个垂直场景 UI(如 Cursor、Devin、v0)。Apache Maka 不在这个象限,它做的是"Agent 工作的执行底座"——与 LangChain、LlamaIndex、AutoGen 同一层级。
二、那个让所有 Agent 用户抓狂的问题
先讲一个真实场景。假设你用 Claude Code 改一个 1.5 万行的老仓库,让它重构一个工具函数:
1. 读取文件(10K token 进上下文)
2. 改了几行
3. 跑测试,挂了
4. 让它自己 debug
5. 又调了几次工具
6. 上下文压缩了
7. 它说:"我修复了 XX 函数"
8. 你打开文件一看 —— 改的不是你让它改的那个
它为什么不记得原始任务?因为 Claude Code 的"记忆"是有损压缩的上下文窗口。压缩一次,丢一点;再压缩,再丢。几次之后,模型记得"我在改文件",但不记得"用户最开始为什么要改"。
这是 2026 年所有 Agent 框架共同的根本问题:模型记忆 ≠ 工作台记忆。
一个 Agent 工作台真正应该承担的,不是"让模型记得更多",而是"让工作台替模型记住所有事"。模型忘了可以,工作台不能忘。
apache/maka 就是从这个命题开始重写整个架构的。
2.1 这个问题的三个表现
- 模型跑偏了(修了 X 但你让它修 Y)
- 模型重复劳动(明明已经查过的事实又查一遍)
- 模型甩锅("我不确定要做什么",实际是上下文被覆盖)
2.2 为什么传统架构解决不了
上下文窗口是模型的物理边界,物理边界不能通过加更多工具来突破。要么换更大的窗口(成本指数级上升),要么换一种"记忆"机制(这就是 Apache Maka 的方向)。
2.3 一句话
模型记忆 ≠ 工作台记忆。Agent 工作台的职责不是给模型"更多记忆",而是替模型"记住所有事"。
三、"Log is the Runtime" —— 不是 slogan,是范式
3.1 一句话定义
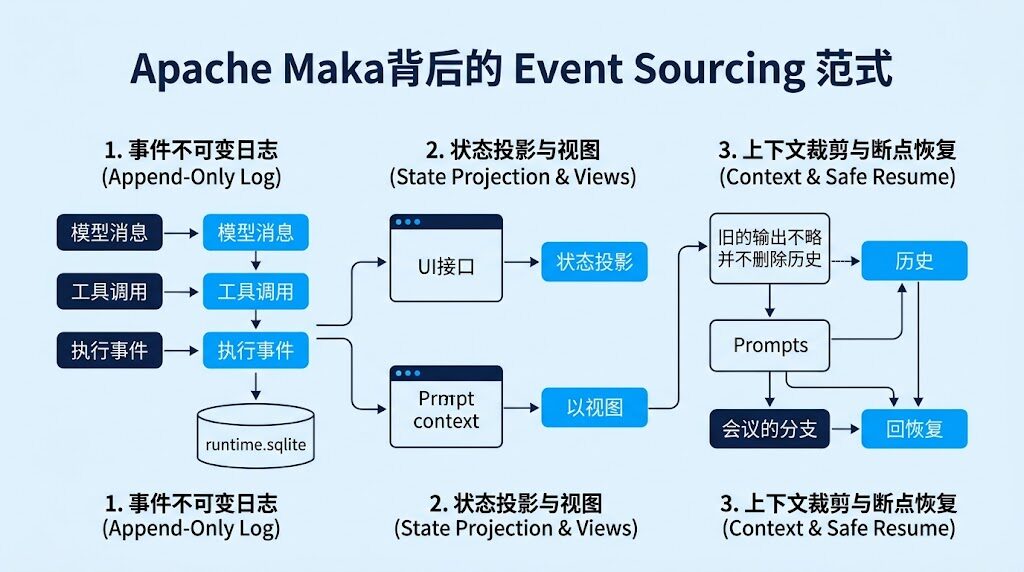
Apache Maka 把 AI Agent 的每一次执行(模型消息、工具调用、工具结果、权限决策、终止事件)全部写入 SQLite append-only 日志,不写聊天记录。
"Log is the Runtime" 直译:日志就是运行时。不是"日志记录运行时",是日志本身就是运行时。
3.2 翻译成大白话
普通的 Agent 框架:
- 运行时 = 模型 + 上下文窗口 + 工具
- 日志 = 用来事后查的副产物
- 模型"死了"(进程挂掉),上下文窗口就没了
Apache Maka:
- 运行时 = append-only SQLite 日志
- 上下文窗口 = 从日志投影出来给模型看的视图
- 模型"死了",重启后从日志重新投影上下文,每一次执行都有据可查
3.3 为什么这是范式突破
把 Event Sourcing(事件溯源)这套软件工程老炮儿用了 20 年的架构思想,第一次系统性地搬进 AI Agent 工作台。带来三个根本能力:
① 可恢复(Recoverable):Agent 进程崩了、重启、断网,原始执行事实不丢。从日志重建上下文。
② 可投影(Projectable):上下文压缩不再是"摘要覆盖原文",而是"换一种视图给模型"。原始日志永远在。
③ 可审计(Auditable):每一次工具调用、每一次权限决策都写在日志里。事后能精确回答"它为什么删了这个文件"。
3.4 真实场景对比
回到开头的"重构 1.5 万行老仓库":
| 框架 | 出错后能否复原 |
|---|---|
| Claude Code | ❌ 上下文压缩后,原始诉求被覆盖,模型开始"自由发挥" |
| OpenClaw | ⚠️ memory 模块会保留摘要,但摘要本身是有损的 |
| Apache Maka | ✅ 日志里完整记录"用户原始诉求 → 读取文件 → 修改第 X 行 → 报错 → debug → 终止"。可从任意节点重放或分支 |
四、架构拆解(不写代码,只画骨架)
4.1 四层架构
┌─────────────────────────────────────┐
│  入口层(Entry Points)              │
│  Desktop (Electron+React)           │
│  TUI (终端 UI)                       │
│  CLI (非交互)                        │
│  Eval (评测模块)                     │
└─────────────────────────────────────┘
              ↓
┌─────────────────────────────────────┐
│  权限引擎(Permission Engine)       │
│  细粒度工具级权限 + 决策审计         │
└─────────────────────────────────────┘
              ↓
┌─────────────────────────────────────┐
│  Runtime Event Log(核心)           │
│  SQLite append-only                 │
│  Event Sourcing                     │
└─────────────────────────────────────┘
              ↓
┌─────────────────────────────────────┐
│  模型适配层(Model Adapter)         │
│  云端 API · 本地模型 · 兼容 gateway  │
└─────────────────────────────────────┘
4.1.1 各层职责一句话
- 入口层:负责"人怎么用"——不同形态的 UI 与 CLI 适配
- 权限层:负责"什么能做什么不能做"——执行前的最后一道关口
- 日志层:负责"发生过什么"——整个系统的可信之源
- 模型层:负责"能不能做"——把任何 LLM 拉进来都能跑
4.1.2 四层数据流向
数据从入口层流入 → 经权限层过滤 → 写入日志层 → 必要时投影给模型层响应 → 决策回到入口层展示
4.2 关键技术点
Runtime Event Log
- SQLite append-only,每条事件不可变
- 存储 5 类事件:模型消息、工具调用、工具结果、权限决策、终止事件
- 重启后可搜索、可重试、可分支
Event Sourcing 上下文压缩
- 上下文 = 从日志生成给模型的投影(projection)
- 原始日志不被摘要覆盖
- 同一份日志可以投影出多种上下文(适合不同任务)
细粒度权限引擎
- 工具粒度(不是文件粒度)
- 每次调用记录决策结果到日志
- 可追溯"谁授权、为什么"
不绑定模型
- 支持云端 API、本地模型、任何 OpenAI 兼容 gateway
- 不锁定到任何厂商
4.2.1 5 类事件的优先级
工具调用 > 权限决策 > 工具结果 > 模型消息 > 终止事件。前两类是审计关键,后三类是执行轨迹。
4.2.2 为什么是 SQLite 而不是 Postgres/MySQL
单机部署为主、不依赖外部服务、append-only 写入极快(毫秒级)、单文件便于备份与迁移。这三点让它成为 local-first 项目的天然选择。
4.2.3 与 Git 内部对象存储的类比
Git 把每次提交的对象都存为不可变 blob,靠引用构建 DAG。Apache Maka 类似——每个事件是不可变记录,靠引用关系构建可重放历史。两者哲学相通。
4.3 与同类项目对比
| 项目 | 架构哲学 | 存储 | 权限模型 | 平台 |
|---|---|---|---|---|
| Apache Maka | Event Sourcing-first | SQLite append-only | 工具级+审计 | macOS/Windows |
| Claude Code | 上下文窗口优先 | 内存+文件系统 | 用户确认制 | 全平台 |
| OpenClaw | Skills+Gateway | 内存+memory | 策略引擎 | 全平台 |
| Browser Use | UI 自动化优先 | 无持久化 | 浏览器沙箱 | 全平台 |
关键差异:Apache Maka 解决了"上下文压缩后 AI 忘记为什么这么做"的根本问题。日志是 flight recorder(黑匣子),模型的记忆可以是有损的,因为工作台的记忆不是。
4.3.1 选择框架的决策树
- 需要审计 → Apache Maka
- 需要跨平台即用 → Claude Code / OpenClaw
- 需要 UI 自动化 → Browser Use
- 需要 Skills 生态 → OpenClaw
4.3.2 为什么 OpenClaw 不是 Event Sourcing-first
OpenClaw 的核心命题是"多 Agent 协作"而非"单 Agent 长会话审计"。多 Agent 协作的状态天然分布,不需要单一真相源。所以 OpenClaw 不该照搬 Apache Maka 架构,而是应该借鉴其"工作台独立记忆"的设计哲学。
4.3.3 未来融合的可能
如果 OpenClaw 增加"长任务工作台"模式,可以把 Apache Maka 的 SQLite append-only 日志作为底层存储,用 OpenClaw 的 Skills 系统做入口层、能力层——这是"基础设施 + 生态"两层合作的典型路径。
五、对 OpenClaw 的启示(4 个落地动作)
我在做的 OpenClaw 是一个多 Agent 协作平台,已经有 Skills 系统、memory 模块、cron 任务流。看到 Apache Maka 之后,我认为 OpenClaw 应该借鉴(但不是复制)以下 4 点:
5.1 短期(1-2 周)· 把 cron 执行的关键决策持久化
现状:cron 执行完只留摘要到 memory
5.1.1 改造方案
cron 执行过程中,每次关键 tool call、权限决策、终止原因,写入 memory/cron-events/YYYY-MM-DD.jsonl(append-only)
5.1.2 收益评估
Agent 出问题时能精确回放"这次 cron 为什么失败"
5.1.3 实施示例
JSONL 每行一条事件:{"ts":"2026-08-26T12:00:00Z","tool":"publish_to_wp","decision":"allow","reason":"标题未重复"}
5.2 中期(1 个月)· context-monitor 增加 event sourcing 维度
现状:context-monitor 检测"上下文使用率"
5.2.1 改造方案
增加"哪些上下文压缩是因为日志投影触发的"维度,让运维能区分"模型自然遗忘" vs "工作台主动投影"
5.2.2 收益评估
长会话压缩从"模糊的剪枝"变成"可解释的投影"
5.2.3 关键指标
- 投影触发的压缩占比 ≥ 30% 时考虑是否需要扩大上下文窗口
- 单一 Agent 任务的投影次数 ≤ 5 次为健康
5.3 中期(1-2 个月)· 工具调用细粒度审计
现状:hook 机制已有权限概念,但只在内存里
5.3.1 改造方案
把每次 hook 决策写到 append-only 日志(含时间、工具、参数、决策理由、是否被用户覆盖)
5.3.2 收益评估
openclaw 用户的 Agent 在生产环境跑了 3 个月后,能精确回答"它上周二为什么删了那个数据库表"
5.3.3 合规价值
满足 SOC2 / ISO 27001 对"AI 系统操作可审计"的硬性要求
5.4 长期(3 个月+)· 会话分支显式化
现状:cron 历史+重跑机制已有类似能力,但隐藏
5.4.1 改造方案
显式支持"从某次执行开启分支实验",UI 可见、可对比、可合并
5.4.2 收益评估
把 OpenClaw 从"能用的 Agent 平台"升级为"可实验的 Agent 平台"
5.4.3 应用场景
- 同一 Agent 任务的多个 prompt 实验对比
- 长流程的"如果当时做了不同选择"回溯
- 团队协作中的"建议修改方案"分支
六、批判性思考:Apache Maka 不是银弹
我不想写成软文,所以这节必须写。
6.1 Apache Incubating ≠ Apache 毕业
Apache Maka 2026-08-13 才进孵化器。Incubating 距离 Top-Level Project(毕业)通常需要 1-3 年。期间项目可能:
- 治理结构变化
- 核心 API 大改
- 社区分裂
我的建议:观察 3-6 个月,不要现在就把生产 Agent 押在它上面。
6.1.1 应对策略
在自己的 Agent 平台里抽象一层"日志后端"接口,把 SQLite 实现作为可替换组件。万一 Apache Maka 治理剧变,可平滑迁移到自研或他方案。
6.2 本地优先 ≠ 永远本地
"Local-first" 是 SaaS 疲劳的反弹,但 AI Agent 的未来不一定是纯本地:
- 大模型推理成本高,本地跑不动
- 多人协作需要云端同步
- 跨设备体验需要云端中继
Apache Maka 的架构(log 在本地)天然支持"本地为主 + 可选云同步"。但官方目前没有发布云同步方案,这是个潜在风险。
6.2.1 应对策略
如果选 Apache Maka 部署企业版,建议保留一个自建的"日志同步网关"占位,未来官方出云方案时无缝接入。
6.3 "Log is the Runtime" 的隐含成本
Append-only 日志 = 永不删除 = 存储膨胀。一个 1 万次工具调用的 Agent 任务,日志可能几百 MB。如果你不主动清理:
- 磁盘爆掉
- 备份成本飙升
- 隐私合规风险(GDPR 要求可删除)
Apache Maka 目前没有自动归档/压缩机制。
6.3.1 应对策略
写一个简单的 cron 把 30 天前的日志 gzip 后归档到冷存储,活跃查询只查近 30 天。这是工业界 Event Sourcing 通用做法。
6.4 安全设计的诚实表态
最后这点我觉得最值得尊重。Apache Maka 的 SECURITY.md 明确写了一句话:
"真正能挡住恶意 LLM 的边界只有操作系统账号;权限引擎、脱敏、URL 过滤这些只是进程内安全网,不等于 OS 级隔离。"
这种诚实的表态在 AI 项目里非常罕见。大多数 AI Agent 项目会给你"我们的沙箱很安全"的错觉。Apache Maka 直接说"我们做的只是降低风险,不能替代 OS 隔离"。这是技术成熟的标志。
6.4.1 给我们的启发
如果你在做一个 AI Agent 平台,README 里要不要也写一段"我们做的只是 X,不替代 Y"?诚实的边界声明 = 用户的信任。
七、给读者的三个 take-away
① 如果你是 Agent 用户:关注"工作台的记忆"是否独立于"模型的记忆"。如果两者是同一个东西(只是聊天记录),你的 Agent 早晚会被压缩搞坏。
② 如果你是 Agent 框架开发者:Event Sourcing 不是一个选项,是 Agent 工作台的基础设施级必备。不解决"工作台独立记忆"问题,所有花式 UI 都是治标不治本。
③ 如果你是创业者:apache/maka 单日 +543⭐、Apache 收进孵化器、TypeScript monorepo + Electron 桌面版 —— 说明 2026 年 AI Agent 的下一个战场是"基础设施"。Cursor / Claude Code / Devin 都在应用层卷,但真正缺的是一个跨厂商、跨模型、本地优先的执行底座。这是新项目机会。
7.1 给 Agent 用户的可操作清单
- [ ] 你的 Agent 工作台有没有独立日志?
- [ ] 出错后能否从日志恢复现场?
- [ ] 跨工具调用能否保留决策依据?
- [ ] 半年后能否回答"它上周做了什么"?
四个问题如果有 1 个答"否",你已经在 Apache Maka 想解决的问题里。
7.2 给 Agent 框架开发者的能力清单
- [ ] 执行事实持久化(append-only)
- [ ] 上下文投影机制(不是摘要覆盖)
- [ ] 工具级权限+审计
- [ ] 会话分支与重放
- [ ] 模型无关(不锁定厂商)
清单越完整,越接近 Apache Maka 的架构哲学。
7.3 给创业者的赛道判断
AI Agent 应用层(Cursor/Devin/Claude Code)已经被证明是大生意,但底层"执行底座"还是空白市场。Apache Maka 抢了先机,但它单平台限制 + 孵化期不稳定 = 给了后来者 12-18 个月窗口。
八、附录:相关链接
九、Apache Maka 技术指标速查表
最后把项目关键数据汇总成一个速查表,方便读者收藏查阅:
9.1 核心数据
| 指标 | 数值 |
|---|---|
| 项目名 | Apache Maka(Incubating) |
| GitHub | apache/maka |
| Stars | 3,429(2026-08-26) |
| 今日 Trending | +543⭐(AI 板块第 1) |
| Forks | 341 |
| 主语言 | TypeScript 93.3% |
| License | Apache-2.0 |
| 进入 Apache 孵化器 | 2026-08-13 |
9.2 平台支持
| 平台 | 状态 |
|---|---|
| macOS Apple Silicon | ✅ 正式版 |
| Windows | ⚠️ 预览版(未签名) |
| Linux | ❌ 未发布 |
| 移动端 | ❌ 未发布 |
9.3 运行时构成
| 组件 | 职责 |
|---|---|
| Runtime Event Log | SQLite append-only 事件日志 |
| Permission Engine | 工具级细粒度权限+决策审计 |
| Entry Points | Desktop/TUI/CLI/Eval 四入口 |
| Model Adapter | 云端 API + 本地模型 + 兼容 gateway |
9.4 适用与不适用场景
- ✅ 适合:长任务(工具调用 ≥ 100 次)、需要审计的金融/医疗场景、对数据主权敏感的本地化部署、企业内部 Agent 平台
- ❌ 不适合:纯聊天场景(杀鸡用牛刀)、移动端、跨设备强同步需求、单机磁盘受限场景
十、附录:相关链接
- GitHub: https://github.com/apache/maka
- Apache Incubator 页面: https://incubator.apache.org/projects/maka.html