
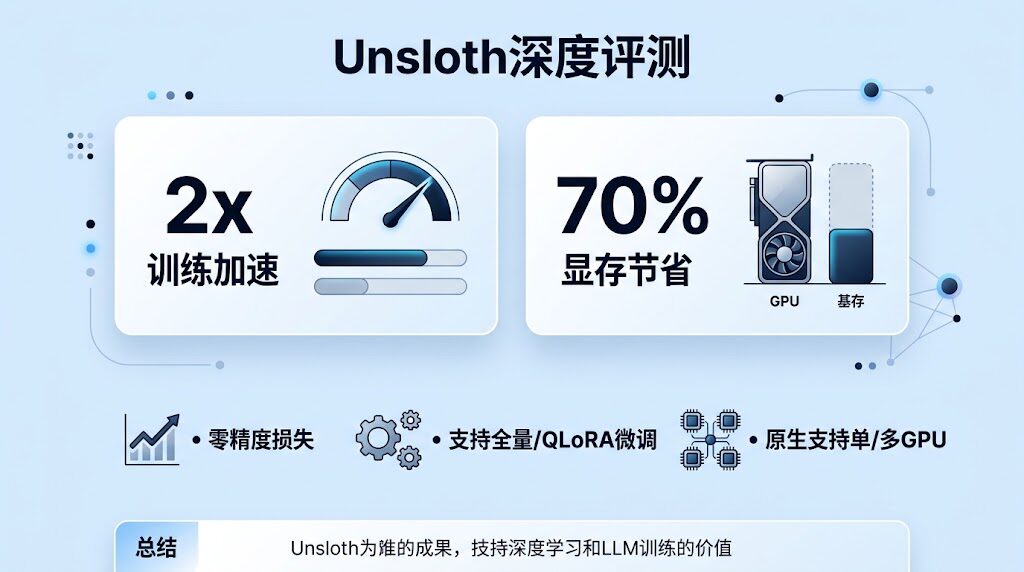
如果你是做内容运营、电商、研发的 AI 工具爱好者,最近一定有个新名字被反复提起——Unsloth(GitHub)。它把"本地训练大模型"的门槛砍掉了一大半:比 Hugging Face 快 2×、显存少用 70%、能跑在 Mac 上、还能直接接 Claude Code、Codex、MCP 做 Agent。
这篇文章基于官方仓库与文档,把 Unsloth 是什么、它解决什么痛点、和 Ollama 等同类工具差在哪、普通人怎么装 一次性讲清楚。
一、Unsloth 是什么
Unsloth 是一个本地化的 AI 工具集,覆盖 大语言模型(LLM)的推理 + 训练 + 微调,同时支持扩散模型(图像/视频生成)、Embedding、音频模型。
它的核心定位是:把"训练大模型"从只有大公司、数据科学家能做的事,变成任何一个有 Mac 或游戏本的开发者都能做的事。
官网:https://unsloth.ai GitHub:https://github.com/unslothai/unsloth 许可证:Apache 2.0(可商用)
二、它能干什么
| 功能 | 简介 |
|---|---|
| 模型运行 | 支持 Qwen3.8、Kimi K3、MiniMax-H3、Gemma 4、DeepSeek-V4、FLUX 等主流模型本地推理 |
| 模型训练 | LoRA、QLoRA、全量微调、预训练、RL(GRPO、DPO)、FP8 训练 |
| Agents 集成 | 内置 Claude Code、Codex、MCP 支持,可以把本地模型当 Agent 调用 |
| 私有 RAG | 内置无限网页搜索 + 深度研究 + RAG(用你自己的数据提问) |
| 多模态 | 图像、视频扩散模型本地运行与训练 |
| 远程访问 | 通过 Cloudflare 安全 HTTPS 远程访问本地模型 |
| 一键导出 | GGUF、NVFP4、FP8 等格式导出,OpenAI 兼容 API |
| 数据集构建 | 从 PDF、CSV、DOCX 等文件一键构造训练数据集(Data Recipes) |
三、三个最硬核的数字
Unsloth 的卖点可以浓缩为三组数字:
- 训练速度:比 Hugging Face 快 2×
- 显存占用:减少 70%(相比标准训练方案)
- 硬件覆盖:CPU、NVIDIA(CUDA)、AMD(ROCm)、Apple Silicon(MLX)、Intel GPU(Vulkan)、多 GPU 全覆盖
翻译一下:一块普通的 RTX 4090,能用 Unsloth 训练原本需要 A100 才能跑的模型;一台 M2/M3/M4 的 MacBook,也能跑得动 7B 级别的微调。这才是它真正让 AI 圈炸锅的原因——把过去必须租云 GPU 才能做的事情,搬到了笔记本上。
四、怎么安装
Unsloth 提供三种入口,按"上手难度"从低到高排:
4.1 桌面应用(最推荐的小白路径)
- Windows:下载 .exe
- macOS:下载 .dmg
- Linux:下载 .deb / AppImage / ARM64
装好之后双击图标就能用,完全不用碰命令行。
4.2 命令行安装(一行命令装好)
Linux/macOS:
curl -fsSL https://unsloth.ai/install.sh | shWindows PowerShell:
irm https://unsloth.ai/install.ps1 | iex4.3 Unsloth Studio(自带 Web UI)
curl -fsSL https://unsloth.ai/install.sh | sh
unsloth studio -p 8888
装好后在浏览器访问 http://localhost:8888 就能看到 Jupyter 风格的 Web 界面,适合喜欢可视化但又想留点命令行灵活性的开发者。
4.4 Unsloth Core(写代码用)
curl -LsSf https://astral.sh/uv/install.sh | sh
uv venv unsloth_env --python 3.13
source unsloth_env/bin/activate
uv pip install unsloth --torch-backend=auto
--torch-backend=auto 会自动识别你的硬件选 PyTorch 后端(CUDA / ROCm / MLX / CPU),这点对 Mac 用户特别友好。
4.5 Docker 部署(团队/服务器用)
docker run -d -e JUPYTER_PASSWORD="mypassword" \
  -p 8888:8888 -p 8000:8000 -p 2222:22 \
  -v $(pwd)/work:/workspace/work \
  --gpus all \
  unsloth/unsloth
把 8888(Web UI)、8000(API)、2222(SSH)三个端口映射出来,挂上数据卷,基本上就是一个本地版"AI 训练平台"了。
4.6 一个加分项:连接 OpenClaw
unsloth start openclaw这条命令会让 Unsloth 接入 OpenClaw(一个开源 AI Agent 平台),让本地训练好的模型被外部 Agent 直接调用。这是 Unsloth 区别于普通"本地推理工具"的关键差异点之一。
五、Unsloth vs Ollama vs llama.cpp:差在哪
很多读者第一次听到 Unsloth 都会问:"它和 Ollama 是什么关系?"
答案是:它们不是竞争关系,是分工关系。
| 工具 | 定位 | 优势 | 劣势 |
|---|---|---|---|
| Unsloth | 训练 + 推理 | 2× 快训练、70% 省 VRAM、多硬件、Agents 集成 | 训练优先,推理生态比 Ollama 窄 |
| Ollama | 推理 | 生态丰富、API 简单、模型库大 | 训练能力弱,无 Agents 集成 |
| llama.cpp | 推理 | 量化做得好、CPU 友好 | 无训练能力 |
| text-generation-webui | Web UI | 功能全、支持微调 | 体积大、配置复杂 |
简单记忆:
- 你想 跑一个本地大模型聊天 → 用 Ollama
- 你想 自己微调一个专属模型 → 用 Unsloth
- 你想 在手机上跑小模型 → 用 llama.cpp
- 你想 可视化调参 → 用 text-generation-webui
如果你正在做 电商客服 / 行业垂直领域模型,Unsloth 的训练能力是关键——Ollama 跑得再快,也只能给你"通用模型"。
六、怎么部署?要不要现在用?
结论:暂不推荐在生产环境部署 Unsloth 托管服务,但值得持续关注。
三个理由:
- 多数业务用不到训练能力——如果你只是要"本地问答",Ollama + 已有模型足够。训练是奢侈品,不是日用品。
- 训练流程还未完全稳定——
unsloth start openclaw是新功能,Agent 连接稳定性还需要观察。 - 算力门槛仍然存在——7B 模型训练要 24G 显存,70B 模型基本只能云端跑。
但有 3 个值得现在就研究的点:
unsloth start openclaw的 Agent 连接模式——这种"本地模型被 Agent 调用"的协议,可能成为未来 AI Agent 平台的标准接口- Data Recipes(PDF/CSV/DOCX → 训练数据集)——思路可以借鉴到知识库文档清洗流程
- VRAM 节省技术——梯度累积 + 量化协同的优化思路,对任何"大模型本地化"的项目都有参考价值
七、值得收藏的 3 个链接
- GitHub 仓库:https://github.com/unslothai/unsloth(Star 持续上涨,建议 watch)
- 官方文档站:https://unsloth.ai(安装脚本和模型支持清单都在这)
- Unsloth Hugging Face 组织:https://huggingface.co/unsloth(预训练好的 GGUF / 4-bit 模型可以直接下载)
结语
Unsloth 不是 Ollama 的替代品,它把"训练大模型"从云端搬到桌面的尝试,是 2026 年本地 AI 工具里最值得关注的方向。
如果你只是普通用户,先把 Ollama 跑通就好;如果你已经在做 行业垂直模型 / Agent 工作流 / 私有知识库 + 微调,那 Unsloth 的 2× 训练速度 + 70% 显存节省,会直接改变你的算力账本。
—
本文示例基于 Unsloth 官方文档(2026-08)与 GitHub 仓库核对,可作为本地 AI 工具选型参考。