
让 AI 接管桌面的难点,从来不是"点得准不准",而是"点完到底成没成"。
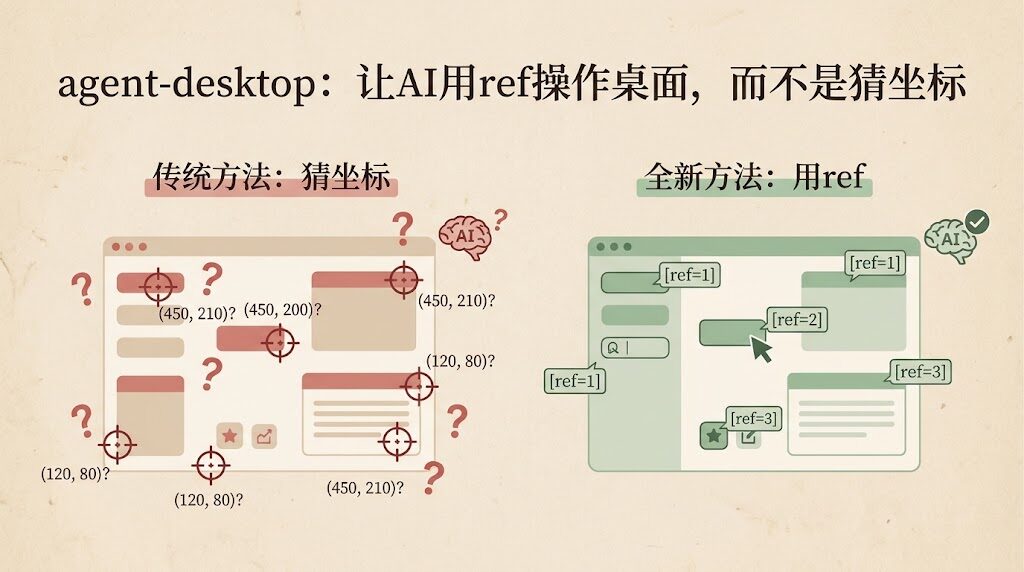
过去两年里,让 AI 操作图形界面的主流做法是"截屏给模型看"——把屏幕截图塞进模型,让它判断该点哪里、再输出一个坐标。这条路能用,但有三个绕不开的坑:界面稍微动一下,坐标就废了;模型看图会看错;而最要命的是,动作发出去了没有回执,Agent 只能猜。猜对了叫运气,猜错了就是"看起来做完了、其实没做"。
Vercel Labs 刚开源的 vercel-labs/agent-desktop,给出的是另一条路:不看像素,改用操作系统自己的无障碍(accessibility)树,把界面上每个可交互元素变成一个带编号的"目标",让 Agent 直接对这个编号下令;命令返回的不是一张图,而是一份机器读得懂的 JSON,里面明确写着这次动作到底有没有生效、能不能重试。
如果你正想让 AI 去操作某个桌面软件——填表、点菜单、读状态、批量处理后台——这篇文章值得读完再动手。
一、它到底在解决什么问题
1.1 桌面自动化的真正瓶颈
大多数人第一次接触 computer use(让AI操作电脑)时,注意力会落在"识别"上:模型能不能看懂这个按钮是什么。真正让工程团队栽跟头的却是"确认"——动作发出去之后,怎么知道它落地了?
一个典型的翻车场景是这样的:Agent 要给订单改价,它发出改价指令,命令超时了。这时候界面上的价格可能已经改了,也可能压根没改到。传统做法里,Agent 往往会把这当成"失败了",于是重试一次。结果就是改价执行了两次。如果那是一次扣款、一次发货、一次提交审批,重复执行的后果远不止数字错一位。
agent-desktop 的做法是把这件事写进协议里:命令的结果不只是"成功/失败",还有一个 disposition(处置)字段,明确区分这次动作处于哪个状态、是否允许自动重试。
1.2 什么时候你会用上它
- 想让 AI 去点一个必须靠视觉定位的桌面软件,而该软件没有 API、也没有自动化接口
- 已经在用截图 + 坐标的老办法,但经常遇到界面一变坐标就失效
- 需要在自己写的程序里嵌入桌面操作能力(它同时提供 CLI 和 C 库)
- 关心"AI 到底有没有真的把事做成",需要一份可核对的执行回执
1.3 什么时候你用不上它
先泼一盆冷水,免得期待错位:
- 它不是通用 RPA。它不替你判断业务语义,"把商品价格改成 99 元"这件事怎么找入口、填哪个字段,仍然要人(或你自己的规则)来定义
- 它不擅长看图类任务。识别一张图片里画的是什么、图上写了什么文字,不在它的能力范围内——它的强项是"操作结构化的界面元素"
- 它不绕权限。macOS 上必须手动授予辅助功能权限,Windows 上受终端完整性级别限制,Linux 上需要图形会话
- 它面向的是"能拿到无障碍树的常规桌面应用"。某些自绘界面、游戏、远程桌面里的画布,可能压根不暴露无障碍信息
二、项目档案:先看清它是什么
2.1 关键数据
| 项目 | 数据 |
|---|---|
| 星标 | 9,844 |
| Forks | 662 |
| 未关闭 issue / 未合并 PR | 48 / 75(合计 123) |
| 主要语言 | Rust |
| 许可证 | Apache-2.0 |
| 建仓时间 | 2026-02-19 |
| 最近推送 | 2026-11-03 |
| 最新版本 | v1.0.2(2026-10-30 发布) |
| 贡献者 | 9 位 |
(数据取自 2026-11-03 09:43 CST 直连 GitHub REST API;当日 GitHub 日榜归档快照显示它排在第一位,单日新增 2,275 星。)
2.2 形态:一个 CLI 加一个 C 库
它同时交付两种用法:
- CLI:命令行工具,每个命令输出一份 JSON 信封,适合脚本和 Agent 直接调用
- C 库:每个版本都附带 libagent_desktop_ffi(macOS / Linux / Windows 都有),让你的程序在进程内直接调用,不必为每条命令启一次子进程
配套还内置了一套"技能"文档(skills),按平台分层:主技能一份,macOS / Windows / Linux 各一份平台差异说明,FFI 一份讲内存与线程规则,另有一个可选的 jev-desktop 助手。整个仓库一共有 8 份 SKILL.md,其中 6 份在 skills 目录下。
2.3 出品方与安装
README 顶部挂的是 Vercel Labs Product 徽章,属于 Vercel 官方实验性产品线,不是个人玩具。安装走 npm:
npm install -g agent-desktop
agent-desktop version
Bun、Yarn、pnpm 装同一个包即可,内含 x64 与 ARM64 的原生二进制。不想用 npm,也可以从 GitHub Releases 直接下对应平台的原生压缩包,把配套 helper 放在可执行文件旁边。
官方 Homebrew 与 Scoop 包正在提交中,尚未进入默认源,仓库也不再维护自建的 tap 或 bucket——所以现在最省事的就是 npm。
2.4 权限是上手前最该确认的一件事
| 平台 | 需要什么 |
|---|---|
| macOS | 辅助功能权限,用 agent-desktop permissions –guide 走一遍授权引导 |
| Windows | 与终端处于同一完整性级别的应用无需额外授权 |
| Linux | 用户的图形会话,并安装 at-spi2-core |
Linux 还要额外留意 Wayland 与 X11 的差异:剪贴板在 Wayland 下需要 wl-clipboard;鼠标类操作在 Linux 上需要 X11 并加 –headed。
三、核心机制:快照、按 ref 动作、再快照
3.1 完整循环长什么样
作者把这个循环概括成一句 "Observe, act on a ref, observe again",官方 README 给的示例是:
agent-desktop snapshot --app Finder -i      # 交互元素,每个带一个 ref
agent-desktop click @s8f3k2p9:e8            # 对这个 ref 下动作
agent-desktop snapshot --app Finder -i      # 再看一次,验证结果
第一次快照给界面上每个 Agent 能操作的元素分配一个形如 @s8f3k2p9:e8 的 ref;Agent 对 ref 发动作;然后重新快照确认结果。关键在于 ref 绑定的是那次快照,不是坐标。
3.2 ref 不是坐标,这是它和截图法的分水岭
因为 ref 绑定快照,所以坐标失效那类老问题在这里不存在。相应地,它用另外两个错误码来表达"世界变了":
| 错误码 | 含义 | 该怎么办 |
|---|---|---|
| STALE_REF | 这个 ref 在当前界面里已经对不上任何元素了 | 重新快照,用新的 ref 再来 |
| AMBIGUOUS_TARGET | 有好几个元素都匹配这个 ref 的身份 | 换用窗口内唯一的控件 |
值得注意的是,裸 ref 是会被拒绝的——必须带快照 id 前缀,不能只写 @e8。原因很直白:没有快照 id,就没法判断这个 ref 属于哪一次快照,也就无法确认它还新不新鲜。
3.3 稠密界面怎么下钻
有些界面元素太多,一次性塞进上下文既贵又容易看花。它给了一个两段式的下钻办法:
agent-desktop snapshot --skeleton --app Slack -i --compact
agent-desktop snapshot --root @s8f3k2p9:e3 -i --compact
第一段先出浅层结构,被剪掉的分支带上 children_count 告诉你"下面还藏了多少";第二段用 –root 只钻进某一个区域,避免把整棵无障碍树倒进模型上下文。–skeleton 会把深度钳到 3 层,而 –max-depth 默认是 10,更深的结构就靠 –root 逐层下去。
3.4 默认无头,而且是刻意的
这是最容易被误解的一点:ref 动作默认 headless。
所谓无头,不是"没有界面",而是不碰你的指针、不抢你的焦点。它走的是系统提供的语义化无障碍接口,而不是模拟鼠标移动。副作用是:你的光标不会被拽走,你正在写的文档不会被切走焦点,你另一块屏幕上的事不会被打断。
需要物理输入的动作(hover、drag、mouse-move、mouse-click、mouse-wheel、press)才需要全局加 –headed。而且它明确禁止"先用无头、失败了再开有头硬来"——raw 坐标(–xy)也永远不会帮你聚焦窗口。
3.5 四个命令暂时不可用
命令表里一共 60 个命令名、56 个能真正跑。剩下四个是 key-down、key-up、mouse-down、mouse-up——它们被保留但拒绝执行,因为按住不放的键或鼠标键需要一个常驻守护进程来负责释放。它们返回 ACTION_NOT_SUPPORTED(headless 下的 mouse-down / mouse-up 会先返回 POLICY_DENIED)。
四、JSON 信封契约:每个命令的输出格式
4.1 成功与失败都是同一个信封
所有命令都返回同一层结构:version、ok、command,然后要么是 data,要么是 error。成功的信封长这样:
{
  "version": "2.6",
  "ok": true,
  "command": "click",
  "data": {
    "action": "click",
    "disposition": { "delivery": "delivered_unverified", "retry": "unsafe" }
  }
}
失败的信封则带上机器可读的 code、给人看的 message,以及一个可枚举的恢复策略:
{
  "version": "2.6",
  "ok": false,
  "command": "click",
  "error": {
    "code": "STALE_REF",
    "message": "@s8f3k2p9:e7 not found in current RefMap",
    "suggestion": "Re-run a snapshot to obtain fresh refs, then retry with the new ref",
    "recovery": {
      "strategy": "refresh_snapshot_then_retry_original",
      "retryable": true,
      "requires_fresh_snapshot": true
    },
    "disposition": {
      "delivery": "not_delivered",
      "retry": "safe"
    }
  }
}
error.code、error.message、error.disposition 永远存在;suggestion、recovery、platform_detail、details 为空时直接省略。这里有个细节很值得注意:recovery 只在 disposition.retry 等于 safe 的时候才出现——也就是说,工具不会给你一条"建议"却不说这条建议安不安全。
4.2 disposition:本文最值钱的一块
disposition 有两个正交的维度。
delivery 这一维一共五个取值:
| delivery | 含义 |
|---|---|
| unknown | 命令没能就"投递结果"建立任何事实 |
| not_delivered | 适配器观察到操作没有被投递 |
| delivery_uncertain | 投递结果无法确定 |
| delivered_unverified | 投递完成了,但没能读回验证 |
| delivered_verified | 投递完成,且读回验证通过 |
retry 这一维有三个取值:unknown、safe、unsafe。它由 delivery 推出——只有 not_delivered 是 safe,其余非 unknown 的值一律 unsafe。
unknown 这档最值得单独理解。它说的是"这条命令关于投递结果什么也没证明"。一个可能已经落地的变更如果超时了(TIMEOUT),它仍然是 unknown。于是就得出了一条相当硬的规则:不确定投递 ≠ 可以重试。
4.3 为什么"重试"要这么较真
因为把不确定当成功,是自动化事故里最常见也最贵的一种。
设想 Agent 要给一条记录打标,它发出写请求,命令超时。界面状态没变——它据此认定"没写进去",于是又发一次。结果标签被写了两次。这跟开头那个"改价执行两次"是同一类事故,只是主角从金额换成了记录。
agent-desktop 把这条规则写成了协议字段而不是文档建议:只有能证明没发生,才允许自动重试;证明不了就升级给人看。
4.4 状态型动作的读回验证
从 2.4 版本开始,一批会改变状态的动作——set-value、type、clear、check、uncheck、toggle、expand、collapse——在一次投递之后如果观察到后置状态矛盾,就直接拒绝,不会自己再试一遍。
更值得注意的是读回失败时的处理:读不到证据,本身仍算一次成功的 delivered_unverified 结果,并带上 details.verification_scope 为 unavailable。它不冒充 verified。
官方文档在这里写得很直白:delivered_unverified 既不证明元素状态,也不证明应用层真的持久化了。换句话说,"读回确认"这条纪律被拆成了两层——元素级确认和应用级确认不是一回事。
4.5 macOS 上那条容易被忽略的纪律
还有一条针对 macOS 的规则:无法证明"未投递"的变更错误必须终止 fallback 链。状态没变,或者读不到状态,都不等于变更没发生。
这直接对应到它自己的实现:涉及激活、选中、展开、滚动和窗口操作的变更错误,一旦不能证明未投递,就带着 unsafe 的重试处置停下,而不是换一条路接着试。
五、版本演进里藏着的四次语义修正
| 版本 | 变更 | 方向 |
|---|---|---|
| 2.0 | 错误里带 retry_command 字符串 | 靠散文表达恢复动作 |
| 2.1 | retry_command 换成结构化 recovery,新增 disposition | 从"建议"升级为"可判定" |
| 2.2 | 预算耗尽不再报 TIMEOUT,改成 ok:true 加 complete:false 加 truncated 加 nodes_observed,被剪节点带 subtree_truncated | 从"失败"改为"部分成功" |
| 2.4 | 状态型动作投递后读回验证,矛盾即拒绝,读不到只降级为 delivered_unverified | 从"投递了算成功"升级为"读回确认才算成功" |
5.1 2.1 这一步最关键
2.0 的 retry_command 是一句人话,Agent 得自己理解这句话、决定要不要照做。2.1 把它换成了结构化对象,并且明确说明被移除的 retry_command 字段没有任何兼容别名——不留旧字段、不做双写、不打兼容层。
这条"协议升级就显式作废旧字段"的纪律,比新增能力本身更值得抄:旧字段和旧规则并存时,一份文档里哪段是当前有效的,就成了调用方要去猜的事。
5.2 2.2 把"预算不够"从错误改成了成功
以前,Agent 的观察预算耗尽会得到一个 TIMEOUT 错误——意味着这次什么都没拿到。2.2 之后,预算耗尽返回的是 ok 为 true 的部分结果:complete 为 false 表示树不完整,truncated 为 true 表示被截断,nodes_observed 告诉你实际看到了多少节点,每个被截断的子树还单独带 subtree_truncated 标记,让你能从根一路走到每个边界。
调用方必须读 data.complete 来判断这棵树是否完整。TIMEOUT 不再表示"树太大了"。
六、技能分层与文档随二进制走
6.1 六个技能各管一段
仓库自带一整套技能资产:
- skills/agent-desktop/ —— 主技能,SKILL.md 的 frontmatter 里带 name、tags、requirements、description,还有一份触发词清单
- skills/agent-desktop-macos/、skills/agent-desktop-windows/、skills/agent-desktop-linux/ —— 三个平台各自的差异说明各自成篇,不塞进主技能
- skills/agent-desktop-ffi/ —— C 库入口、内存所有权、线程规则
- skills/jev-desktop/ —— 可选助手,把一整段屏幕描述交给指定的模型供应商,与原生 CLI 相互独立
6.2 文档由二进制按版本吐出
这是它一个很聪明的设计:文档不放在仓库里让你自己去对版本,而是由你手上这个二进制吐出来。
agent-desktop skills get desktop      # 观察-动作-验证循环、ref 规则、重试规则
agent-desktop skills get platform     # 当前操作系统上的能力差异
agent-desktop skills get ffi          # FFI 入口、内存所有权、线程规则
agent-desktop <command> --help        # 单个命令的完整参数
这样就杜绝了"文档写的是 v2、装的是 v2.6″这类版本漂移——你读到的规则,就是你这个二进制实际执行的那套。
6.3 装进你自己的 Agent
两条路:
npx skills add https://github.com/vercel-labs/agent-desktop --skill agent-desktop或者在自己的 AGENTS.md 里贴一段使用说明,让 Agent 先读 skills get desktop 和 skills get platform 再动手。
仓库里还配了 AGENTS.md(工程规则)、CONTRIBUTING.md(门禁)、SECURITY.md、CONCEPTS.md(ref、snapshot、session 的词汇表),以及 docs/solutions/ 下 15 篇历次 bug 与教训的记录。
七、FFI:把它嵌进你自己的程序
7.1 为什么需要 C 库
每个版本都附带 libagent_desktop_ffi(macOS、Linux、Windows 都有),这样你的程序可以在进程内直接调用,不用为每条命令起一次 CLI 进程。对于放在主链路上的自动化,这省掉的开销和延迟是实打实的。
7.2 ABI 门禁:版本不匹配在调用点直接失败
调用方加载库之后要先做一次 ABI 握手:
ad_init(AD_ABI_VERSION_MAJOR) // 校验头文件与动态库是否一致头文件里的 AD_ABI_VERSION_MAJOR 与库不一致时,返回的不是"能跑但行为可能不对",而是 AD_RESULT_ERR_INVALID_ARGS——直接中止。可以用 ad_abi_version() 读出库的 major 号做展示。
主版本号只在两种情况下递增:移除了某个符号,或者改了内存布局。新增的 ad_* 符号和错误码则是向后兼容的追加。官方明确建议:固定链接到确切的 libagent_desktop_ffi 版本。
这种"不匹配就当场失败,而不是行为漂移"的设计,比运行时才暴露诡异问题要安全得多。
7.3 内存与线程
字符串由 ad_free_string 释放;handle 要用 ad_free_handle 在同一个 adapter、同一个线程上释放,且必须早于 ad_adapter_destroy;action result 用 ad_free_action_result,display list 用 ad_display_list_free。
线程方面,失败的调用会设置线程局部的 last-error 状态,用专门的接口读取。另一个硬性约束是:回调不得跨 C ABI 展开——C++ 异常和 Rust panic 都必须在边界内被捕获。官方文档特别提醒,release-ffi 保留 panic = "unwind",因为 panic trap 需要它。
八、隐私边界写在最显眼的地方
README 第 16 行,也就是首屏,就写着这么一段:
快照、剪贴板读取、截图、命令输出和调试产物都可能包含私人桌面内容,不要放进公开日志或上传。
可选的 JEV 助手会把屏幕描述发送给配置好的模型供应商,这一点也单独说明了——它是与原生 CLI 分离的旁路。docs/faq.md 里还有专门一节讲这个。
值得肯定的是,它没有把隐私说明藏在文档末尾。凡是涉及读屏幕、读剪贴板、读本地凭据的工具,这种说明就该出现在第一屏而不是附录里。
九、放到电商后台这类真实场景里看
桌面自动化听起来离电商很远,其实后台管理系统恰恰是它的典型用武之地——大量后台没有 API,或者 API 覆盖不到那些边角操作。
9.1 几个具体能落地的场景
批量改价与库存同步。 运营后台的批量操作页,字段多、层级深。用 ref 逐个定位比坐标点击稳定得多,因为后台列表每次刷新,元素位置都会挪位,而 ref 是在每次快照里重新解析的。
跨系统的数据核对。 把 ERP 的导出表格和店铺后台的列表逐行比对,需要读页面上的文字再填进另一个系统。这正是"观察-动作-验证"循环的用法:读一次、填一次、再读一次确认。
异常单据处理。 售后工单、平台处罚通知这类需要人工判断的界面。Agent 负责把信息填好、把证据截下来,判断这一步留给人。
客服后台的批量回复。 注意这里有边界:发出去的消息撤不回来,所以读回验证在这里尤其重要。
9.2 收益与成本要算清楚
收益是明确的——省掉的是重复的界面点击,不用写脆弱的坐标脚本,元素位置变了不用重写。
成本也明确:每个平台都要先解决权限(macOS 上尤其);无头模式下拿不到视觉信息(图标按钮得靠无障碍标签识别);遇到没有无障碍树的界面就得换方案;最后,Agent 判断错了业务语义的时候,这套工具只会更高效地把错误执行下去。它提高的是执行可靠性,不提高判断正确性。
9.3 和其它方案的对比
| 方案 | 定位 | 适合什么 | 主要短板 |
|---|---|---|---|
| agent-desktop | 系统无障碍树 + ref 语义定位 | 常规桌面应用的结构化操作 | 不读图;不提供业务语义 |
| 截图 + 视觉模型 | 让模型看截图给坐标 | 界面无无障碍信息;需要理解视觉内容 | 坐标易失效;不保证执行结果 |
| 浏览器自动化框架 | 专供网页 | 网页后台 | 覆盖不了非浏览器应用 |
| 传统 RPA | 录制回放固定流程 | 流程极度稳定、变更极少 | 界面一改就断,维护成本高 |
一个务实的组合思路是:能用浏览器自动化解决的走浏览器自动化,需要动非浏览器桌面软件的,再考虑 agent-desktop 这一类。两者并不互斥。
十、这套设计里有几个想法值得带走
10.1 把"不确定"变成一个一等公民
大多数工具协议里,结果只有成功和失败两种。而"可能做成了、但没法确认"其实是自动化里最常见的状态。这个项目把它单列成一档(delivery_uncertain / delivered_unverified),并且规定它不能被当成可以自动重试的依据。
任何要驱动外部动作的系统,都值得把这条纳入自己的设计:能证明没发生,才允许自动重试;证明不了就升级给上层决策。
10.2 预算不够时返回"部分成功 + 完整度标记"
观察预算耗尽时,返回一份带 complete、truncated、nodes_observed 甚至逐节点 subtree_truncated 的部分结果,而不是把整个任务判死,也不是悄悄截断后当成完整结果交付。
这两种错误都很常见:一种让可观测的系统直接不可用;另一种更危险——上层以为拿到了全部数据。
10.3 协议升级要显式作废旧字段
2.1 把 retry_command 换成结构化 recovery,并且明确"不保留任何兼容别名"。新旧两版语义并存,看似友好,实际是让每个调用方都要自己去猜哪段规则还有效。
10.4 文档跟着二进制走
技能文档由二进制自己吐出来(skills get desktop / platform / ffi),版本永远对得上。文档和实现分两个地方维护,就一定会漂移。
10.5 工具就是工具,循环留给 Agent
它的 SKILL.md 开宗明义:"It is a tool, not an agent."——观察、动作、验证这个循环跑在你的 Agent 侧,工具只负责确定性的执行。
这跟"技能是规则层、执行在 agent 运行时"的定位是一致的。技能文档里如果写上"我要自己再规划一遍",越界就发生了。
10.6 权限和数据出域必须写在首屏
辅助功能权限怎么给、哪些数据可能含私人内容、旁路 helper 会把屏幕描述发给谁——三件事全放在 README 顶部和 FAQ 专节,而不是埋进附录。
十一、上手前的最后几件事
11.1 最小验证路径
npm install -g agent-desktop
agent-desktop version
agent-desktop permissions --guide
agent-desktop list-apps
agent-desktop snapshot --app Finder -i
先确认权限到位、能看到应用列表、能拿到快照,再谈自动化。
11.2 建议的推进顺序
先用只读命令摸清楚目标应用的元素结构(snapshot、find、get、is),把界面摸熟;再从低风险动作开始(focus、select 这类不改变数据的);确认读回验证正常之后,再上写入类动作(set-value、type、toggle);最后才考虑批量和组合动作。
每一步都检查 disposition 里的 delivery 和 retry 值是否如你预期——这既是调试手段,也是在验证你的 Agent 是不是真的在按规则决策。
11.3 需要盯的几个版本变化
2.5 版本对一批会派发指针、拖拽、剪贴板、应用关闭和窗口操作的命令做了破坏性载荷变更。2.6 版本则改了 ref 的解析规则:在 Windows 和 Linux 上,以及 macOS 上无法定位地址的元素,ref 只有在"抓取时一次完整读取证明过唯一、且当前恰好有一个活元素匹配"时才解析。
这意味着升级后旧的 ref 会失效——这是符合预期的,升级后重新快照即可。固定版本号链接的 FFI 用户尤其要注意。
十二、小结
agent-desktop 最值得注意的地方,不是它又提供了一个桌面自动化工具,而是它把"这次动作到底成没成"这个问题写进了协议本身,并且给出了一个相当严格的答案:能证明没发生才允许自动重试,证明不了就停下来交给你。
它现在仍是个新项目(v1.0.2,建仓不到一年),接口还在演进,Linux 和 Wayland 的部分能力比 macOS 弱一些,Homebrew 和 Scoop 的官方包也还没进默认源。把它当作一个设计参考,也许比直接用在生产链路上更划算。
不管用不用得上,那几条协议层的纪律——不确定投递不可自动重试、部分成功要带完整度标记、旧字段显式作废、文档随二进制走——几乎可以原样搬进任何驱动外部动作的系统里。