
一、先说结论:DBeaver 凭什么值得每个数据库学习者安装?
一句话:DBeaver 是一款基于 Java 的免费开源「通用数据库管理工具」,支持几乎所有主流关系型数据库,对学习者极其友好。
它能解决学习过程中的几个核心痛点:
- 一工具连多库:MySQL、PostgreSQL、SQL Server、Oracle、SQLite……同一个客户端搞定,不用为每个数据库装一个 GUI。
- SQL 编辑器够专业:自动补全、语法高亮、格式化、执行计划可视化、查询历史,比手写
.sql文件再跑脚本高效得多。 - 可视化看数据、看结构:数据编辑器支持筛选、排序、批量编辑;ER 图一键生成表关系,复杂 schema 也能一眼看懂。
- 免费且跨平台:Apache License 协议,Windows / macOS / Linux 全平台可用,无功能阉割。
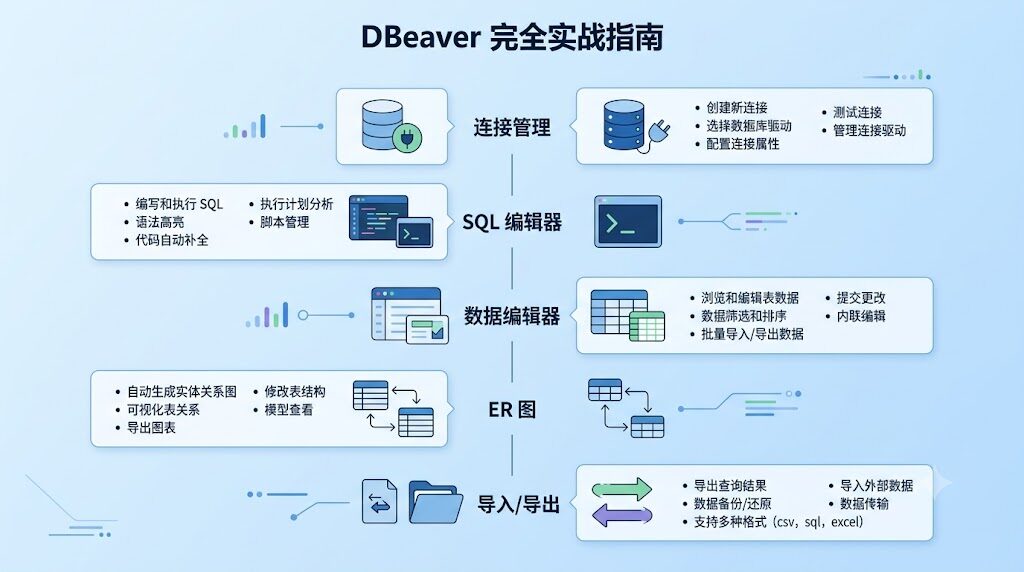
本文将带你从安装到上手,重点讲清五个模块:连接管理、SQL 编辑器、数据编辑器、ER 图、导入导出。读完后你应该就能用 DBeaver 替代 80% 的命令行操作。
二、DBeavor 全景速览
2.1 三个版本怎么选
| 版本 | 授权 | 适合人群 |
|---|---|---|
| DBeaver Community | 免费、开源(Apache) | 自学者、学生、个人项目 |
| DBeaver PRO | 商业授权 | 团队协作、需要 NoSQL/云数据库/AI 辅助 |
| DBeaver Lite | 商业授权 | 仅 ODBC/JDBC 轻量场景 |
2.2 支持的数据库(节选)
- 关系型:MySQL、PostgreSQL、MariaDB、SQL Server、Oracle、IBM Db2、Greenplum、ClickHouse、SQLite
- 云数据库(PRO):AWS Redshift、Google BigQuery、Snowflake、Azure Cosmos DB
- NoSQL(PRO):MongoDB、Redis、Cassandra、Couchbase
- 图数据库:Neo4j
三、安装:5 分钟搞定
3.1 系统要求
- Java 21+:自 23.0 起官方安装包已自带 OpenJDK 21,无需额外配置
- 操作系统:Windows 10+、macOS 11+、主流 Linux 发行版
3.2 三种安装方式(以主流平台为例)
| 平台 | 推荐方式 | 命令 |
|---|---|---|
| Windows | EXE 安装包 | 双击运行,自动升级 |
| Windows | Chocolatey | choco install dbeaver |
| macOS | Homebrew | brew install --cask dbeaver-community |
| Linux | DEB / RPM | sudo dpkg -i dbeaver.deb |
| Linux | Snap | snap install dbeaver-ce |
升级版本时,不要删旧版的配置。DBeaver 的所有设置保存在用户目录下的 DBeaverData 文件夹中,与安装目录解耦——只要这个文件夹还在,重装任何版本都能恢复书签、连接、SQL 脚本。
四、核心功能模块详解
4.1 创建第一个数据库连接
入口有三个,任选其一:
- 工具栏点击 New Connection Wizard 按钮
- 菜单 Database → New Database Connection
- 快捷键 Ctrl+Shift+N
向导流程(以 PostgreSQL 为例):
- 选择驱动(搜索框直接输入
postgres过滤) - 填写主连接参数:
| 项 | 示例值 |
|---|---|
| Host | localhost |
| Port | 5432 |
| Database | postgres |
| Username | postgres |
| Password | **** |
- 点击 Test Connection 验证
- Finish,连接出现在左侧 Database Navigator
高级配置(按需开启):
- SSH Tunnel:连远程数据库时安全通道,常用于生产环境
- SSL Configuration:数据库本身要求 SSL 时开启
- Security:可设置连接为「只读」「禁止 DDL」「禁止导入」,避免误删数据
小技巧:连接右键 → SQL Editor 可以直接对该库新建脚本,比通过工具栏少一步。
4.2 SQL 编辑器:你的主力战场
F3 新建脚本 / Ctrl+Enter 打开最近脚本,是最高频操作。
核心能力清单:
| 项 | 示例值 |
|---|---|
| Host | localhost |
| Port | 5432 |
| Database | postgres |
| Username | postgres |
| Password | **** |
- 按住
Ctrl悬停表名/视图名,会变成超链接,点击直接打开对象编辑器——比记忆 schema 名称快得多。 - 使用「变量绑定」:在 SQL 中写
${var_name},右下角 Variables 面板给变量赋值,适合同一脚本查不同条件。
执行计划可视化(学习查询优化的重头戏):
Ctrl+Shift+E 后,下方面板会以树形结构展示执行计划,每行包含:
- 节点类型(Seq Scan / Index Scan / Hash Join 等)
- 成本估算(cost)
- 实际行数(rows)
- 是否使用了索引
顺序阅读执行计划,从内向外、从下往上——最底层节点先执行。这是新手理解「为什么这条 SQL 慢」的入门方法。
4.3 数据编辑器:所见即所得的操作面板
打开方式:
- 方式 A:左侧导航器双击表 → 顶部 Data 选项卡
- 方式 B:SQL 编辑器跑一条
SELECT *→ 结果直接在 Results 选项卡
左侧六种视图(按数据特征切换):
| 能力 | 快捷键 / 入口 | 说明 |
|---|---|---|
| 执行当前语句 | Alt+X | 仅运行光标所在 SQL |
| 执行全部脚本 | Ctrl+Enter | 全脚本顺序执行 |
| 格式化 | Ctrl+Shift+F | 美化长 SQL,可读性 |
| 代码补全 | 自动触发 | 边敲边出表名、列名 |
| 执行计划 | Ctrl+Shift+E | EXPLAIN 可视化,调优必用 |
| 查询历史 | Ctrl+Enter | 调出 Recent SQL Script 窗口 |
| 切换激活库 | Ctrl+9 | 一个窗口查多个库 |
| 切换 schema | Ctrl+0 | 不丢失已有 SQL |
| Link with editor | Ctrl+Shift+, | 导航器与编辑器联动 |
| Outline 大纲 | Alt+Shift+Q, O | 长脚本函数跳转 |
| 多结果同标签 | 右键 → Layout → Show multiple results in one tab | 对比查询结果 |
- 双击单元格进入内联编辑,
Enter确认 - 编辑过的单元格右上角会出现 黄色三角,提示未保存
- Ctrl+S 一次性提交所有修改;反悔用 Ctrl+R 拒绝更改
⚠️ 重要提醒:底部状态栏会显示表是否有主键(
PRIMARY KEY标志)。没有主键的表无法编辑——这是 DBeaver 为数据安全做的硬约束。如果表确实没主键,不要手工改,请联系 DBA 加主键后再操作。
筛选与排序:
- 列头点击下拉箭头 → Filter:设置筛选条件
- 列右键 → Order:升序/降序
- 默认走服务端执行(数据量大时省内存),如需客户端处理可取消勾选 Server-side results ordering
实用快捷键:
| 视图 | 适用 |
|---|---|
| Grid | 通用表格 |
| Text | 大段文本 |
| Spatial | GIS 地理数据 |
| Chart | 一眼看出分布 |
| Record | 按 Tab 切换,列转行 |
| JSON / XML | 半结构化数据(PRO) |
两种打开姿势:
- 双击表 → Diagram 选项卡:单表关联图
- 双击 schema 或 Tables 节点:整库关系图
特别有用的功能:
- Edit Mode:编辑模式下可拖拽创建外键,生成的 SQL 会出现在预览窗口——写迁移脚本时神器
- Custom Diagrams:把跨库、跨连接的表放到同一张图里,微服务项目特别好用
- 导出:PNG / BMP 用于文档,
SVG(PRO)用于汇报
自定义样式:菜单 Window → Preferences → Editors → Diagram Editor,可切换 ER 符号(Crow's Foot / IDEF1X / Bachman),不同符号对应不同教材体系,按需选。
4.5 数据导入与导出
导入向导(CSV / JSON / SQL 文件入库):
- Database Navigator 右键目标表 → Import Data
- 选择数据源(CSV 最常用)
- 映射列、预览前 100 行
- 配置加载策略(追加 / 替换 / 更新)
- 确认并执行
导出向导:
- 右键结果集 → Export Data
- 支持 CSV、JSON、XML、SQL 脚本、HTML、Excel 等
- 适合做数据备份、跨库迁移、报表分发
结构对比与迁移:
- Compare/Merge(菜单 Database → Compare):对比两个数据库的 schema,生成迁移 SQL
- Liquibase changelog(PRO):直接输出 changelog 文件,纳入版本控制
4.6 模拟数据生成(PRO / Enterprise 版)
学习阶段你可能不需要,但作为了解:
- 右键表 → Tools → Generate Mock Data
- 配置:行数、批量大小、每列生成器(随机数、UUID、正则、姓名、邮箱等)
- 自动遵循 PK、FK、Unique 约束
对学习者的价值:测试性能时需要百万级测试数据,用这个比手写 INSERT 快几个数量级。
五、高效快捷键速查表
只列最高频的 15 个,先背这组:
| 操作 | 快捷键 |
|---|---|
| 新增行 | Alt+Insert |
| 复制上方行 | Ctrl+D |
| 删除行 | Alt+Delete |
| 应用修改 | Ctrl+S |
| 拒绝修改 | Ctrl+R |
| 按外键跳转 | Alt+Space |
六、给数据库学习者的实战建议
6.1 学习场景对应工具用法
| 快捷键 | 功能 |
|---|---|
| Ctrl+Shift+N | 新建连接 |
| F3 | 新建 SQL 脚本 |
| Ctrl+Enter | 执行 SQL / 调出最近脚本 |
| Alt+X | 仅执行当前语句 |
| Ctrl+Shift+F | 格式化 SQL |
| Ctrl+Shift+E | 查看执行计划 |
| Ctrl+9 | 切换连接 |
| Ctrl+0 | 切换 schema |
| Ctrl+Shift+, | Link with editor(导航器联动) |
| Alt+Insert | 新增数据行 |
| Ctrl+S | 保存数据修改 |
| Ctrl+R | 拒绝数据修改 |
| Ctrl+D | 复制上一行数据 |
| F7 | 切换结果面板 |
| F1 | 打开帮助文档 |
- 每个连接设置
Security = Read Only:练习库 / 生产库必备,防止误操作 - SQL 脚本放进 Project Explorer 的
Scripts文件夹:SQL 编辑器写的脚本会自动归档,方便后续复查 - 善用 Outline 视图:超过 100 行的存储过程 / 长脚本必备
6.3 常见误区提醒
- ❌ 远程生产环境先在本地用 Community 版测试 SQL,再用 PRO 的只读模式复核
- ❌ 没有主键的表不建议直接在 DBeaver 里编辑——先 ALTER TABLE 加主键
- ❌ 大数据集筛选优先走服务端(默认行为),客户端排序会爆内存
七、总结
DBeaver 不是一个「炫技」工具,而是一个把数据库日常工作流打磨到极致的实用工具。它的学习成本接近于零,但回报是把 SQL 学习、数据调试、迁移脚本编写这些事全部效率化。
对于数据库学习者,我的建议路径是:
- 第一个小时:装好 DBeaver,连上你正在学习的库,跑几条 SELECT
- 第一周:把 SQL 编辑器快捷键和执行计划用熟
- 第一个月:开始用 ER 图理解陌生 schema,用 Compare 写迁移脚本
工具的边界不在功能列表,而在它进入你工作流的方式。希望这篇指南能帮你跨过那道门槛。
官方文档、下载与社区资源可在 DBeaver 官网与 GitHub 仓库获取。