
如果你正用 Claude Code、Cursor 或者 OpenCode 写代码,你大概率会遇到三个糟心时刻:
- 第一,Agent 在大改动集上"挑着审",重要文件被悄悄漏掉;
- 第二,它给你的反馈行号和真实代码位置对不上;
- 第三,每次跑审查都要烧掉大量 token,结果质量还跟 prompt 写法强相关。
今天介绍的项目 alibaba/open-code-review(29,112 ⭐ · Go · Apache-2.0)就是为解决这三个痛点而生的——它在阿里内部跑了两年、服务数万名开发者、发现数百万代码缺陷后正式开源。
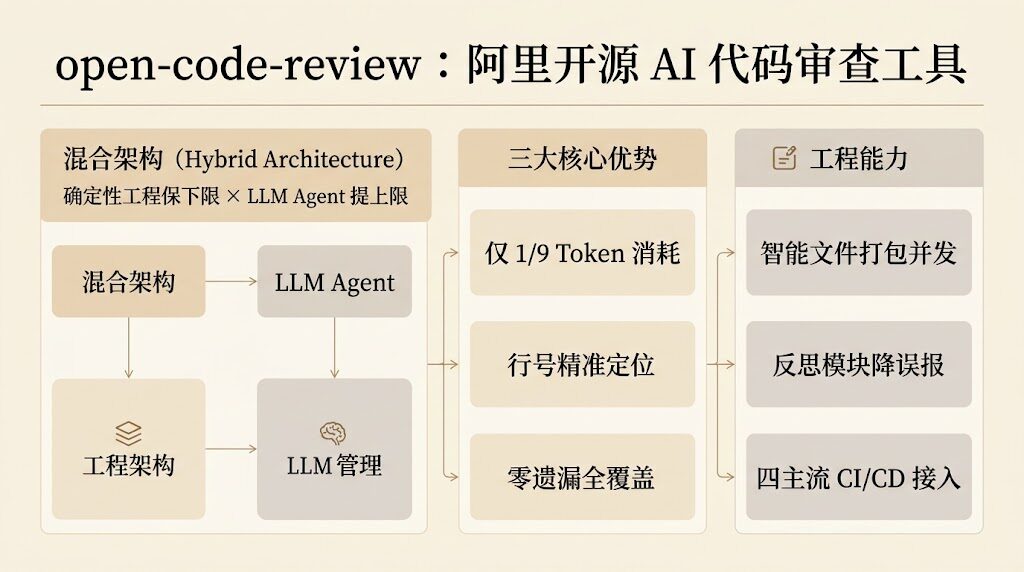
一、阿里 2 年打磨的 AI 代码审查工具
- 它不是又一个 AI 代码助手,而是 Hybrid Architecture(混合架构)代码审查——用确定性工程做"必须做对"的步骤,用 LLM Agent 做"需要动态判断"的步骤;
- 基准数据说话:同等模型下比 Claude Code 节省 1/9 token,精确度更高、F1 更优(基于 50 个开源仓库 + 200 个真实 PR + 80+ 工程师交叉验证);
- 落地门槛低:CLI 一行命令接入,CI/CD 已支持 GitHub Actions / GitLab CI / GitFlic CI / Gerrit 四种主流平台;
- 生态友好:内置 MCP Server,与 Claude Code / Codex / Cursor / OpenCode 等编码 Agent 都有官方插件;
- 对工程团队有借鉴价值:Hybrid 分工思路、文件打包并发、token 效率优化方法论,对所有多 Agent 系统都通用。
二、读这篇你能带走什么
- 一种叫 "Hybrid Architecture" 的代码审查设计思路——确定性工程 × LLM Agent 分工;
- 一份 AACR-Bench 基准数据,证明它比 Claude Code 节省 1/9 token 但精确度更高;
- 一组马上能上手的 CLI 命令和 CI/CD 集成方式;
- 一份完整的"如何把 LLM 嵌入到生产级工程实践"的参考样本;
- 对 OpenClaw 这类多 Agent 体系的直接借鉴清单(5 条);
- 代码审查场景下三个常见工程问题的解法(行号精准 / 大仓库覆盖 / 规则匹配稳定性)。
三、什么时候你用不上它
OpenCodeReview 不是万能解药。以下场景你可能用不上它:
- 代码量小、改动集永远在 10 个文件以内——直接用 IDE 自带的 AI 补全更划算;
- 只想要"我提交了,AI 帮我补全注释"的轻量体验——OpenCodeReview 的设计目标是严谨审查,不是自动补全;
- 团队完全没人在乎代码审查的精确度——OpenCodeReview 的取舍是"宁可漏报,不要误报",如果你的团队对误报零容忍,可能需要重新校准 prompt;
- 你所在的团队只接受完全开源的 AI 模型——OpenCodeReview 本身开源,但它需要调用 LLM,
ocr config provider时需要选择模型来源(OpenAI、Anthropic、自托管等)。
四、项目概述与核心定位
OpenCodeReview 是阿里巴巴内部 AI 代码审查工具的开源版本,官网:https://open-codereview.ai。GitHub Topics:agent, code-review, code-review-assistant, harness, repository-level-context。创建时间:2026-05-18,最近 push:2026-09-16(活跃维护)。
核心定位:Hybrid Architecture 代码审查——确定性工程(文件选择 / 规则匹配 / 位置定位 / 反思模块)与 LLM Agent 混合,取各自所长。它的核心理念可以浓缩成一句话:确定性工程负责"保下限",Agent 负责"提上限"。两者各自做自己擅长的事,工程化到极致。
五、Hybrid Architecture:确定性工程 × LLM Agent 分工
整个系统被拆成两大块:确定性工程模块(保证结果可复现)+ Agent 模块(做动态判断)。两者的边界是事先约定好的:能用工程逻辑解决的,绝不丢给 LLM;只有需要"理解语义"的环节才走 Agent。
5.1 为什么通用 Agent 在代码审查场景不够用
5.1.1 痛点一:覆盖不全
大改动集上 Agent 倾向"抄近路",漏审文件。在一次 200 个文件 diff 的 PR 上,通用 Agent 经常只审了前 50 个,后面的 150 个直接跳过——开发者以为被审过了,实际有大量遗漏。
5.1.2 痛点二:位置漂移
报告的问题行号与实际代码位置偏差。比如 Agent 说"第 137 行的 SQL 有注入风险",但实际代码第 137 行是无关的 import 语句——开发者要花时间回查,审查的可信度直接降低。
5.1.3 痛点三:质量不稳
纯语言驱动 Skill 难以调试,输出质量随 prompt 波动。同一个 PR,今天审和明天审的结果差异巨大——这对"审查"这种需要稳定性的工作流来说不可接受。
5.2 确定性工程模块(5 个)
| 模块 | 职责 |
|---|---|
| 文件选择(File Selection) | 精确决定哪些文件需要审查、哪些过滤,保证重要改动不遗漏 |
| 智能文件打包(Smart Bundling) | 把相关文件打包为一个审查单元(如 message_en.properties + message_zh.properties),每个 bundle 独立子 Agent 运行,支持并发 |
| 细粒度规则匹配(Fine-grained Rule Matching) | 按文件特征匹配审查规则,减少 LLM 注意力噪声,模板引擎比纯 Prompt 规则匹配更稳定 |
| 外部定位模块(External Positioning) | 独立 comment-positioning 模块,保证反馈行号精准 |
| 反思模块(Reflection Module) | 独立 comment-reflection 模块,提高 AI 反馈内容准确性 |
5.2.1 模块的共同特点
这五个模块有一个共同特点:它们不依赖 LLM 的"理解能力",而是用纯工程逻辑实现。比如"文件选择"模块会跑 git diff、按路径规则做归类、按文件大小做截断;"反思模块"会把 LLM 第一次的输出 + 代码上下文重新送回 LLM 做二次校验,但提示词模板是固定的。
5.2.2 与传统 Linter 的区别
看起来这五个模块像传统 Linter(ESLint、Checkstyle 这类),但有一个关键区别:传统 Linter 用静态规则匹配,OpenCodeReview 的模块会动态调用 LLM 做最终判断,只是在调用前做了大量"预处理"。这是混合架构的精髓。
5.3 Agent 模块(2 个)
| 模块 | 职责 |
|---|---|
| 场景化 Prompt 模板 | 深度优化的代码审查专用 prompt,提高效能同时降低 token 消耗 |
| 场景化工具集(Scenario-tuned Toolset) | 从大规模生产数据中提炼的 tool-call 分布优化,比通用 Agent 工具集更稳定可预测 |
5.3.1 场景化 Prompt 模板
Agent 部分只做两件事:把"已经过滤好的代码片段 + 已经匹配好的规则"喂给 LLM,让它生成自然语言反馈。Prompt 是预制的、工具集是预制的,所以 LLM 的"自由度"被刻意收窄——这是 token 节省的核心来源。
5.3.2 场景化工具集
从大规模生产数据中提炼的 tool-call 分布优化。比如通用 Agent 工具集里有 50 个工具,OpenCodeReview 场景化后只剩 12 个——这 12 个工具的组合在历史数据里覆盖了 95% 的代码审查场景。
5.4 性能基准 AACR-Bench
OpenCodeReview 团队公开了一份基于 50 个热门开源仓库、200 个真实 PR、10 种编程语言的基准,80+ 高级工程师交叉验证(1,505 个标注 ground-truth 问题):
同等模型下,OpenCodeReview 比 Claude Code 精确度高、F1 更优,token 消耗仅 1/9,审查速度更快。代价是 Recall 略低——有意为之,Precision 优先于噪声。
5.4.1 基准含义解读
这个基准的含义很直接:作者团队的取舍是宁可漏报,不要误报。对生产环境的代码审查来说,这通常是对的——误报会让开发者对审查结果失去信任,漏报可以通过多重审查机制补上。
5.4.2 1/9 token 的实际成本影响
以 Claude Sonnet 为例,单次 PR 审查从约 0.45 美元降到约 0.05 美元——一个 100 人的工程团队每月做 1000 次 PR 审查,月度成本从 450 美元降到 50 美元。对成本敏感的中小团队特别友好。
六、马上能上手的功能亮点
OpenCodeReview 把所有能力都封装成 CLI 命令 + 配置文件 + 插件,开发者可以在 5 分钟内接入。
6.1 CLI 用法
# 安装
npm install -g @alibaba-group/open-code-review

# 配置 LLM provider 和模型
ocr config provider
ocr config model

# 审查当前工作区的所有改动
ocr review

# 审查分支差异
ocr review --from main --to feature-branch

# 审查单个提交
ocr review --commit abc123

# 完整文件扫描(不依赖 git diff)
ocr scan --path internal/agent

# 委托模式(让编码 Agent 自己调用审查)
ocr delegate preview
ocr delegate rule src/main.go src/handler.go

# 输出 JSON(AI host agents 推荐)
ocr review --format json --output result.json
6.1.1 安装与配置
这套 CLI 设计有几个细节值得注意:
ocr config把 LLM provider 配置单独抽出来,意味着你可以接 OpenAI、Anthropic、自托管模型,不绑定到任何一家云厂商;ocr delegate是给"编码 Agent 反过来调用审查"留的口子——Claude Code、Cursor、OpenCode 这些工具可以自己 spawn 审查任务;--format json输出意味着审查结果可以被其他系统消费(CI 流水线、PR bot、内部仪表盘)。
6.1.2 常用命令分类
按使用频率排序:
ocr review:日常开发高频使用(PR 提交前自查);ocr review --from main --to feature:CI 自动调用场景;ocr scan --path <dir>:历史代码审计、技术债盘点;ocr review --format json:被其他 AI Agent 或仪表盘消费;ocr delegate:多 Agent 编排场景。
6.2 MCP Server
内置 MCP(Model Context Protocol)Server,外部工具可以注册进来扩展审查能力。对已经在用 MCP 生态的团队来说,这意味着可以无缝接入已有的工具链。
6.3 CI/CD 集成
官方支持 GitHub Actions、GitLab CI、GitFlic CI、Gerrit 四种主流 CI 系统。基本模式是:在 PR 触发时跑 ocr review --format json,把 JSON 结果转成 PR 评论或检查状态。
6.4 Session Viewer
浏览器端可以浏览/回放审查会话,标注"已修复"/"已忽略"。这个功能对代码审查的团队协作很关键——审查不是一次性的,开发者要能追溯"这个建议当时是怎么提的、为什么我选择忽略"。
6.5 Telemetry
OpenTelemetry 集成,可以接入现有的可观测性体系(Jaeger、Datadog、Honeycomb 等)。对需要做 SLA 监控的企业团队友好。
6.6 输出格式与会话存储
OpenCodeReview 支持 JSON 文本输出和结构化会话存储两种模式。前者适合 CI 流水线消费,后者适合团队复盘和审查历史追溯。两者可以同时启用,互不冲突。
七、多 Agent 集成:与主流编码工具无缝协作
OpenCodeReview 内置了与主流编码 Agent 的集成插件,覆盖 Claude Code、Codex、Cursor、OpenCode、QCA Forward 以及通用 Agent Skill:
# Claude Code 插件
ocr plugin install claude-code

# Codex Skill
ocr plugin install codex

# Cursor Skill
ocr plugin install cursor
7.1 集成模式
这个设计的实际意义是:你不需要切换工具。开发者继续在 Claude Code / Cursor 里写代码,审查这个环节被外挂进来。对已经在用某款 IDE 的团队来说,迁移成本接近零。
7.2 适用场景
- 团队已经在用 Claude Code / Codex / Cursor 写代码;
- 想加一道"自动审查"环节但不想切换工具;
- 多 Agent 编排场景(让编码 Agent 反过来调用审查);
- 需要 MCP 协议作为"通用胶水"的复杂工具链。
八、可借鉴之处:对工程团队和 AI 工具链都有参考价值
这一节重点回答两个问题:① 如果你正在设计一个多 Agent 系统,OpenCodeReview 的哪些设计可以直接复用?② 如果你正在做代码审查 Agent,有哪些工程问题可以从它身上找到答案?
8.1 对多 Agent 体系的直接参考(5 条)
- Hybrid Architecture 设计:确定性工程 × LLM Agent 分工——把"必须做对"的步骤(幂等性、路由分发、状态机)用确定性逻辑,把"需要动态判断"的步骤交给 LLM。这条经验对所有多 Agent 系统都适用。
- 文件打包并行策略:
ocr scan的 bundle-subagent 并发机制值得参考——处理大改动集时,用分治策略避免 context 溢出。 - Token 效率优化:基准测试证明专用 prompt 模板比通用 Agent 节省约 89% token——"场景化"思路精细化调优是直接可复用的方法论。
- MCP Server 集成:OpenCodeReview 的 MCP Server 设计与 OpenClaw 的 MCP 工具链高度契合,可以研究其工具调用分布做优化。
- CI/CD 无缝集成:审查结果 JSON 输出 + CI pipeline 自动消费的模式,可以复用到其他 AI 工作流的自动化闭环。
8.2 对代码审查 Agent 的工程启示
三个常见工程问题的解法:
- 行号精准问题:用外部 positioning + reflection 模块双重保证,比让 LLM 自己输出行号更可靠;
- 大仓库覆盖问题:文件打包 + 子 Agent 并发,避免 context 溢出;
- 规则匹配稳定性:模板引擎 + 确定性规则匹配,比纯 Prompt 规则更可预测。
8.3 对电商 / 中型研发团队的适用性思考
如果你所在的团队正在做电商系统、内容平台、SaaS 产品,OpenCodeReview 的几个特性可能对你特别有用:
8.3.1 规则模板引擎的复用
电商系统里有大量重复模式(订单状态机、库存扣减、价格计算),用模板规则做静态校验比让 LLM 每次"理解"更高效——既省 token 又稳定。
8.3.2 JSON 输出 + CI 卡门
把审查结果接入你的 CI 系统,PR 不通过自动评论,可以在团队规模扩大的同时维持代码质量底线。
8.3.3 多 Agent 插件
你的开发团队如果已经在用 Cursor 或 Claude Code,几乎零迁移成本就能加上审查环节。
九、总结
| 维度 | 评估 |
|---|---|
| 架构创新 | ★★★★★ — Hybrid deterministic × agent 是代码审查场景的正确范式 |
| 实战验证 | ★★★★★ — 阿里内部两年、数万开发者、数百万缺陷识别 |
| Token 效率 | ★★★★★ — 1/9 token 消耗,显著优于通用 Agent |
| 多 Agent 生态 | ★★★★☆ — 覆盖主流编码 Agent,MCP 扩展性好 |
| 可借鉴程度 | ★★★★★ — 对多 Agent 技能体系、幂等性设计、多步骤任务编排均有直接参考价值 |
9.1 一句话评价
代码审查的正确做法不是"让通用 Agent 看 diff",而是"确定性工程保下限 + 专用 Agent 提上限"。OpenCodeReview 把这个理念工程化到了极致。
9.2 给你的行动建议
- 如果你的团队每天处理 50+ 文件的 PR diff,建议先用
ocr review --format json在一个仓库试跑一周,对比人工审查的漏报率; - 如果你的团队已经在用 Claude Code / Cursor,优先装官方插件(
ocr plugin install claude-code),不要切换工具; - 如果你的 CI 已经在跑,可以把
ocr review接到 GitHub Actions 的 PR 触发器,审查结果转 PR 评论; - 如果你正在设计自己的多 Agent 系统,重点参考"确定性工程 × LLM Agent 分工"的边界划分思路——这是 token 效率和审查质量的根因;
- 不要在没评估 Recall/Precision 取舍前就上生产——OpenCodeReview 的设计是 Precision 优先,如果你的业务对漏报零容忍,需要重新校准 prompt 或加上多重审查机制。
9.3 资源链接
- GitHub 仓库:https://github.com/alibaba/open-code-review
- 官网:https://open-codereview.ai
- 基准 AACR-Bench:仓库 README 中有详细说明
- CI/CD 集成模板:GitHub Actions / GitLab CI / GitFlic CI / Gerrit 各自的官方示例