
如果你经常刷 GitHub Trending,应该知道一个项目从默默无闻到登顶榜首通常需要几年时间。但 firecrawl/firecrawl 这个名字,最近悄悄爬到了 131,219 颗 Star,成为 GitHub 上 AI 相关领域最受欢迎的开源工具之一。今天的 Trending 榜上,它和 freeCodeCamp、Linux、n8n、Claude Code 等老牌项目并列在前十,而前面只有一个 AI 项目(Claude Code,131,633 Star)。
更值得注意的是它的「干净」——131K Star 背后没有花哨的营销,没有明星创始人光环,只有一个朴素的价值主张:把任意网页变成 AI 看得懂的数据。今天这篇分析,我们来扒一扒它到底解决了什么问题,凭什么这么火,以及和我们普通创业者、运营人有什么关系。
Firecrawl 到底是什么
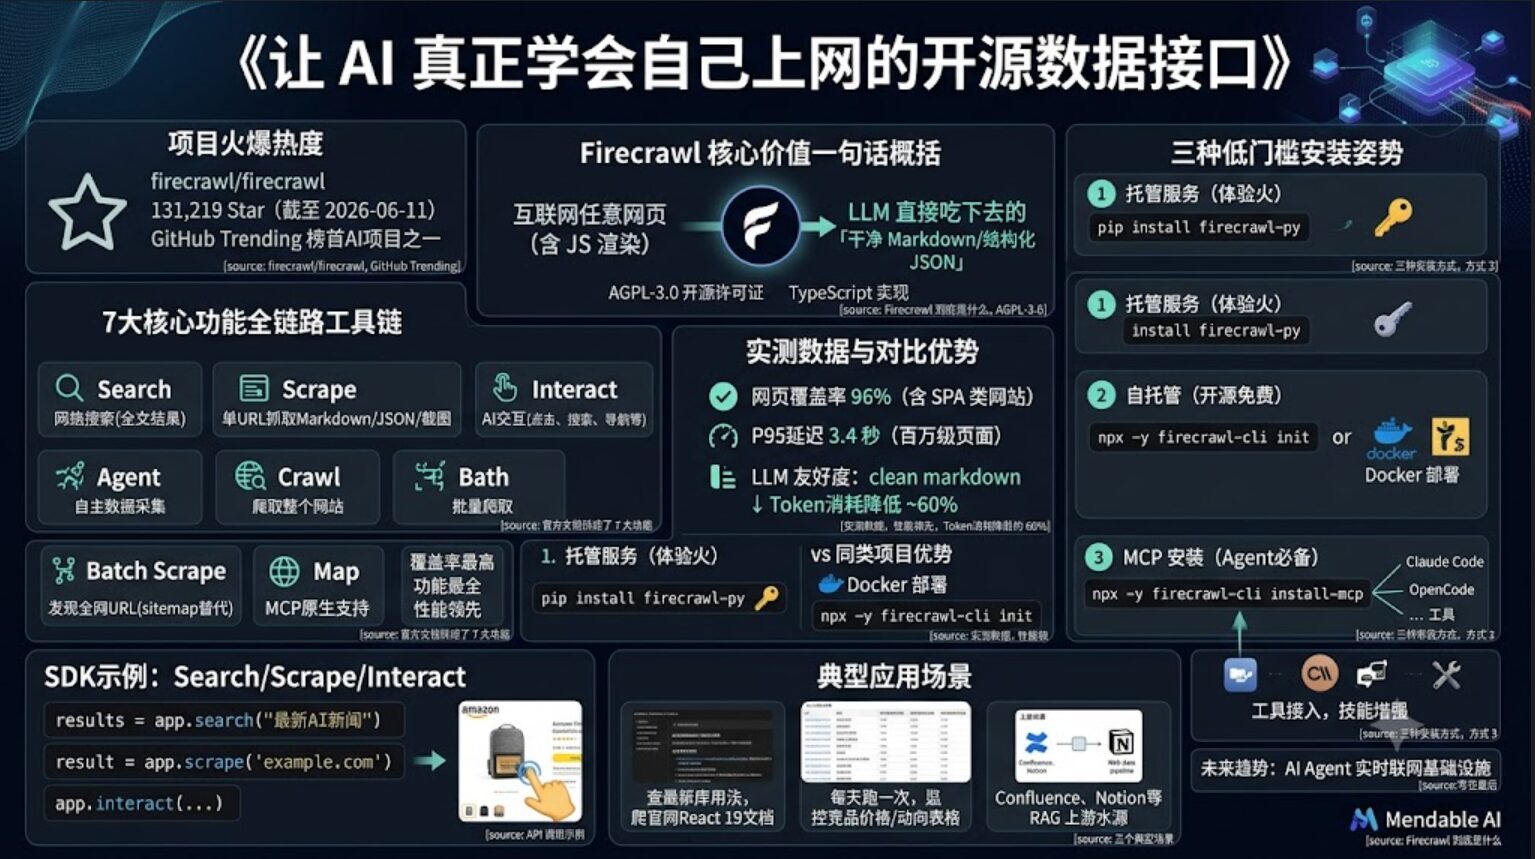
Firecrawl 是由 Mendable AI 开发的开源网页数据 API,定位是「大规模网页搜索、爬取、AI 交互」。它的核心价值可以一句话概括:
把互联网上任意一个网页(包括需要 JavaScript 渲染的动态页面),转换成 LLM(Large Language Model,大语言模型)能直接吃下去的「干净 Markdown」或「结构化 JSON」,让 AI Agent 能够实时获取最新网络数据。
几个关键背景:
- 131,219 Star(截至 2026-06-11)
- AGPL-3.0 开源许可证(开放但限制商业闭源再分发)
- TypeScript 实现,对开发者友好
- 原生支持 MCP 协议(Model Context Protocol,可以让 AI Agent 把它当作「工具」直接调用的标准协议)
7 个核心能力,一个比一个能打
Firecrawl 不只是一个爬虫,而是一个完整的「网页数据工具链」。官方文档把它拆成了 7 大功能:
| 功能 | 一句话解释 |
|---|---|
| Search | 搜索网络并获取结果全文(不只是标题摘要) |
| Scrape | 任意 URL 转 Markdown/HTML/截图/结构化 JSON |
| Interact | 先爬取页面,再通过 AI 提示或代码进行交互操作(点击、搜索、导航等) |
| Agent | 自主数据采集,描述需求即可自动完成 |
| Crawl | 单 API 请求爬取整个网站 |
| Map | 快速发现网站所有 URL(sitemap 替代方案) |
| Batch Scrape | 数千个 URL 异步批量爬取 |
其他一些亮点:
- 支持 PDF、DOCX 等文件解析
- Actions 功能:click、scroll、write、wait、press 等交互操作
- 自动处理代理轮换(IP 轮换防止被封)、速率限制(控制访问频率)、JS 渲染屏蔽
- MCP 协议原生支持,可连接任意 MCP 客户端
实测数据:96% 覆盖率、P95 仅 3.4 秒
一个爬虫工具到底能不能用,数据说了算。官方给出的几个关键指标:
- 网页覆盖率:96%(含 JS 渲染页面)—— 这意味着绝大多数主流网站都能成功爬取,包括 SPA(Single Page Application,单页应用)类网站
- P95 延迟:3.4 秒(百万级页面统计)—— P95 指的是「95% 的请求在这个时间内完成」,对实时性要求高的场景非常友好
- 输出格式:clean Markdown、structured JSON、screenshots
- 授权方式:开源自托管 + 托管服务(firecrawl.dev)
对比维度上,Firecrawl 在数据完整度上领先(JS 渲染 + 反爬绕过);在 LLM 友好度方面,输出 clean markdown,没有噪音 HTML,token 消耗(AI 模型按字数收费的计费单位)降低约 60%——这一点对 AI 应用开发者来说,省的是真金白银。
三种安装方式:托管、自托管、MCP
Firecrawl 的使用门槛非常低,三种姿势任选:
方式 1:托管服务(快速体验)
不想折腾服务器?直接用官方托管版 firecrawl.dev,注册即可拿 API Key。
# Python SDK
pip install firecrawl-py

python
>>> from firecrawl import Firecrawl
>>> app = Firecrawl(api_key="fc-YOUR_API_KEY")
>>> result = app.scrape('https://example.com')
方式 2:自托管(开源 + 免费)
对数据隐私敏感,或者想批量爬取不被 API 限额限制,可以本地跑。
# Docker 部署
git clone https://github.com/firecrawl/firecrawl.git
cd firecrawl
docker compose up -d

# 或使用 CLI
npx -y firecrawl-cli@latest init --all --browser
方式 3:MCP 安装(给 AI Agent 用)
这是最值得开发者关注的姿势——一条命令把 Firecrawl 接入 Claude Code、OpenCode 等 AI 编程工具。
npx -y firecrawl-cli@latest install-mcp装完之后,你的 AI 编程助手就多了一个「上网技能」:可以让它去搜最新文档、爬某个网站的内容、甚至和网页交互。
API 调用示例:Search / Scrape / Interact
Python SDK 的几个典型场景:
from firecrawl import Firecrawl
app = Firecrawl(api_key="fc-YOUR_API_KEY")

# 1) 网络搜索(拿到全文,不只是摘要)
results = app.search("最新AI新闻", limit=5)

# 2) 抓取单个页面
result = app.scrape('https://news.ycombinator.com')

# 3) 电商场景:搜索并交互
result = app.scrape('https://amazon.com/s?k=keyboard')
app.interact(result.metadata.scrape_id, prompt="Search for mechanical keyboard")
第三个例子特别有意思——「在亚马逊搜索机械键盘」这件事,Firecrawl 的 interact 可以让 AI 模拟人类操作浏览器,输入关键词、点击按钮、抓取结果。这相当于给 AI Agent 装了一双「手」。
和同类项目比,Firecrawl 强在哪
市面上「AI 友好爬虫」不少,Firecrawl 的差异点是什么?我们和主流的几个开源项目对比一下:
| 项目 | 星标 | 核心能力 | JS 渲染 | LLM 输出 | MCP 支持 | 许可证 |
|---|---|---|---|---|---|---|
| firecrawl/firecrawl | 131K | Search+Scrape+Interact+Agent | ✅ 96% 覆盖 | ✅ clean markdown/JSON | ✅ | AGPL-3.0 |
| jina.ai/reader | ~30K | URL 转 Markdown | ❌ | ✅ markdown | ✅ | Apache 2.0 |
| scrapegraphai/scrapegraphai | ~15K | 图表爬虫+LLM 编排 | ✅ | ✅ | ❌ | MIT |
| crawl4ai/crawl4ai | ~20K | AI 友好爬虫 | ✅ | ✅ | ❌ | MIT |
四个明显的优势:
- 覆盖率最高:96% 网页覆盖(含 JS),jina.ai 不支持 JS 渲染——很多现代网站用 jina 直接抓不到内容
- 功能最全:Search+Scrape+Interact+Agent+Crawl 全链路,竞品多为单一功能
- MCP 原生支持:开箱即用,Claude Code/OpenCode 等直接集成——这意味着你的 AI 编程助手今天就可以「上网」了
- 性能领先:P95 3.4 秒,实时 Agent 场景无压力
适合哪些人用?三个典型场景
说了这么多功能,到底什么场景才用得上?举三个最有代表性的:
场景 1:AI 编程助手实时查文档
你让 Claude Code 帮你写一段代码,但它训练数据截止到某个时间点。最新的库用法、最新的 API 变更它不知道。装上 Firecrawl MCP 后,你可以直接问它「帮我查一下 React 19 最新文档怎么写」,它会真的去官网爬内容回来再回答。
场景 2:竞品监控 + 舆情分析
做电商的朋友都知道,天天盯竞品价格、盯小红书爆款笔记很花时间。Firecrawl 的 interact 可以让 AI 模拟你手动操作——搜索关键词、翻页、抓价格,最终把结果整理成表格。每天早上自动跑一次,竞品动向尽在掌握。
场景 3:知识库 / RAG(让 AI「基于外部文档回答问题」的技术)喂数据
很多团队在搞私有知识库,让 AI 回答公司内部文档相关问题。但文档往往散落在 Confluence、Notion、各种内网网页里。Firecrawl 的批量爬取 + clean markdown 输出,正好是 RAG 系统的「上游水源」——把脏数据洗成 AI 能吃的格式。
💡 落地案例:我们对 Firecrawl 的实践评估
作为给电商团队提供 AI 工具链的团队,我们也认真评估了是否要把 Firecrawl 引入日常工作流。我们的结论是:不部署托管服务,但建议探索 MCP 集成。
具体决策依据:
- 已有能力覆盖:
我们现有的 Browser 工具和 fetch_url(轻量网页抓取工具)已经能解决 80% 的日常网页内容获取需求,再上一套 Firecrawl 会有功能重叠 - 成本考量:
大规模爬取需要付费 API,自托管需要额外的服务器资源(Docker、Redis、Playwright 等环境维护),投入产出比需要再算 - 差异化价值:
Firecrawl 的 Search 端点(网络搜索+全文获取)是我们当前最缺的——能让 AI 像人一样「先搜索、再阅读、最后总结」
短期(1 周内)我们打算评估 firecrawl search API 成本,考虑作为知识获取的增强层;中期(1 个月内)打算优化现有的 fetch_url 工具,参考 Firecrawl 的 clean markdown 输出格式,减少 token 浪费;长期如果确实需要大规模网络数据采集能力,再考虑自托管 Firecrawl。
如果你也在用类似的网页抓取工具链,可以参考这个思路——先盘清自己缺哪一环,再决定是引入新工具还是优化老工具。
写在最后:AI 时代的「数据接口」
Firecrawl 131K Star 的现象背后,是一个被很多人低估的趋势:AI Agent 正在从「对话工具」变成「上网工具」。以前的 ChatGPT 只能回答训练数据截止前的问题,而 Firecrawl 这类工具让 AI 拥有了「实时联网」的能力——这是 AGI(Artificial General Intelligence,通用人工智能)走向实用的关键基础设施。
对于我们这些非纯技术背景的创业者、运营人来说,Firecrawl 的意义不在于「我要不要自己写爬虫」,而在于:
- 以后和 AI 对话时,可以期待它「查完再回答」
- 自己的业务数据(电商评论、竞品价格、行业报告)可以被 AI 自动采集整理
- 各种 AI 编程助手、Coding Agent 会越来越强,因为它们有了「上网技能」
GitHub Trending 上每隔一段时间就会出现一个「AI 基础设施」类的项目爆火。Firecrawl 不是第一个,也不会是最后一个。但它今天的 131K Star 至少说明一件事:「让 AI 联网」这件事,市场已经给出了明确的答案。
如果你对 Firecrawl 感兴趣,可以去 GitHub 搜 firecrawl/firecrawl 看看完整文档,或者直接去 firecrawl.dev 注册个免费 Key 试一把。