
为什么这篇值得读
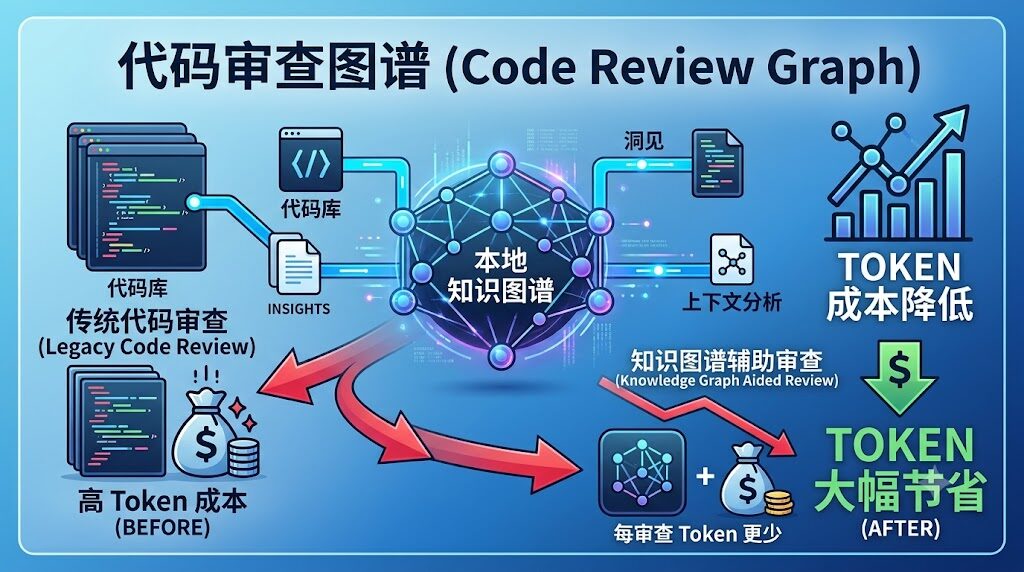
你有没有遇到过这种场景:让 Cursor 或 Claude Code 帮你 review 一段代码,它把整个项目都读了一遍,最后光"上下文"就烧掉几万 token,回答还没几句。
2026-07-21 GitHub Trending 上有一个叫 code-review-graph 的项目,一天涨了 1,833 颗星。它做的事情直击这个痛点——给 AI 编程工具一张"代码地图",让 AI 只看自己真正需要看的文件,而不是整个仓库。
实测下来,token 节省的中位数是 82 倍,在 fastapi 这种大型 Python 项目上甚至能达到 528 倍。
code-review-graph 是什么
code-review-graph 是一个本地优先(local-first)的代码知识图谱工具。它会用 Tree-sitter 把你的代码库解析成一张"图"——节点是函数、类、导入关系,边是调用、继承、测试覆盖。
然后通过 MCP(Model Context Protocol) 协议,把这张图喂给 Cursor、Claude Code、Codex、Copilot 这些 AI 编程工具。当 AI 想 review 一段代码时,它只会读取真正相关的文件——也就是所谓的 blast radius(爆炸半径)。
一句话:把"全库扫描"变成"按需加载",token 花在刀刃上。
核心架构怎么走
整个数据流是这样的:
代码库文件
  ↓ Tree-sitter AST 解析
代码知识图谱(节点=函数/类/导入,边=调用/继承/测试覆盖)
  ↓ MCP 协议
AI 编程工具(Cursor / Claude Code / Codex / Copilot)
  ↓ 精确上下文注入
只读 blast radius 内的文件
三个关键技术点
- Tree-sitter:一种增量解析器,能在不重新扫描整个文件的情况下更新代码结构。意思是即使你改了 1 个文件,图谱也能在几毫秒内同步
- MCP 协议:Anthropic 在 2024 年推出的开放标准,让 AI 工具能以统一的方式访问外部数据/工具。现在 Cursor、Claude Code、Codex、Copilot 都在支持
- 本地执行:图谱构建、查询全在本地完成,代码不需要上传到任何云服务
关键数字
| 指标 | 数据 |
|---|---|
| Token 节省(中位数) | 约 82 倍 |
| Token 节省(最佳案例) | 528 倍(fastapi 项目) |
| 增量更新速度 | 2,900 文件项目重索引 < 2 秒 |
| 单次变更影响分析 | ~15 个文件(非全库扫描) |
| 模糊搜索质量(MRR) | 0.35 |
| 支持语言数 | 40+(通过 Tree-sitter) |
注:528 倍是 fastapi 这种大型 Python 项目的最佳案例,不代表所有项目都能达到。中位数 82 倍是更现实的参考值。
支持哪些 AI 编程工具
- Codex
- Cursor
- Claude Code
- Gemini CLI
- Kiro
- GitHub Copilot (VS Code)
- GitHub Copilot CLI
- CodeBuddy
基本上主流的 AI 编程工具都覆盖了。安装的时候会自动检测你环境里有哪个,直接对接。
怎么用
# 安装
pip install code-review-graph

# 自动检测并配置所有已安装的 AI 编程平台
code-review-graph install

# 解析代码库,构建知识图谱
code-review-graph build

# 卸载前预览(不会真删)
code-review-graph uninstall --dry-run
第一次 build 会花点时间(取决于项目大小),之后因为是增量更新,每次只需要几秒钟。
它适合什么场景
最匹配的 4 个场景
- 大型代码库(1,000+ 文件)的 AI 代码审查——节省最明显
- Monorepo 多语言项目——40+ 语言支持 + 增量更新是真刚需
- 需要代码隐私保护的 CI/CD 流程——GitHub Action 本地执行,代码不外发
- AI 编程工具的上下文优化——解决"AI 老是把整个仓库塞进 context"的痛点
可能不太适合
- 小型项目(< 100 文件)——全库扫描本来就不慢
- 不使用 AI 编程工具的团队——这工具是给 AI 用的
- 需要"全库语义搜索"的场景——这是基于 blast radius 的,不是全局搜索
几个值得借鉴的设计
仔细看这个项目,有几个工程实践值得学习:
Tree-sitter 增量解析
实时响应的代码分析引擎,关键是"增量"。换文件 → 局部更新,不全量重算。适合任何"代码 → 结构化数据"的工具链。
MCP 协议的跨平台集成
一套协议,8 个 AI 编程工具都接得上。这就是开放标准的价值——不用每个工具单独适配。
GitHub Action 本地执行
自动化 + 安全合规可以兼得。Action 跑在 GitHub 的 runner 上,但所有代码处理都在本地(runner 的本地),不会把代码发到第三方。
可复现的基准测试
eval runner + 固定 seed + pinned SHA,所有数字公开可验证。"528 倍"不是嘴上说说,有复现路径。
自己跑自己的 PR review
这个项目自己就用 code-review-graph review 自己的 PR。dogfooding(自己吃自己的狗粮)——用真实场景验证,不靠 demo 数据。
跟同类工具比呢
| 维度 | code-review-graph | 传统 ctags / LSP | 纯向量搜索(RAG) |
|---|---|---|---|
| 速度 | 增量 <2 秒 | 快 | 取决于向量库 |
| Token 效率 | 极高(82x 中位数) | 无(不接 AI) | 中等(需要塞相关 chunk) |
| 关系理解 | 函数/类/调用/继承 | 函数/类定义 | 语义相似度 |
| 隐私 | 本地执行 | 本地 | 通常需要云端 |
| AI 工具集成 | MCP 协议,原生 | 需自己接 | 需自己接 |
简单说:传统代码索引工具不接 AI,纯 RAG 又不够精准。code-review-graph 的路子是"用代码结构(AST)替代语义相似度,把精度和 token 效率同时拉满"。
你需要担心什么
公平起见,说几个潜在的坑:
528 倍是天花板
你自己的项目可能拿不到这个数,参考中位数 82 倍比较现实。
模糊搜索精度有限
MRR 0.35 不算高——意思是"找相关代码"的精度有限,更适合"按 blast radius 圈定范围",不适合"自由文本搜索"。
MCP 协议还年轻
各家 AI 工具支持程度不一,可能遇到兼容性 bug。
Python 3.10+ 版本要求
老项目要注意版本。
总结
code-review-graph 的爆火不是偶然。它解决的是一个真实存在、且 AI 编程工具普及后越来越严重的痛点——token 浪费。
如果你正在用 Cursor、Claude Code 或 Codex 做严肃的代码审查工作,这个工具值得一试:
- 安装简单(一行 pip install)
- 配置自动化(自动检测 + 配对 AI 工具)
- 效果立竿见影(中位数 82 倍 token 节省)
- 数据安全(本地执行,代码不外发)
GitHub 地址:https://github.com/tirth8205/code-review-graph
许可证:MIT,可以放心用在商业项目里。