
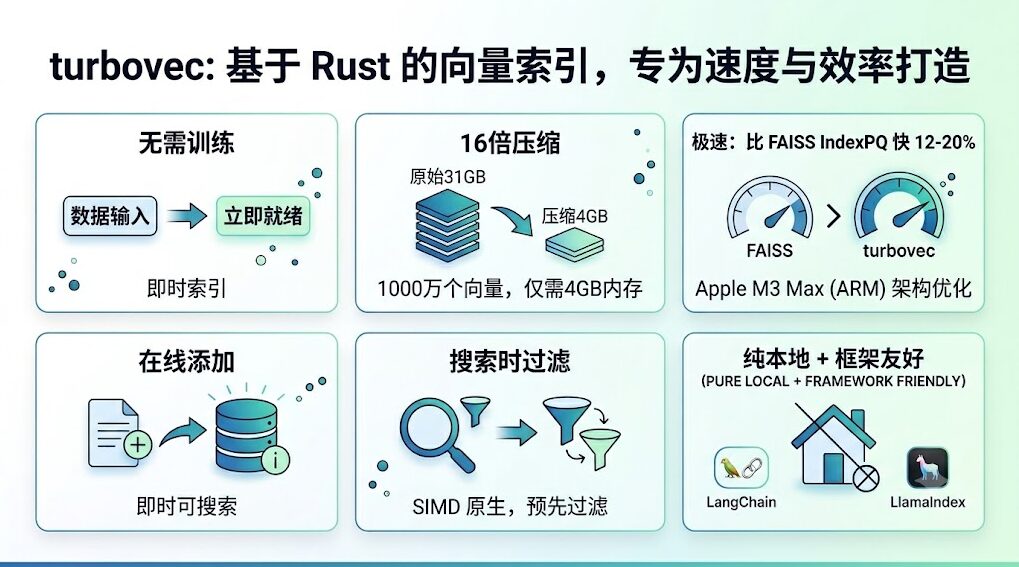
turbovec 是一款基于 Google Research TurboQuant 算法的 Rust 向量索引,无需训练、比 FAISS IndexPQ 快 12-20%、10M 文档仅占 4GB 内存(16x 压缩),原生支持在线添加、搜索时过滤与 LangChain/LlamaIndex 集成,
pip install turbovec即可上手。
一个让人坐不住的数据
今天的 GitHub Trending 上,RyanCodrai/turbovec 一天之内涨了 1,729 颗星——总星标 9,169 颗。凭什么?
一个 Rust 写的向量索引,没有"重磅融资"、没有"明星背书",单凭技术本身在 Trending 上抢位。翻完 README 和论文(arXiv:2504.19874)后,我把它推荐给所有在做 RAG、本地知识库、向量检索的同学——它解决的三个问题,恰好是 FAISS 用户最头疼的。
turbovec 是什么?
一句话定义:基于 Google Research TurboQuant 算法的 Rust 向量索引,提供 Python 绑定。
展开讲:TurboQuant 是 Google Research 在 2025 年发表的一种"无训练量化"算法(arXiv:2504.19874),不依赖预训练、不需要构建码本(codebook),直接对向量做 2-bit 级别的压缩。turbovec 把这套算法工程化成了一套生产可用的向量索引,并提供了 Python 端 SDK 和主流 RAG 框架的集成。
如果你熟悉向量检索这个领域,turbovec 的定位可以理解为:FAISS 的低配版使用门槛 + Milvus 的高压缩比。
六大核心亮点
1. 免训练:拿到向量就能用
FAISS 的 PQ(Product Quantization)系列索引需要先"训练"——拿一批样本数据拟合码本。这个过程有几个麻烦:
- 需要提前准备训练样本(一般要几千到几万条向量)
- 码本一旦训练完,更换数据分布就得重新训练
- 训练本身要花时间,大数据集可能要几十分钟
turbovec 跳过了这一步。TurboQuant 算法本身不需要训练,拿到向量就能直接索引、立即搜索。对小数据集(<10M 向量)、数据分布变化快、冷启动场景,这是实打实的省时间。
2. 16x 压缩:10M 文档只需 4GB 内存
官方数据:1000 万条向量,FP32 原始数据 31GB,turbovec 压缩到 4GB——16x 压缩比。
这背后是 2-bit 量化:每条向量从 6144 字节(1536 维 × 4 字节 FP32)压到 384 字节(1536 维 × 2-bit)。
| 维度 | FP32(原始) | 2-bit(turbovec) | 压缩比 |
|---|---|---|---|
| 384 | 1536 字节 | 96 字节 | 16x |
| 768 | 3072 字节 | 192 字节 | 16x |
| 1024 | 4096 字节 | 256 字节 | 16x |
| 1536 | 6144 字节 | 384 字节 | 16x |
| 3072 | 12288 字节 | 768 字节 | 16x |
这意味着什么?一台普通的 8GB 内存笔记本,理论上能装下 2000 万条 1536 维向量——大约对应 1-2 亿字的文本语料。
3. 比 FAISS 快 12-20%
性能对比来自官方 benchmark:
| 架构 | 对比对象 | 速度提升 | 优化指令集 |
|---|---|---|---|
| Apple M3 Max(ARM) | FAISS IndexPQ | 快 12-20% | NEON |
| x86 服务器 | FAISS IndexPQ | 快 1-6% | AVX-512BW |
ARM 平台(M 系列 Mac、ARM 服务器)提升最明显。turbovec 用 Rust 写了 SIMD 内核,Apple Silicon 上是 NEON,x86 上是 AVX-512BW——两条路线都把向量距离计算的吞吐打满了。
4. 在线索引:添加向量即时可搜索
FAISS 的 IndexPQ 重建索引要花时间,往存量索引里塞新向量要么 append-only 要么重建。turbovec 把这件事做得更轻:添加向量后立即可搜索,不需要重建。
对增量场景(用户上传文档、聊天记录、客服工单等持续增长的数据),这个特性很省心。
5. 搜索时过滤(SIMD 内核原生支持)
在向量检索里做"过滤"是个老难题。传统做法是先粗排 Top-K 再 Python 端过滤,浪费算力。turbovec 在 SIMD 内核里直接处理过滤条件,搜索和过滤一步完成,没有"先召回再筛"的损耗。
典型场景:搜索"过去30天内用户A的已发布的"文档中语义相似的 Top-K。FAISS 要分两步,turbovec 一步出。
6. 纯本地 + 框架友好
- 纯本地运行,无托管服务、无网络请求——隐私场景的天然选择
- MIT 许可,商用友好
- 框架集成:官方提供 LangChain、LlamaIndex、Haystack、Agno 的集成包
安装与上手
Python 端安装一行命令:
# 基础安装
pip install turbovec

# LangChain 集成
pip install "turbovec[langchain]"

# 其他框架(LlamaIndex / Haystack / Agno)同样模式
pip install "turbovec[llamaindex]"
最小使用示例:
import numpy as np
from turbovec import TurboVecIndex

# 准备向量(1536 维,1000 万条)
vectors = np.random.rand(10_000_000, 1536).astype(np.float32)
ids = np.arange(10_000_000)

# 创建索引
index = TurboVecIndex(dim=1536)
index.add(vectors, ids)

# 搜索
query = np.random.rand(1536).astype(np.float32)
scores, result_ids = index.search(query, k=10)
print(result_ids)
与同类对比
| 维度 | turbovec | FAISS IndexPQ | Milvus |
|---|---|---|---|
| 需要训练 | ❌ | ✅ | ✅ |
| 在线索引(实时添加) | ✅ | ⚠️ 受限 | ✅ |
| 搜索时过滤 | ✅ SIMD 原生 | ⚠️ 需后过滤 | ✅ |
| 部署复杂度 | 低(pip install) | 中 | 高(独立服务) |
| 数据是否离开本地 | 否 | 否 | 否(自托管) |
| 10M 向量内存占用 | ~4 GB | ~6-10 GB | ~6-10 GB |
| 适用规模 | 中小(≤ 50M) | 中大 | 大(亿级) |
三个工具的定位不太一样:
- FAISS:最成熟,生态最全,但需要训练 + 没有内置过滤
- Milvus:分布式、生产级,但部署重、上手成本高
- turbovec:免训练、纯本地、压缩比高,适合中小规模、对部署简单度有要求的场景
适用场景
- 本地 RAG / 私有知识库:数据不能上云、本地推理、需要快速上线
- 中小规模向量检索(≤ 5000 万条):从 FAISS 切换过来省训练时间
- 增量数据场景:用户上传、聊天记录、日志检索等需要持续添加的
- 需要过滤的检索:时间范围、用户标签、状态等多条件组合
- Apple Silicon 性能敏感:M 系列 Mac 用户加速最明显(12-20%)
不适用场景
- 亿级以上规模:Milvus / Qdrant / Vespa 更合适
- 严格召回率要求:2-bit 量化是"近似检索",需要 100% 召回请用 HNSW 或暴力检索
- 需要 GPU 加速:turbovec 目前只支持 CPU SIMD,没有 GPU 实现
参考资源
- GitHub: https://github.com/RyanCodrai/turbovec
- PyPI: https://pypi.org/project/turbovec/
- 论文: https://arxiv.org/abs/2504.19874(TurboQuant: A rigorous filter for outlier coordinates in vector quantization)
如果你在 RAG 落地过程中被 FAISS 的训练门槛或 Milvus 的部署复杂度劝退过,turbovec 是值得放进候选清单的一个选项。