
打开 GitHub 搜索 "awesome",你能看到 5 万多个仓库,命名格式清一色是 awesome-python、awesome-vue、awesome-rust——这是一个真正的"约定俗成"。但奇怪的是,这一切其实只起源于 12 年前一个挪威程序员的个人清单。
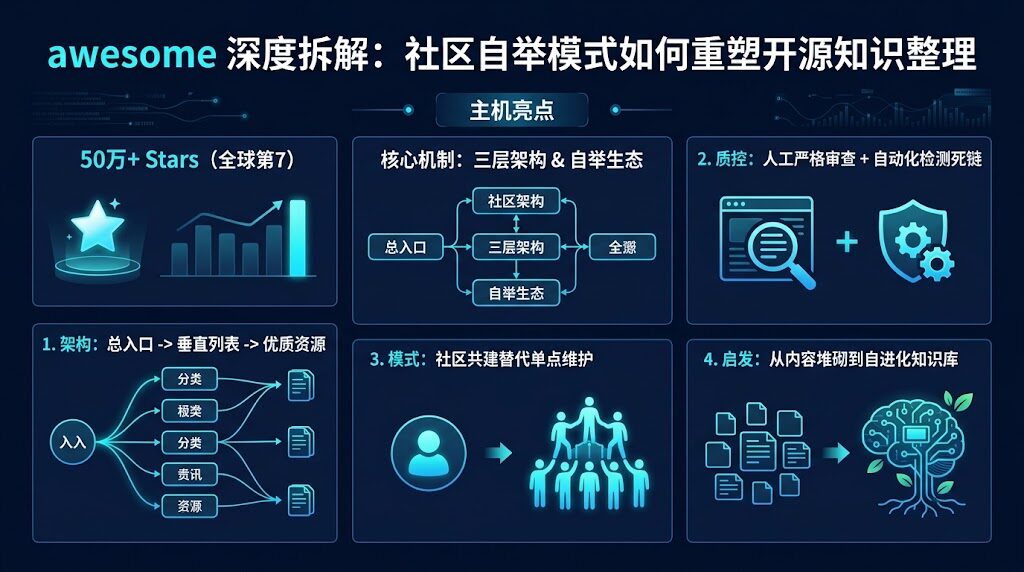
sindresorhus/awesome 仓库目前 Star 数 504,034(全球第 7 高),Forks 36,781,覆盖从 AI、区块链到命令行工具的每一个技术领域。它不是软件,不是工具,而是一种"知识组织范式"——理解了它,你就理解了 GitHub 上 5 万多个 awesome-xxx 项目为什么能活下来,以及你自己做知识库、做团队 Wiki 时,可以从中学到什么。
如果你是创业者、运营、内容工作者,这篇文章能帮你用一种全新的思路来看"知识管理"这件事——不是文档越多越好,而是要让好内容自己浮上来。
一、这个仓库是什么?
1.1 基本信息
| 维度 | 数据 |
|---|---|
| 项目 | sindresorhus/awesome |
| 作者 | Sindre Sorhus(npm 生态最高产作者,200+ 包) |
| GitHub 链接 | https://github.com/sindresorhus/awesome |
| Stars | 504,034(全球第 7) |
| Forks | 36,781 |
| 许可证 | CC0-1.0(完全公有领域,谁都可以用) |
| 创建时间 | 2014-07-11 |
| 现状 | PR 暂时关闭(作者公告"catch up"中) |
1.2 它不是一个"软件项目"
很多第一次看到 awesome 仓库的人会问:代码在哪?这不是软件——它本身就是一个Meta List(元清单):
一份关于"如何整理各类清单"的清单。
它的内容指向 GitHub 上 5 万多个垂直领域的 awesome 列表,每个垂直列表又指向那个领域里最好的资源、教程、工具、论文。这种"俄罗斯套娃"式的结构让它成为了开源世界的"知识总入口"。
二、awesome-list 到底是什么?
2.1 约定俗成的命名规范
"awesome-list"是 GitHub 上一个自发形成的命名约定:
- 仓库名固定为
awesome-<主题>(如awesome-python、awesome-vue) - 必须包含真实有用的资源,拒绝凑数
- 通过 GitHub stars 自我进化——好列表被更多人看到 → 更多 PR → 质量越好
2.2 Sindre 本人的核心哲学
在 README 里他写得很直接:
Curated lists of valuable resources, no junk, no fake "100 best" SEO bait. (精心整理的有价值资源列表,不凑数、不要"100 大"SEO 诱饵。)
这句话背后是 12 年的坚持——他亲自审查每一个 PR,拒绝广告、拒绝死链、拒绝自我推销。正因如此,awesome 仓库的 Star 数才会突破 50 万。
2.3 为什么它能活 12 年?
普通人的清单文档的命运:写完 → 半年不更新 → 死链堆积 → 无人问津。
awesome 列表的命运:发布 → 用户提交 PR 补充 → 自动化工具查死链 → Sindre review → 持续维护。
关键差异:它是社区的事,不是某一个人的事。
三、架构设计:极简到极致
awesome 仓库的目录结构极其简单:
awesome/
├── readme.md          ← 主入口(固定格式)
├── sections/          ← 各主题目录
│   ├── artificial-intelligence.md
│   ├── blockchain.md
│   └── ...
└── .github/           ← 自动化(PR 模板、Bot)
3.1 README 的"固定格式契约"
每个 awesome 列表的 README 都有约定俗成的结构:
# Awesome <Topic>
[](https://github.com/sindresorhus/awesome)
> Curated list about ...
### Contributing
### Contents为什么要有固定格式?
- 读者扫一眼就知道在哪找到自己想要的内容
- 新人提 PR 时知道往哪加,不会破坏整体结构
- 第三方工具(Track Awesome)可以批量解析所有 awesome 列表
3.2 三层索引架构
第一层:sindresorhus/awesome(入口)  → 指向各个垂直主题
第二层:awesome-python, awesome-vue...  → 指向具体资源
第三层:具体资源(教程、库、工具)
这种"分层 + 单一入口"的设计,让任何人都可以快速从"我想找 AI 资源"走到"这篇论文讲了什么"。
四、质量控制机制——为什么不容易"烂掉"
awesome 列表看起来简单,但它有一套完整的多层质量控制,让 50 万 Star 不是泡沫:
4.1 人工审查规则(Sindre 本人)
| 规则 | 说明 |
|---|---|
| ✅ 必须真实有用 | 资源得有实际价值,不是凑数 |
| ✅ 必须免费或开源 | 商业产品不放(避免广告嫌疑) |
| ❌ 不允许死链 | 必须能正常访问 |
| ❌ 不允许自我推销 | 不能放自己的项目(利益冲突) |
| ❌ 不允许课程推销 | 拒绝任何形式的付费课程引流 |
注意:Sindre 之所以能坚持 12 年自己审查,是因为他个人信用足够高。换一个没人认识的人来审查,社区可能根本不买账——这点我们后面再展开。
4.2 自动化检测
即使有人工审查,5 万多个仓库也维护不过来。所以 awesome 自带自动化:
check-article-dates.py:检查链接文章日期,拒绝过旧内容check-links.sh:检测死链- PR 模板强制填写"为什么这个资源值得收录"
自动化 + 人工 review 的组合,让 awesome 既能规模化,又不丢失质量。
4.3 第三方追踪平台
Track Awesome 是一个独立网站,专门追踪所有 awesome-list 的动态:
- 哪些列表更新了
- 哪些列表半年没动(提示可能"烂掉"了)
- 各领域的活跃度排名
这等于给整个 awesome 生态装了一个"健康监测系统"。
五、为什么它如此重要?
5.1 开源知识组织的范式转变
| 传统知识组织 | awesome 模式 |
|---|---|
| 专家编写 | 社区自举 |
| 出版后被动接受 | 持续动态更新 |
| 中心化编辑 | 群体智慧 |
| 一次性产出 | 永续维护 |
这种转变的本质是:把知识的"所有权"从机构转移到了用户。
5.2 催生了 5 万+ 个 awesome-list
GitHub 上目前有 50,000+ 个 awesome 仓库,覆盖几乎每一个技术领域:
- 编程语言(awesome-python, awesome-go)
- 框架(awesome-vue, awesome-react)
- 垂直领域(awesome-blockchain, awesome-quantum-computing)
- 工具类(awesome-cli, awesome-docker)
这意味着:每个细分领域都有了自己社区维护的知识入口。
5.3 零维护成本的"活文档"
普通文档的命运:写完 → 半年没人管 → 死链 → 失效。
awesome 列表的命运:发布 → 社区提交 PR → 自动化检查 → 审查合并 → 持续更新。
核心洞见:它把"维护文档"从一个人/团队的任务,变成了社区的协作。
六、对你的知识库建设有何借鉴?
6.1 可以借鉴的部分
✅ 固定格式契约 如果你的团队 Wiki 有几十个不同作者,使用"模板"统一格式。新作者照着写就行,老读者扫一眼就知道在哪找内容。
✅ 社区贡献流程 让用户通过 PR 提交补充,自动化工具做底线检查,人工 review 做质量把关。这种组合既规模化又不丢失质量。
✅ Meta-list 思维 "知识的知识"——做一个索引页指向各个子目录,让用户能快速定位自己需要的内容。awesome 本身就是个 Meta-list。
6.2 不适合照搬的部分
⚠️ awesome 的价值核心是"人工 curation"
如果你想做 awesome 模式的清单,最关键的资产是"一个愿意长期审查的高信用守门人"。Sindre Sorhus 之所以能坚持 12 年,是因为他在 npm 生态已经建立了顶级声誉。换成普通账号,PR 提了可能根本没人 review。
⚠️ 自动化不能完全替代人工 awesome 的死链检测、日期检查都是兜底。但"这条资源值不值得收录"必须人工判断。完全自动化的清单最后都会变成垃圾场。
6.3 启发:约定俗成 > 强制规范
awesome-list 的命名规范不是任何人规定的,而是社区"自发形成的事实标准"。这给我们一个启发:
如果你能设计一套自演化的标签体系/命名约定,让用户用着用着就形成了习惯,比强制规定要有效得多。
例如:
- 文档标签用统一前缀(如
ai-、电商-、运营-) - 项目命名遵循固定模板
- 文件夹结构保持稳定
七、核心洞察总结
读完这个项目,可以提炼出 4 条原则:
| 原则 | 含义 |
|---|---|
| 社区自举 > 中心化编辑 | 好内容自己会浮上来,不需要专人维护 |
| 约定俗成 > 强制规范 | "awesome-" 前缀是事实标准,不是 RFC 强制规定 |
| 自动化保底 > 人工盯防 | 用 check-links.py 等工具做质量守门员 |
| 零维护的代价 | 需要一个高信用的"守门人"(Sindre 本人) |
对知识库建设者的具体建议
- 做"知识的知识"——建立一个总索引页指向各个子目录
- 统一标签前缀——让标签体系自演化
- 配自动化检查脚本——死链、过期内容自动告警
- 保留一个人工 review 环节——质量底线必须有人守
八、相关资源
写在最后
sindresorhus/awesome 看似简单,但它背后的"约定俗成 + 社区自举 + 自动化保底"组合拳,是开源世界最值得学习的范式之一。
无论你是做团队 Wiki、做内容社区、做电商知识库,还是单纯想把自己的笔记整理得更清晰,都可以从中得到启发:最好的知识组织,是让好内容自己浮上来,而不是靠个人英雄主义。