
AI助手的会话失忆这个问题,用一个插件claude-mem就可以解决。它的核心思路只有一句话:把 Claude Code 在每次会话里做了什么、为什么这么做,全部自动沉淀下来,下一次开会自动带上「上次的记忆」。
如果你用 Claude Code / Cursor / Windsurf / Codex / Gemini CLI 写过一两天以上的项目,大概率撞过这个场景——上周明明和它一起把某个模块重构好了,这周开新会话问「我们之前怎么处理的」,它一脸茫然」。这种感觉最让人沮丧的不是它「不会」,是它连「上次会话已说过的话」都要主动归档。
claude-mem 治的就是这个。
它到底解决什么问题
AI 编程助手本质是无状态的——每次新会话都从零开始,它不知道你上周改了哪个文件、为什么引入这个依赖、踩过哪些坑。结果是:
- 每次都得重新解释项目背景
- 它会重复犯你已经修过的错
- 长项目的架构决策随着时间被遗忘
- 你得自己手动写笔记,再喂给它
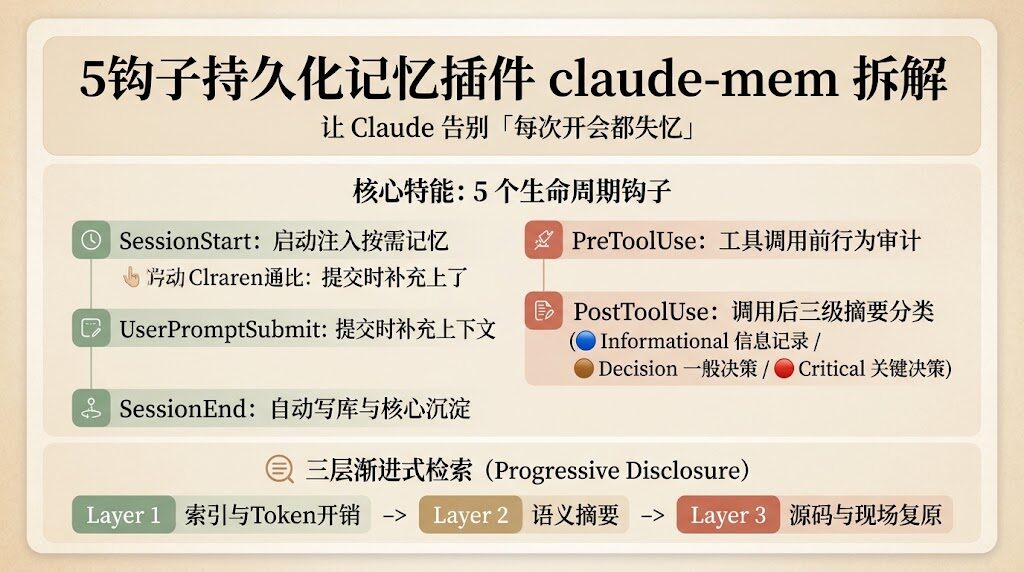
claude-mem 的做法是:背后挂一个 SQLite 数据库 + 一个本地 Worker 服务,通过 5 个生命周期钩子(Hook) 把会话里的每一次工具调用、每一次观察捕获下来,再让 Claude 自己提炼「今天学到了什么」。下次开会,这些摘要自动注入到上下文。
五个生命周期钩子:自动沉淀的工程底座
claude-mem 最值得抄的不是「它把记忆存下来了」,而是「它把记忆沉淀嵌入到了 AI 工作流的每一个关键节点」。这五个钩子是:
SessionStart(会话启动时)
新会话一打开,claude-mem 就把上次相关的记忆摘要按 token 开销从低到高排好,只注入最相关的那一段——不是把整个历史都塞进去,而是按需召回。这是它和「把整本 chat history 喂进去」的根本差异。
UserPromptSubmit(用户提交 Prompt 时)
你发一句「继续重构订单服务」,claude-mem 在 Claude 收到前先在 prompt 后面追加「上次你重构订单服务时,改动了 OrderService.php 第 87-行,引入 Repository 模式……」让 Claude 带着上下文开工。
PreToolUse(工具调用前埋点)
每次 Claude 要执行 Read / Bash / Edit 之前,claude-mem 记录「即将发生什么」。这是审计 + 解释性回溯的基础——一周后你能查到「那个 bug 是哪次工具调用引入的」。
PostToolUse(工具调用后埋点)
工具执行完,立刻让 Claude 自己生成结构化语义摘要,按类型分三类:
- 🔴 critical(关键决策:为什么引入这个依赖)
- 🟤 decision(一般决策:选 A 不选 B 的理由)
- 🔵 informational(信息记录:读了这个文件,发现 X)
这些摘要带 concept tag + file reference,支持 FTS5 全文搜索。
SessionEnd(会话结束时自动保存)
会话一关,claude-mem 把整个会话的高保真 transcript 写入 SQLite,附带「这次会话学到的核心 3 件事」。下次开会,SessionStart 钩子会把这 3 件事 + 相关历史 observations 自动拉回来。
这 5 个钩子的设计哲学是:「零人工干预的全自动沉淀」——你不需要写 README、不需要写日记、不需要「会议纪要模板」,AI 自己就是会议记录员。
三层渐进式披露(Progressive Disclosure)检索
claude-mem 不是「把所有记忆塞给 Claude」,而是分了三层:
Layer 1(Index):列出已有的 observations,显示 token 开销
  ↓ 按需展开
Layer 2(Details):获取完整语义摘要
  ↓ 按需召回
Layer 3(Perfect Recall):回溯源代码和原始 transcript
这与人脑认知模式完全一致——先感知「有哪些记忆可用」,再决定「要不要调取细节」,最后才是「精准还原现场」。
举个例子,假设你想知道「上次为什么重构了订单状态机」:
- Layer 1:claude-mem 返回「3 条相关记忆,总计 1,200 token」
- Layer 2:你选「看下完整摘要」→ claude-mem 返回 3 条 observations 全文
- Layer 3:你说「回到那次改动的代码现场」→ claude-mem 直接调 git 工具拉 diff + 当时的 transcript
关键设计:Layer 1 只展示 token 成本,让 Claude 自己决定值不值得调取。这个思路可以迁移到所有「带 token 预算的检索系统」——不要替 AI 做决定,把开销透明化即可。
多 AI Provider 兜底:不绑定 Anthropic
claude-mem 默认走 Claude SDK,但它同时支持:
- Claude SDK(默认)
- Gemini(Google 主力模型)
- OpenRouter(100+ 模型一键切换,包括开源 Llama / DeepSeek)
- Anthropic API(直连并发)
这意味着:即使 Anthropic 涨价 / 限流 / 政策风险,你都能随时切换到 OpenRouter 上的其他模型,记忆系统不绑定任何单一供应商。
对开发者的实际价值:你不必为了换模型重写整个记忆系统——claude-mem 抽象出了「Provider 接口」,换模型只改一行配置。
MCP 搜索协议 + Citation 精准召回
claude-mem 通过 MCP(Model Context Protocol)暴露搜索接口,Claude 可以用自然语言查询历史会话:
> 搜:上次重构订单服务时的架构决策
< 找到 3 条相关 observations:
  - obs_abc123(critical,2026-09-28):引入 Repository 模式解耦…
  - obs_def456(decision,2026-09-28):选 PostgreSQL 不选 MongoDB…
  - obs_ghi789(informational,2026-09-28):读了 12 个领域文件…
更牛的是 Citation 机制:
- 引用
obs_abc123→ 直接调取那条 observation 的全文 + 当时的 transcript + 改动的代码 diff - 这是「精准召回」,比模糊语义匹配稳定 10 倍
| 召回方式 | 稳定性 | Token 开销 |
|---|---|---|
| 模糊语义匹配 | 低(容易跑偏) | 高(要返回 top-N) |
| 关键词全文搜索 | 中(依赖分词) | 中 |
| Citation observation ID | 高(精确锁定) | 低(只取 1 条) |
如果你正在做 RAG / Agent 记忆系统,Citation 设计值得直接抄。
Web Viewer:实时查看记忆流
claude-mem 自带 Web 界面,监听 localhost:37777:
- 实时看 Claude 的每一次工具调用 + observation 生成
- 按 observation ID 追溯「这次决策是怎么来的」
- 支持 Endless Mode(仿生记忆架构,让 AI 主动检索而不是被动等待)
Endless Mode 的核心是:Claude 不再依赖「被告知要调取记忆」,而是像人一样「主动想起」——比如写到订单状态机时,它会主动问 claude-mem「我之前有没有处理过类似的状态机设计」。
5 分钟本地跑起来
# 1. 安装
/plugin marketplace add thedotmack/claude-mem
/plugin install claude-mem

# 2. 启动 Worker
npm install -g claude-mem-worker
claude-mem-worker start

# 3. 验证钩子挂载
claude-mem status
# 输出:5/5 hooks mounted ✅

# 4. 打开 Web Viewer
open http://localhost:37777注意:claude-mem 默认把 SQLite 存在 ~/.claude-mem/,所有数据完全本地。如果你要部署到团队工作流,建议把 SQLite 改成 Postgres + 共享存储,让多人协作共享同一份记忆。
谁适合用,谁不需要
| 人群 | 收益 | 门槛 |
|---|---|---|
| 个人开发者,长期维护同一项目 | ⭐⭐⭐⭐⭐ | 低 |
| 团队协作,需要「知识沉淀」 | ⭐⭐⭐⭐ | 中(需要约定标签) |
| 一次性脚本 / 小工具 | ⭐ | 太重 |
| 处理敏感信息(密码/密钥/合规) | ⚠️ | 建议加密 SQLite + 离线部署 |
真实落地经验:用了一周之后,最显著的改变不是「Claude 变聪明了」,而是「我不用每周花 2 小时给它写项目背景说明」——它自己记得。
借鉴:claude-mem 的 3 个工程设计
如果你正在自己造 Agent / 记忆系统 / RAG,claude-mem 有 3 个设计可以直接抄:
1. 钩子嵌入工作流,而不是「认知边写日记」
claude-mem 的 5 个钩子实现了「零人工干预的全自动记忆沉淀」。传统做法的痛点是:要求开发者写 README / 写 commit message / 维护 CHANGELOG——人会忘记的,AI 也是这么干的。把记忆嵌入 AI 工作流的每一个关键节点,让它自己说话。
2. Progressive Disclosure UI + Token 开销透明
Layer 1 只展示「有哪些记忆 + token 成本」——让 AI 自行决定要不要。这个思路可以直接迁移到所有「带 token 预算的检索系统」:
- 检索结果先展示摘要和引用开销
- 让消费者决定是否值得展开
3. Citation 机制 + 精准 ID 召回
Observation ID 直接引用 → 精准召回,比模糊语义匹配稳定 10 倍。对标所有做 RAG 的项目,引入「精确 ID 引用」作为补充机制。
claude-mem vs 传统方案:能力对比
| 维度 | claude-mem | 传统「写笔记 + 喂上下文」 |
|---|---|---|
| 记忆自动沉淀 | ✅ 5 钩子全自动化 | ❌ 手工写 README / commit |
| 上下文注入 | ✅ SessionStart 自动注入 | ❌ 手工复制粘贴 |
| 搜索方式 | ✅ FTS5 + MCP 自然语言 | ✅ 关键词搜索 |
| 精准召回 | ✅ Citation observation ID | ❌ 无 ID 级引用 |
| 多会话追踪 | ✅ Multi-Prompt Sessions | ❌ 散落在不同 chat |
| 隐私控制 | ✅ <private> 标签排除 | ✅ gitignore / 加密 |
| 多 Provider 兜底 | ✅ Claude / Gemini / OpenRouter | ❌ 绑定单一模型 |
| 实时观察 | ✅ Web Viewer(localhost:37777) | ❌ 无 |
写在最后
claude-mem 解决的不是「AI 怎么记更多东西」,而是「AI 怎么让记忆变得可用」。它把记忆嵌入 AI 工作流的每一个关键节点,让 Claude 从「一次性助手」变成「长期协作者」。
过去 24 小时暴涨 534★ 不是因为它「炫技」,是因为大量用 Claude Code 的人都撞过同一个问题——「它不记得上会说了什么」。claude-mem 用一个插件 + 5 个钩子治好了这个病。
如果你想给 Claude / Cursor / Windsurf 装上持久化记忆,claude-mem 是目前最成熟的工程方案。