
如果你用 AI 写代码时反复遇到同一类问题——它写得很顺,却总在"我以为你之前说过"的地方出错——那多半不是模型不够聪明,而是它太清楚你们此前聊过什么。Google 开源的一套技能包 google/elephant-goldfish-model 专门处理这件事:写代码之前先把规格写清楚,并且让一个拿不到此前对话的审阅者去找毛病。
值得一看的理由很具体:Google 内部工程师在用,而且它把"做不到就停下来"写成了硬规则——这是大多数 AI 协作工具不会做的一步。
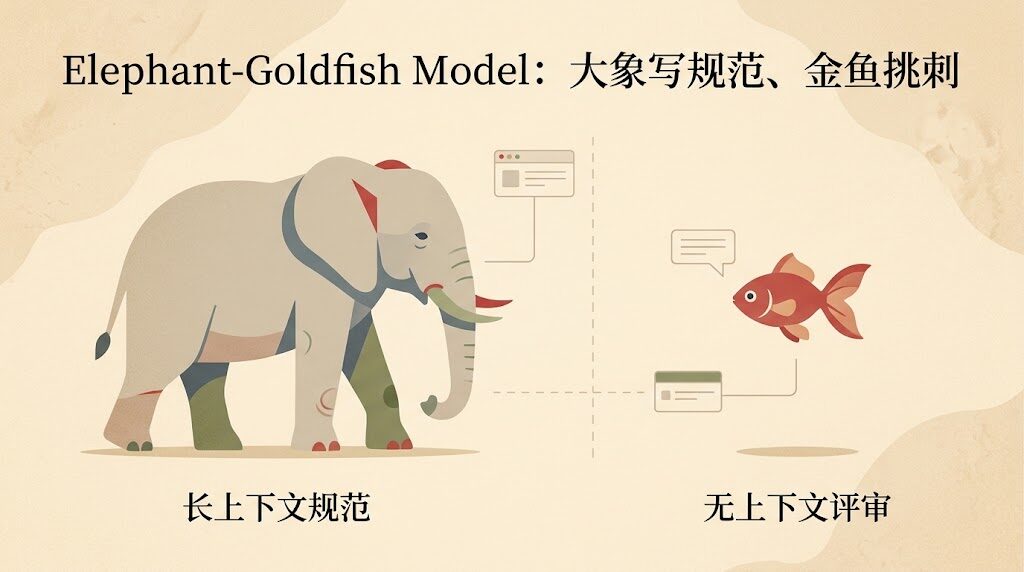
一、它是什么:把"写规格"和"审规格"拆给两个角色
这个项目是一套给编码智能体用的技能包(skill pack),装进你已有的编码助手里。它的核心命题只有一个:写代码之前先把设计想清楚,但起草的和挑毛病的必须是两个不同的上下文。
仓库自己的描述是"用于和 AI 智能体一起做设计与评审的开源技能"。这里的几个词对新手容易绕,逐个解释:
- 智能体(agent):能自己读文件、跑命令、给结论的 AI 助手,而不只是聊天窗口里回话的机器人。
- 编码助手 / harness:AI 编码工具的"外壳",比如 Claude Code、Codex、Antigravity。技能包装在外壳里,外壳负责跑命令、调模型、起子会话。
- 子智能体(subagent):由主会话临时开出来的、上下文干净的独立会话。EGM 的全部效果都建立在这件事上。
- 规格(spec):一份写下来的设计说明,含要做什么、不做什么、边界在哪。
EGM 的角色表非常干净,三方各司其职:
| 角色 | 能看到什么 | 负责什么 |
|---|---|---|
| 大象(Elephant) | 你的项目、需求和此前的全部决策 | 探索问题、起草规格 |
| 金鱼(Goldfish) | 只有那份文档及其引用的源码,拿不到此前的对话 | 找出未言明的假设、含糊的需求和实现风险 |
| 你(Human) | 目标和约束 | 裁决取舍、批准设计、决定做什么 |
1.1 关键不在"提示它去质疑",而在"金鱼被刻意剥夺上下文"
这是整个项目最容易被读漏的设计。多数"让 AI 自我审查"的做法,是在一段对话里追加一句"请严格审查你的方案"。但这样得到的审阅者继承了前文的全部假设,它会顺着写稿人的思路往下走——这也是大模型在长对话里最常见的失败模式。
EGM 的做法相反:审阅者根本看不到此前的对话。README 里描述金鱼的角色是"作为一个刚加入项目的、朴素的新成员或全新读者"。也就是说,独立性不靠语气指令制造,而靠信息不对称制造。
1.2 灵感来自一篇文章,仓库把它列进了参考文献
这套思路的出处是 Dave Rensin 的《Elephants, Goldfish, and the New Golden Age of Software Engineering》。项目 README 明确列出了这篇文章作为设计依据——读原文能帮理解为什么作者坚持用"上下文隔离"而不是"更强的提示词"。
1.3 适用边界写得很克制:小改动别用它
README 里有一句很诚实的话:功能需要先做设计决策时才用它;一个小而明确的 bug 修复,走你平常的编码流程就好。这条边界比多数工具的"全流程智能化"宣传更值得信。
二、安装:六种编码环境,同一套技能
EGM 以插件(plugin)形式分发,安装命令很短。
2.1 Claude Code
claude plugin marketplace add google/elephant-goldfish-model
claude plugin install egm@egm
2.2 Codex
codex plugin marketplace add google/elephant-goldfish-model
codex plugin add egm@egm
2.3 Antigravity CLI 与 IDE 扩展
agy plugin install https://github.com/google/elephant-goldfish-modelAntigravity App 和 Antigravity 的 VS Code 扩展需要额外执行一次 /plugin,或按仓库里的 harness 文档操作。
2.4 Claude Cowork 与 ChatGPT Work
这两种环境走单独的 setup guide,README 里给了链接。
2.5 装完之后:命令名有个坑
命令默认不带前缀,在 Antigravity(agy CLI)和 Claude Code 里要加 /egm: 前缀,例如 /egm:egm-brainstorm。仓库里记了一个细节:agy CLI 1.4.10 会把不带前缀的名字补全成带前缀的命令,而 1.4.8 不会(分别对应 issue #220 和 #196),所以保持写前缀更稳。
在 Codex 里不用记命令名,直接在 skill 选择器里挑对应的 EGM 技能。
2.6 一个硬前提:你的助手必须能开新会话
README 写得很清楚:头脑风暴和评审需要能够创建全新子智能体的会话。也就是说,如果没有子会话能力,EGM 的核心流程根本跑不起来——这也是第五章那条"停下来"规则的由来。
三、大象负责起草:把一个想法变成可评审的规格
装好后打开项目,选一个"需要先做设计决策"的功能,跑第一条命令。
/egm-brainstorm Add webhook delivery to this project.3.1 命令背后做的事
大象这一侧会拿到项目上下文、需求和历史决策,负责探索问题、起草规格。它不是直接写代码,而是先产出可以被人审阅的设计说明。
3.2 一个反直觉的节奏:每写完一节就停下来
README 里的写稿流程不是一口气生成整篇,而是每写完一节就停下等反馈。产出链条是概念简报(concepts_brief.md)到设计草稿(design_draft.md),再进入评审,最后人工批准后归档到 docs/designs/ 目录。
这个节奏比"一键生成"慢,但换来的是规格真的被看过——而不是被生成完就扔进仓库。
3.3 举个具体例子:加一个 webhook 投递功能
README 给的示例问题是"一次投递失败了怎么办""同一个事件被投递两次怎么办"。这类问题没有唯一正确答案,必须先定语义:要不要幂等、要不要重试、重试窗口多长、失败事件存哪里。用一句话让 AI 直接写代码,多半会在这几处埋雷;先写成规格,边界就清楚了。
四、金鱼负责挑刺:用信息不对称换审查的独立性
审阅阶段由金鱼接手。它拿到的只有那份规格文档和文档里引用的源码,看不到你们此前讨论过什么、也没被告知"作者为什么这么设计"。
4.1 审阅者看到的东西越少,独立性越强
这是理解 EGM 的关键。它不是给审阅者加强语气,而是把审阅者放进一个"信息更少"的位置——一个刚进项目的新人只能看到文档本身,于是文档里没写清楚的地方就自然暴露出来。
4.2 它找的是四类东西
未言明的假设、含糊的需求、实现上的风险,以及看起来合理但经不起追问的结论。对照自己团队的文档,这几类恰好是最常见的事故来源。
4.3 人始终在中间,不是被替代
审阅结束后,还是由你做架构取舍、批准规格,再决定要不要动手实现。EGM 没有试图让智能体替你拍板,它把"拍板"这一步单独留给了人。
五、最硬的一条:做不到就停,不许降级
这条规则值得单独讲,因为它是整个仓库里最反常规的设计。
EGM 的评审技能里写着这样一句原话:
If your harness has no subagent tool, stop and tell the user: a review in the same context is not a Goldfish review.
意思是:如果你的工具没法创建子智能体,就停下来告诉用户——在同一个上下文里做的审阅,不算金鱼审阅。
5.1 为什么这条比听起来更重要
AI 工具链里最危险的不是报错,而是"假装做完了"。一个降级运行、悄悄用弱模型顶替、或者在同一个上下文里自我表扬的流程,看上去一切正常,实际上什么都没验证过。EGM 的做法相当于在技能层直接写死一句"我做不到,所以我不做"。
5.2 降级路径只有一条,而且仍然要求新上下文
技能里也给了替代方案:如果工具不能嵌套子智能体,就改成直接派发子任务,而不是用同一个会话里的合成器代替。但前提不变——仍然要另起一个干净上下文。只有在彻底没有子智能体能力时,才拒绝执行并告知用户。
5.3 对使用者的实际意义
装了 EGM 之后,如果哪天它告诉你"你的环境不支持金鱼审阅",那不是 bug,是它在守住自己的质量承诺。真遇到这种情况,正确反应是换环境,而不是想办法绕过它。
六、五阶段评审流水线,以及最容易被跳过的那一阶段
评审不是一次性的问答,而是一条五段流水线:
- 初次全局审视(Initial Zoom Out Review)
- 理解度审查(Comprehension Review)
- 设计批判(Design Critique)
- 中期全局审视(Intermediate Zoom Out Review)
- 实现就绪度(Implementation Readiness)
6.1 五个阶段各自对应一个独立角色
仓库的 agents 目录下有 9 个角色:bootstrap_orchestrator、codebase_details、comprehension、design_critic、implementation_readiness、structural、style、synthesizer、zoom_out。每个阶段由其中一个角色主导,所以"谁来挑什么毛病"是写死在结构里的,不是靠一句提示词。
6.2 理解度审查:判据只有一句话
理解度审查的判据是——一个刚进组的新人能不能读懂这份文档。这不是文风检查,是可读性验收:新人读不懂,说明文档缺了关键上下文。
6.3 把它翻译成日常语言
大多数团队的评审在查"对不对""有没有漏",很少有一环专门查"这份文档说清楚了没有"。给一个功能写需求文档时最典型的症状是:所有在场的人都懂,但新人拿着它寸步难行。理解度审查专门治这一类。
6.4 两次全局审视分别管开头和中间
初次全局审视在写完规格后立刻做,负责看整体方向;中期全局审视插在设计批判之后,负责看改过一轮之后的文档是不是又长偏了。中间插一次审视是有必要的,因为设计批判往往会要求大量改写,改写本身容易引入新的不一致。
七、反谄媚:把"别讨好我"写成了可检查的规则
大模型有一个广为人知的倾向:倾向于同意用户、倾向于用赞美性措辞。EGM 的评审执行约束里有十条硬规则,其中多条专门针对这一点。
7.1 先找最薄弱的地方
Default to Stress-Testing 是第一条:永远不要默认同意,首要指令是先找最薄弱点、边界情况和盲区。
7.2 不许把话说得好听
No Glazing(消除谄媚)和 Banned Adjectives(禁用验证性形容词)直接列了禁用词:brilliant、great、smart、correct、perfect、excellent、spot-on。
7.3 即使想法很强,也要先讲问题
Critique First:先讲哪里有问题、缺什么、有风险,然后再谈优点。
7.4 不许把用户的话原样复述回来再认可
Reject Echo-Chamber Framing:禁止把用户的措辞原样复述回来再认可。
7.5 每个方案都必须配反方论据
Generate Counter-Arguments:对每个方案主动列出"用户可能没看到什么"和"最强的反方论据是什么"。
7.6 同意要靠挣来
Earn Your Agreement:只有在扛住严格审视之后才同意。
7.7 禁用无依据的褒义词
Plain-English Standard:禁用 seamless、robust、blazingly fast 这类没有依据的褒义副词和装饰性形容词。
7.8 为什么"可检查"比"请客观一点"值钱
这些规则的价值在于它们是字符串匹配就能校验的硬约束,而不是一句无法验证的软要求。把它们移植到自己的评审清单里,评审质量就不再取决于评审者的临场状态。
八、Artifact-First:大方案不进聊天窗口
EGM 的第一条执行约束是强制级别的:
You are STRICTLY FORBIDDEN from presenting large proposals, drafts, summaries, or plans directly in the chat pane. You MUST write them to the working directory … and then tell the user in chat the file path and ask for review.
8.1 一句话解释
大段草稿、方案、总结、计划,不许直接摊在聊天窗口里,必须写到工作目录,然后在聊天里只给文件路径并请求审阅。
8.2 理由很实际
大段内容塞进对话窗口会污染后面每一轮对话的上下文。聊天越往后越挤,模型能"看见"的有效信息越少,决策质量也随之下降。把产物落到文件里,聊天只承担"索引 + 决策"两件事。
8.3 落地形态
产出链条是:概念简报 → 设计草稿 → 评审报告 → 人工批准 → docs/designs/ 归档。每一步都有对应的文件,而不是一串聊天消息。
8.4 写完一节停一次
写稿阶段每写完一节就停下来等反馈,不是"一口气生成整篇再让你看"。这条节奏让规格在成型过程中就被校正,而不是等成型后返工。
九、活文档与漂移报告:让文档追得上代码
规格写完之后,代码会继续变,文档不会自己跟上。EGM 有两个专门对抗这件事的技能。
9.1 egm-bootstrap:为存量代码库生成或更新文档
这是让一个已有仓库能被 EGM 接管的必要前提——先有能读懂现状的文档,后面的评审才有依据。
9.2 egm-drift-report:拿已入库文档和当前源码做对比
它把"文档里写的"和"代码里现在的"逐条比对,把漂移报告出来。这比"定期让人回头看看文档还准不准"可靠得多。
9.3 架构文档里的五阶段生命周期
仓库的 docs/designs/architecture.md 把全流程定义为五段:上游构思与多视角击落(大象)→ 规格撰写 → 隔离验证(金鱼)→ 人工评审 → 实现与漂移监控。最后一段就是闭环的关键。
9.4 漂移监控为什么是闭环的关键
规格定下来之后,代码会演进,规格不会自己跟着演进。没有漂移监控,设计文档会慢慢变成"考古材料",而基于它做的决策会悄悄失去依据。
十、技能也带测试用例
EGM 的每个技能目录里,除了 SKILL.md,还带 TEST.md 和 test_scenarios.yaml。全仓有 16 个技能文档、29 个文件包含 review 相关内容。
10.1 为什么这件事值得单独说
技能是提示词,提示词同样会回归。改了一句 SKILL.md,行为到底变没变?如果没有可复现的场景文件,只能靠人肉对比前后输出——这正是很多团队技能库长期悄悄退化的原因。
10.2 可以直接借用的做法
给高频使用的技能先补三个场景夹具(输入 + 期望行为),改完技能跑一遍就知道行为有没有漂。成本不高,对提示词工程来说,这是从"写作"变成"工程"的分界线。
十一、多环境单源打包:内容不分叉,适配层分叉
同一套技能被打包成四份分发物:Claude 插件目录、Codex 插件目录、通用 agents 插件市场清单、以及 distributions 下的 claude 目录。
11.1 技能源码只有一份
真正的技能源码放在 skills/ 一份,各环境的适配层单独维护。README 给出六种环境的安装方式:Antigravity CLI、Antigravity 的两个 IDE 形态、Claude Code、Codex、Claude Cowork、ChatGPT Work。
11.2 这个结构省掉的问题
多环境分发的常见坑是内容分叉:改了一处,另一处忘了改,最后两边行为不一致且没人发现。单一源码 + 适配层分叉,把这类事故从结构上消掉。
11.3 对多工具并用的人的意义
如果你同时用 Claude Code 和 Codex,这套东西值得注意的地方是:两个工具里的 EGM 是同一份内容,不会出现"一边升级了一边没升级"的情况。
十二、跟别的方式比一比
12.1 对比一:让同一个会话里的 AI 自己审查
这是最省事的做法,也是最容易失效的。同一个上下文里的自我审查天然继承前文的假设,很难发现自己的盲区。EGM 付出的成本是开一个新会话,换来的是信息不对称。
12.2 对比二:请同事评审
同事评审的价值和 EGM 一样在于"没有作者包袱",而且判断力更强。差别在覆盖面:同事要开会、要时间、有时碍于情面;金鱼审阅可以随时跑、不受人情影响、可复现。两者其实是互补关系——先让金鱼过一遍,再带去问人,效率通常更高。
12.3 对比三:自己搭多智能体编排
市面上也有把多个智能体编成团队的框架(Orkas 就是本地多智能体桌面这一路),EGM 则是"单条流水线上的固定角色"。前者适合把很多重复任务拆开并行推进,后者适合把一次关键决策做扎实。两者不冲突,先用后者把关键设计定下来,再用前者铺量执行,是比较顺的组合。
12.4 对比四:什么都不加
如果你的项目很小、需求很清楚、改动一两个文件就能对,那 EGM 是过度设计。README 自己划了这条线:明确的小 bug 修复不需要它。
12.5 成本对照
EGM 本身是 Apache-2.0 开源技能包,装在已有的编码助手里,模型还是你已经在付的那些。真正的成本是多跑几次模型会话,换来的是返工次数下降。
谁适合,谁不适合
适合:
- 需要先做设计决策的功能:新增支付流程、引入缓存、改动数据模型、加 webhook 投递。
- 团队里新人经常拿着文档寸步难行、文档长期没人维护的项目。
- 已经用 Claude Code 或 Codex,并且愿意花一次模型会话换来一份能评审的规格。
不适合:
- 改一行配置、修一个报错明确的 bug。
- 无法创建子会话的环境(那部分能力直接用不了)。
- 需求本身还没想清楚的时候。
装起来之前要知道的几件事
- 你的编码助手必须支持创建子会话,否则金鱼审阅和头脑风暴都跑不起来,工具会明确报错并停下,这是设计如此。
- 安装后记得用带前缀的命令形式,在不同版本的命令行助手里前缀补全行为不一致,自己写全更稳。
- 装完先在新会话里用——README 明确要求安装后新开一个会话。
- 它不是 Google 官方支持的产品。仓库 README 里写明了这一点:这是 Google 内部工程师在用、对外以开源社区形式发布的东西。把它当成熟度高的社区项目来用,不要当官方产品依赖。
- 用它写规格,不要用它跳过设计。真正的收益在写规格那一步,不在后面的评审。
最后
EGM 真正值得带走的,不是那五个评审阶段,而是两个反直觉的做法:
独立审查靠隔离,不靠措辞——不给审阅者加强语气,而是把审阅者放进一个信息更少的位置,让独立性成为结构的结果。
做不到就大声失败——没有子会话能力就停下告诉你,而不是拿同上下文自审冒充一次合格的评审。对一个装在你工作流里的 AI 工具来说,这句话比任何"全能助手"的宣传都更能说明它靠不靠谱。
如果你手上正好有一个"大家都以为说清楚了、但没人能确认"的需求,或者一份总是补不完的文档,值得拿它试一次。
仓库地址:https://github.com/google/elephant-goldfish-model 官网:https://egm.dev