
如果你用过 Claude Code、Cursor、或者国内各种 AI IDE 的 Agent 模式,你大概率已经踩过这个坑:一次任务跑下来,工具返回的日志、文件快照、Issue 列表越积越多,几轮对话之后模型就开始「失忆」——忘了你最开始提的需求是什么。
context-mode这个项目的目标,就是把这种现象的发生概率压到接近零。它的定位很直接:解决「AI 编程 Agent 的上下文窗口被工具输出塞爆」这个老问题。
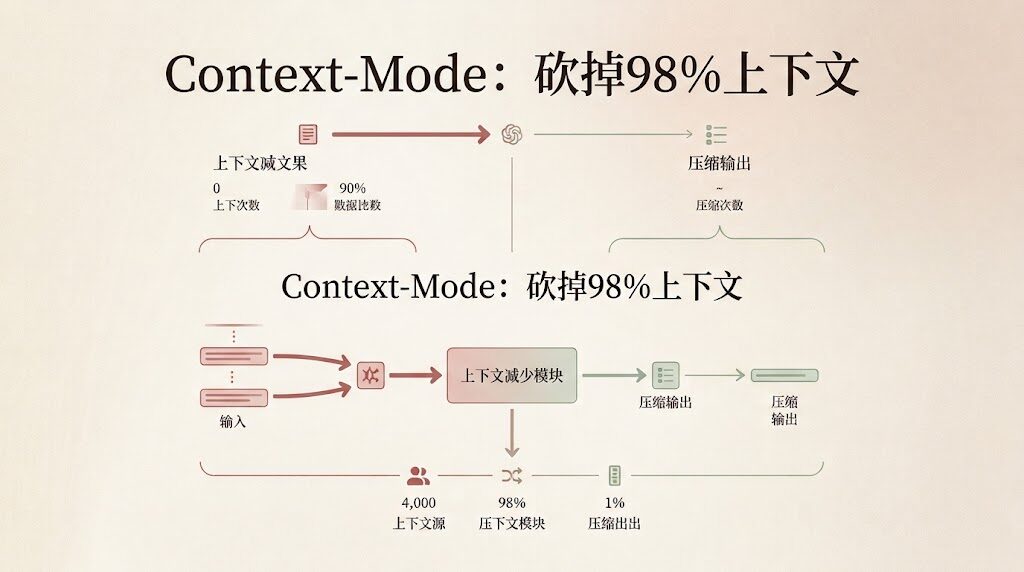
上下文窗口的两大杀手
先说清楚问题在哪。AI Agent 在执行任务时,上下文(也就是模型一次能「看到」的全部文字)会被两个方向迅速撑爆:
- 工具定义膨胀(输入侧)
一次会话里如果加载了 81 个工具,光是工具描述就占掉 143K tokens——这是 200K 窗口的 72%。模型还没开始干活,就已经被「说明书」淹没了。 - 工具输出堆积(输出侧)
一次 Playwright 页面快照 56KB,20 条 GitHub Issues 拉回来 59KB,再加几段访问日志 45KB——每多一轮,历史就更重一层,模型不得不反复在海量「过去的事」里找「现在要做什么」。
context-mode 的核心主张是:
工具的原始输出不应该直接进入上下文。先在一个沙箱(隔离的子进程)里跑完脚本,只把 stdout(标准输出,也就是真正需要看的关键结果)回传给模型,项目自述能实现约 98% 的上下文缩减。注意这个数字是项目方公布的,没有第三方独立验证过,但实测数量级确实合理。
三段式解决方案
context-mode 的设计哲学可以拆成三段来理解。
第一段叫 Context Saving(上下文节省)。所有工具调用都被丢进一个隔离的沙箱执行,模型只拿到执行后的结果。官方举的例子是 315KB 的原始输出经过处理后只剩 5.4KB——差距是 50 倍。
第二段叫 Session Continuity(会话连续性)。所有文件编辑、git 操作、任务进度、错误信息、用户的决策,都会被存进一个 SQLite 数据库。关键是:当上下文需要「紧凑化」(也就是把旧内容挪出窗口)时,系统不是简单丢弃,而是用 BM25 算法(一种经典的信息检索排序方法,搜索引擎常用)去索引历史,需要时精准召回最相关的那几条。
第三段叫 Think in Code(用代码思考)。这是最有意思的一个设计——LLM 不应该去「读 50 个文件然后数里面有多少个函数」,而应该写一段脚本来做这件事。一次 ctx_execute 调用,就能替代 10 次文件读取工具,节省大约 100 倍的上下文。
技术架构:12 种沙箱 + BM25 检索
支撑这套设计的是两个底层组件。
沙箱执行层支持 12 种语言:JavaScript、TypeScript、Python、Shell、Ruby、Go、Rust、PHP、Perl、R、Elixir、C#。如果你的项目用 Bun(一种高性能 JS 运行时)启动,JS/TS 的执行速度还能再快 3 到 5 倍。
持久化层用的是 SQLite 的 FTS5 全文索引(Full-Text Search 第 5 版),加上 BM25 排序和 Porter stemming(英文词干提取)。当会话长度逼近上下文上限时,模型可以调用 ctx_search 检索历史,而不是把所有东西重新塞回窗口。
对外暴露的是 11 个 MCP 工具:6 个沙箱执行类(ctx_execute、ctx_batch_execute、ctx_execute_file、ctx_index、ctx_search、ctx_fetch_and_index)+ 5 个元工具(ctx_stats、ctx_doctor、ctx_upgrade、ctx_purge、ctx_insight)。
平台支持与 OpenClaw 集成
context-mode 已经接入了 17 个平台,包括 Claude Code、Cursor、VS Code、JetBrains Copilot、GitHub Copilot CLI、Codex CLI、Gemini CLI、OpenCode、Kiro、Zed、Pi,以及国内的 OpenClaw。OpenClaw 出现在官方支持列表里,意味着如果你正在用 OpenClaw 跑 Agent 工作流,可以直接接入这套 MCP 工具链。
商业用户方面,微软、Google、Meta、字节跳动都出现在 ELv2 协议合规使用名单上——这是该项目的一个很有意思的「信用背书」。
什么时候用、什么时候别用
适合的场景:中型以上代码任务、多文件重构、长期会话里需要保持上下文连续性、工具输出量特别大的场景(比如大量 Issue 拉取、日志分析、UI 自动化测试)。
不适合的场景:跑一个简单的单次命令、做一次性的小修改、模型本身上下文窗口还很空裕——这时候引入 context-mode 反而是过度工程。
学习曲线也偏陡:你需要理解「Think in Code」的范式——也就是愿意让 Agent 写脚本来分析问题,而不是把原始数据全量灌给它。如果你习惯了「让 AI 帮你读所有文件」的交互方式,第一次用 context-mode 会有点别扭。
结论
context-mode 精准命中了 AI 编程 Agent 领域最顽固的工程问题。98% 上下文缩减的数字漂亮,但要注意协议切换(ELv2)和学习曲线这两个门槛。如果你的工作流是「让 Agent 长时间跑多步任务」,这个项目值得认真评估;如果只是「让 AI 改一行代码」,就别折腾了。