
快速落地方法:
本文及本站大部分openclaw相关文章,都可以让Openclaw agent阅读,然后进行应用,参考Prompt如下:
请阅读这篇文章:
https://www.aiec.fun/%e5%8d%a1%e5%b8%95%e8%a5%bf-llmwiki-%e7%90%86%e5%bf%b5%e7%9a%84%e7%bb%88%e6%9e%81%e5%ae%9e%e7%8e%b0-openclaw-%e6%9c%80%e5%bc%ba%e8%ae%b0%e5%bf%86%e7%b3%bb%e7%bb%9fgbrain%e8%af%a6%e8%a7%a3/
分析有哪些内容,对我们优化工作流程有价值。并严格根据openclaw最新官方文档、GBrain的官方文档进行核对,排除错误及过时信息,制定落地计划,安装和部署GBrain。详细方法,参考文章 >>>
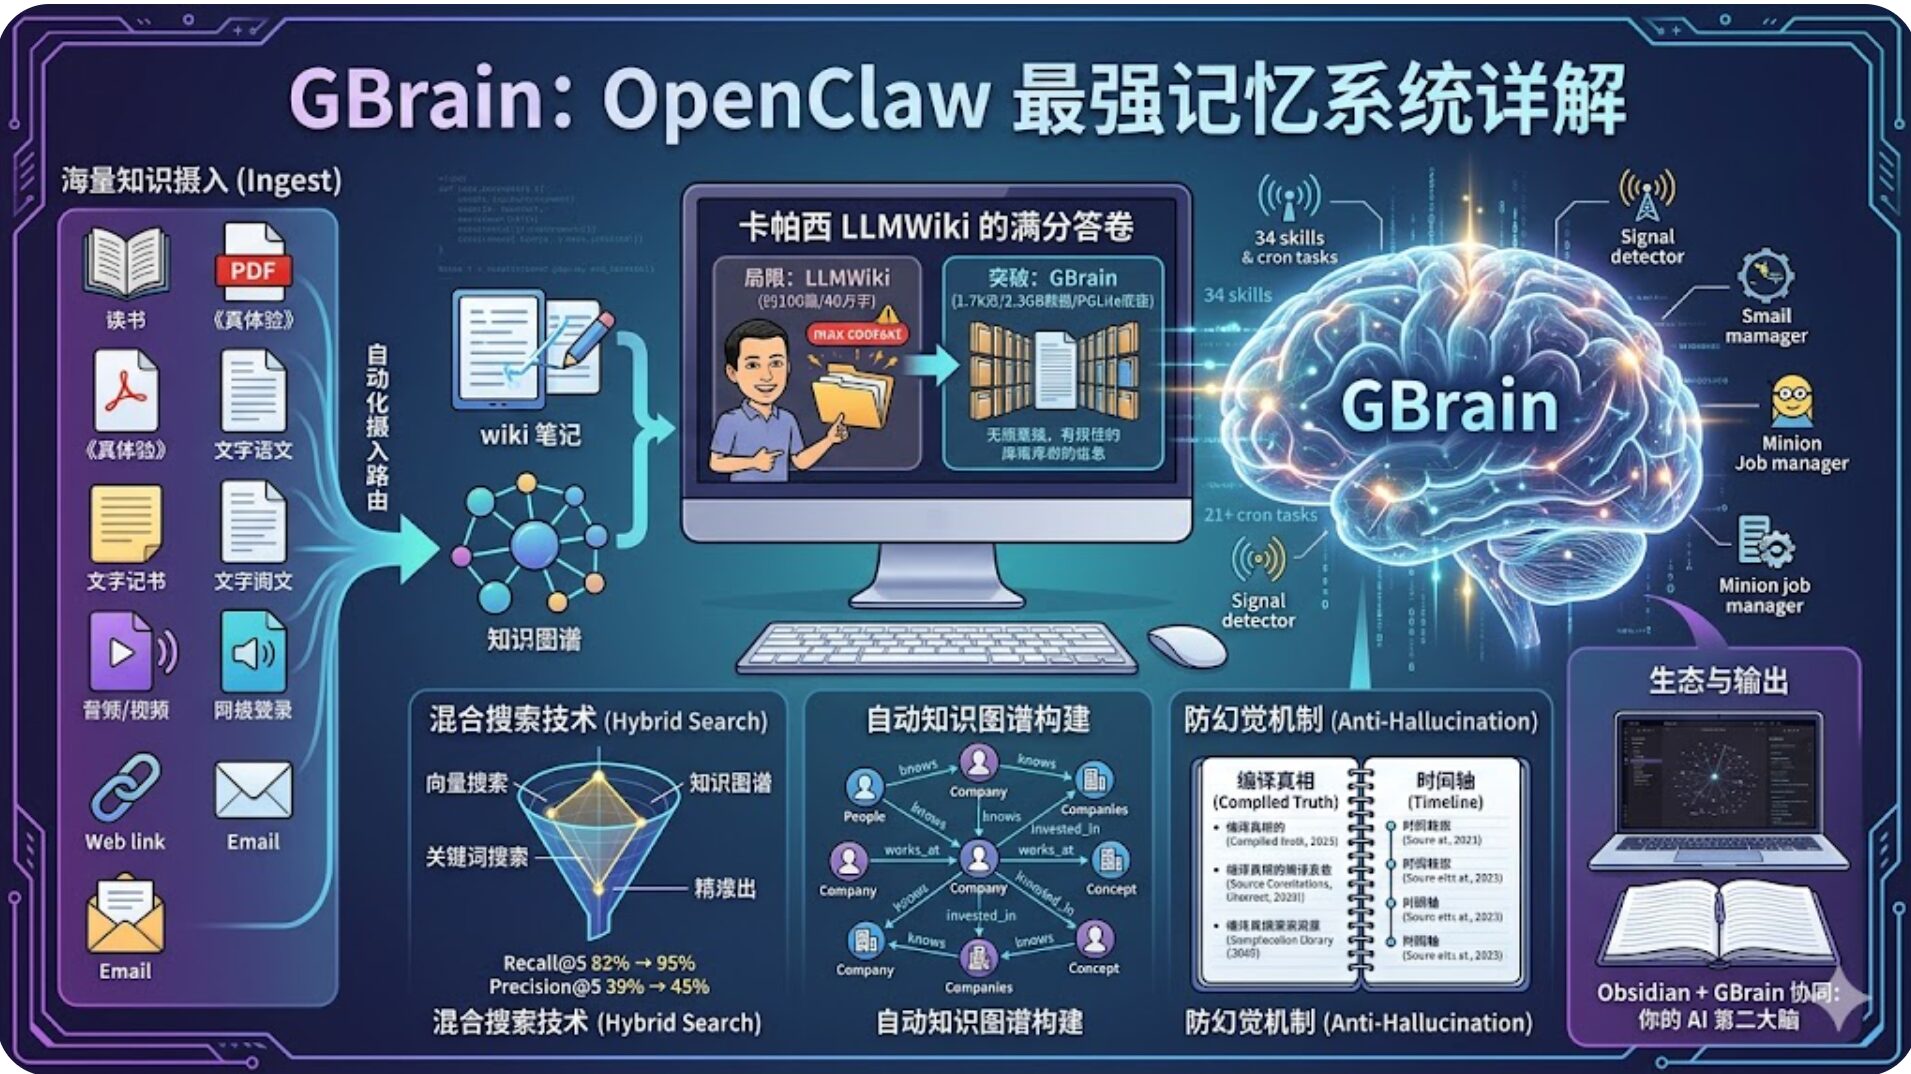
2026 年 4 月,Y Combinator 总裁 Garry Tan(陈嘉里)开源了一个震撼 AI 社区的项目 ——GBrain(GitHub 仓库:garrytan/gbrain,截至 2026 年 5 月已突破 10.1k Stars)。这是一个专为 OpenClaw 和 Hermes Agent 打造的生产级个人知识大脑系统,被公认为是 Andrej Karpathy(卡帕西)LLMWiki 理念的 "满分答卷"。
卡帕西的 LLMWiki 理念优雅地展示了如何让 AI 管理个人知识库,但在处理大规模数据时存在明显局限。Garry Tan 指出,卡帕西依赖 index.md 目录的方案在处理约 100 篇文章(40 万字左右)时效果很好,但当知识库规模达到他个人的 17,888 个页面、4,383 个人物、723 家公司和 2.3GB 数据时,纯文本目录方式会彻底撑爆大模型的上下文窗口。
GBrain 完美解决了这一问题。它采用 Postgres/PGLite 作为存储底座,v0.26.8 版本内置 34 个独立技能和 21 + 个定时任务,能够自动摄入、组织、检索和维护海量知识,让你的 AI 代理真正拥有 "永不遗忘" 的大脑。
一、GBrain 的核心作用与设计理念
1.1 解决的核心问题
传统 RAG 和 LLMWiki 方案的三大痛点:
- 上下文窗口限制:无法处理超过模型上下文长度的知识库
- 检索精度不足:单一向量搜索难以捕捉实体间的复杂关系
- 维护成本高:需要手动整理目录、修复链接、更新索引
- 幻觉问题:缺乏可靠的溯源机制,容易生成虚假信息
1.2 四大核心工作流
GBrain 将卡帕西的理念系统化,提炼为四个自动化步骤:
- 准备:初始化数据库和目录结构,配置 API 密钥
- Ingest(摄入):将各种格式的资料转化为结构化的 wiki 笔记并构建知识图谱
- Query(查询):通过混合搜索从海量笔记中精准提取答案
- Lint(维护):定时自动清理孤立页面、修复断链、优化索引
1.3 设计哲学
- "Thin harness, fat skills":智能存在于技能中,而非运行时
- 大脑优先原则:任何外部 API 调用前必须先查询本地大脑
- 只追加不修改:所有原始证据永久保存,支持完整溯源
- 自动复利:系统在后台持续学习和优化,越用越聪明
二、GBrain 的技术架构与核心优势
2.1 整体架构
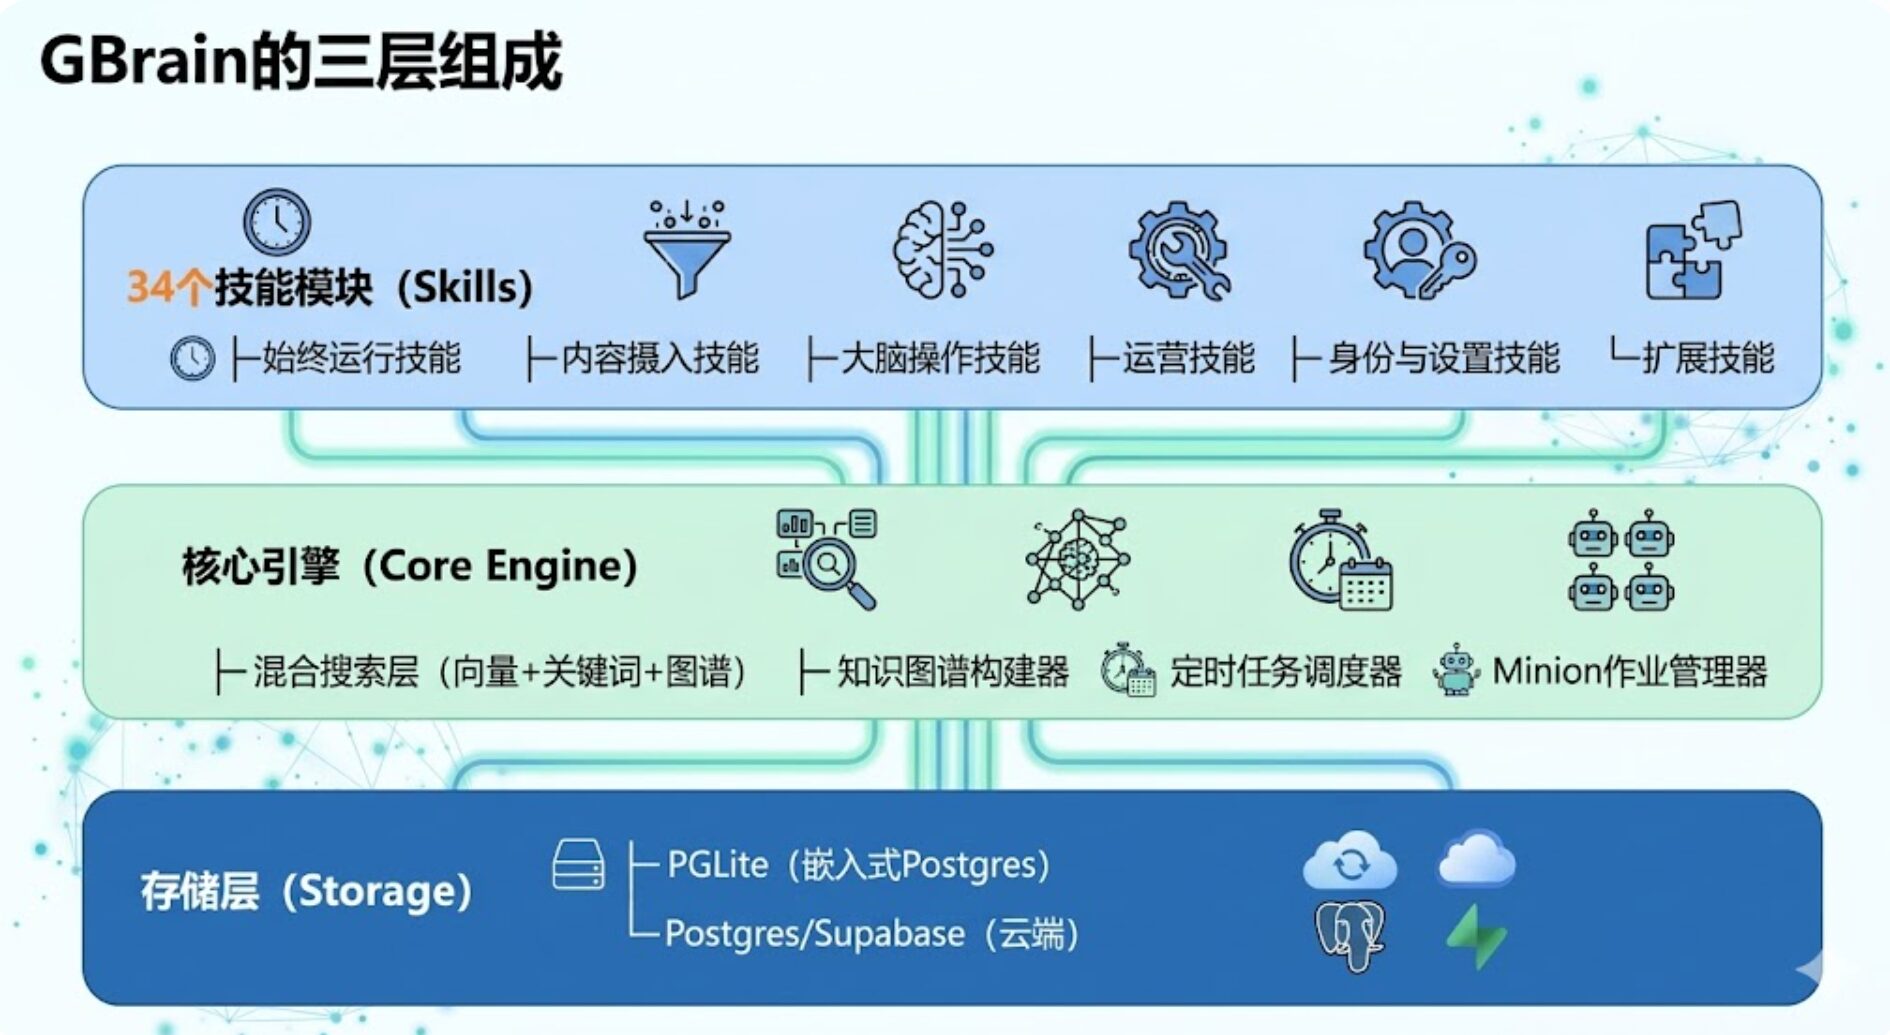
GBrain 采用模块化设计,主要由三层组成:
2.2 双引擎存储架构
GBrain 采用可插拔、双向迁移的存储引擎,兼顾本地轻量与云端扩展:
迁移命令:
gbrain migrate --to supabase|pglite2.3 核心优势
- 超大规模支持:轻松处理数万页笔记和数百万实体关系
- 混合搜索技术:向量搜索 + 关键词搜索 + 知识图谱搜索三重融合,Recall@5 从 83% 提升至 95%,Precision@5 从 39% 提升至 45%
- 自动知识图谱:零 LLM 调用自动提取实体关系,构建 typed links(knows, works_at, invested_in 等)
- 防幻觉结构:"编译真相 + 时间轴" 双栏设计,强制溯源机制
- 后台自动维护:Dream Cycle 夜间自动清理、修复和优化知识库
- Minion 作业系统:Postgres 原生作业队列,支持长任务后台执行,永不丢失工作
三、安装方法
GBrain 提供了多种安装方式,其中AI 代理一键安装是最推荐的方法,无需任何技术背景。
3.1 前置条件
- 已安装 OpenClaw 或 Hermes Agent
- Node.js 和 Git(部分安装方式需要)
- 笔记软件(如 Obsidian,支持 Wikilinks 语法)
- OpenAI API Key(必需,用于向量搜索,除非使用纯全文搜索模式)
- Anthropic API Key(可选,提升搜索质量)
3.2 一键安装法(强烈推荐)
这是最简单的安装方式,整个过程由 AI 代理自动完成,大约需要 30 分钟。
步骤:
- 打开你的 OpenClaw 或 Hermes Agent 聊天窗口
- 复制粘贴以下命令并发送:
Retrieve and follow the instructions at:
https://raw.githubusercontent.com/garrytan/gbrain/master/INSTALL_FOR_AGENTS.md- 按照 AI 的提示输入必要的 API 密钥
- 等待安装完成(约 30 分钟)
安装过程中 AI 会自动完成:
- 克隆 GitHub 仓库
- 安装 Bun 运行时和所有依赖
- 初始化 PGLite 数据库
- 加载全部 34 个技能
- 配置定时任务
- 运行健康检查
3.3 手动 CLI 安装法(无代理)
如果你想手动控制安装过程,可以使用 CLI 方式:
# 克隆仓库并安装
git clone https://github.com/garrytan/gbrain.git ~/gbrain && cd ~/gbrain
curl -fsSL https://bun.sh/install | bash
export PATH="$HOME/.bun/bin:$PATH"
bun install && bun link

# 验证安装
gbrain --version

# 初始化大脑(PGLite,无服务器)
gbrain init
gbrain doctor --json  # 验证所有检查通过

# 创建大脑仓库
mkdir -p ~/brain && cd ~/brain && git init

# 导入现有笔记
gbrain import ~/brain/ --no-embed
gbrain embed --stale  # 生成向量嵌入
3.4 MCP 服务器安装法(支持 Claude Code、Cursor 等)
GBrain 可以作为 MCP(Model Context Protocol)服务器,为各种 AI 编辑器提供记忆能力:
{
  "mcpServers": {
    "gbrain": { "command": "gbrain", "args": ["serve"] }
  }
}
将上述配置添加到:
- Claude Code:
~/.claude/server.json - Cursor:Settings > MCP Servers
- Windsurf:相应的 MCP 配置界面
四、详细配置方法
4.1 必要的 API 配置
创建~/.gbrain/.env文件,添加以下内容:
# 必需:用于向量搜索和嵌入生成(除非使用纯全文搜索模式)
OPENAI_API_KEY=sk-...

# 可选:提升查询扩展和搜索质量
ANTHROPIC_API_KEY=sk-ant-...

# 可选:Supabase数据库配置(如果使用云端存储)
DATABASE_URL=postgresql://...
4.2 大脑目录结构
GBrain 推荐使用以下 MECE(相互独立、完全穷尽)的目录结构,将其创建在你的大脑仓库(如~/brain)中:
~/brain/
├── people/          # 人物档案
├── companies/       # 公司档案
├── concepts/        # 概念和想法
├── meetings/        # 会议纪要
├── media/           # 音视频和PDF笔记
├── tasks/           # 任务管理
├── reports/         # 生成的报告
└── inbox/           # 待处理的内容
4.3 定时任务配置
GBrain 的自动维护功能依赖定时任务,根据你的平台进行配置:
OpenClaw Cron 配置:
# 每15分钟同步一次文件系统并嵌入新内容
*/15 * * * * gbrain sync --repo ~/brain && gbrain embed --stale

# 每天凌晨2点运行Dream Cycle(记忆整理和优化)
0 2 * * * gbrain maintain --full && gbrain citation-fixer --all

# 每周日凌晨3点运行完整健康检查
0 3 * * 0 gbrain doctor --json && gbrain embed --stale

# 每天检查更新(不会自动安装)
0 4 * * * gbrain check-update --json
4.4 高级配置选项
编辑~/.gbrain/config.json进行高级配置:
{
  "brain": {
    "path": "~/brain",
    "default_engine": "pglite",
    "embedding_model": "text-embedding-3-small",
    "chunk_size": 512,
    "chunk_overlap": 50
  },
  "search": {
    "hybrid_weight": 0.7,
    "vector_weight": 0.5,
    "keyword_weight": 0.3,
    "graph_weight": 0.2,
    "backlink_boost": 2.0
  },
  "cron": {
    "quiet_hours": [22, 6],
    "timezone": "Asia/Shanghai"
  }
}
五、核心技能与使用方法
GBrain 内置 34 个精心设计的技能,覆盖知识管理的全流程。这些技能以 Markdown 文件形式存在,编码了完整的工作流程和质量标准。
5.1 始终运行的核心技能
这两个技能在后台持续运行,是 GBrain 的 "神经系统":
1. signal-detector(信号检测器)
- 作用:在每条消息上触发,并行运行一个轻量模型捕捉原始想法和实体提及
- 特点:从不阻塞主线程,让大脑自动复利增长
- 效果:你与 AI 的每一次对话都会被自动分析,重要信息会被提取并添加到知识库
2. brain-ops(大脑操作)
- 作用:强制要求 AI 在调用任何外部 API(如 Google 搜索)之前,必须先查阅本地大脑
- 工作流:读取→丰富→写入,确保每次响应都基于你的个人知识
- 意义:让 AI 真正成为你的 "第二大脑",而不是通用搜索引擎
5.2 内容摄入技能(Ingest)
摄入技能负责将各种格式的外部信息转化为结构化的大脑页面。
1. ingest(摄入路由器)
- 作用:自动检测输入类型并委派给相应的专用摄入技能
- 支持类型:文章、链接、推文、PDF、音视频、会议纪要、GitHub 仓库等
2. idea-ingest(想法摄入)
- 作用:处理文章、链接、推文等文本内容
- 功能:生成分析摘要、创建作者人物页面、自动交叉链接相关概念
- 使用示例:
请阅读这篇文章并提取核心观点到我的大脑中:https://example.com/article3. media-ingest(媒体摄入)
- 作用:处理视频、音频、PDF、书籍、截图等多媒体内容
- 功能:自动转录、提取实体信息、生成时间戳、传播反向链接
- 使用示例:plaintext
请观看这个YouTube视频并总结关键要点:https://youtube.com/watch?v=xxx
4. meeting-ingestion(会议摄入)
- 作用:处理会议纪要和转录文本
- 功能:为每位参会者创建 / 更新档案、为每家公司添加时间线条目、提取行动项
- 使用示例:
这是今天的会议纪要,请帮我整理到大脑中并为参会者建立档案。5.3 大脑操作技能
1. enrich(实体丰富)
- 作用:分层级丰富人物和公司信息
- 分级机制:
- Tier 3:首次提及,创建存根页面
- Tier 2:3 次以上不同来源提及,进行网络和社交信息丰富
- Tier 1:会议或 8 次以上提及,运行完整丰富管道
- 特点:自动升级,无需人工干预
2. query(查询)
- 作用:执行三层混合搜索并生成带引用的综合答案
- 特点:当大脑中没有相关信息时,会明确说明 "大脑中没有关于 X 的信息",而不是幻觉
- 使用示例:
我过去三个月关于AI Agent的笔记有哪些共同主题?3. data-research(数据研究)
- 作用:使用参数化 YAML 配方进行结构化数据提取
- 功能:从邮件、笔记中提取投资者更新、费用、公司指标等结构化数据
- 使用示例:
帮我从过去一年的邮件中提取所有公司的MRR数据并生成表格。4. maintain(维护)
- 作用:定期检查大脑健康状况
- 功能:识别过时页面、孤立页面、死链接、引用问题、标签不一致等
- 运行频率:建议每天夜间运行一次
5.4 运营技能
1. cron-scheduler(定时调度器)
- 作用:管理所有定时任务
- 特点:支持错开调度(5 分钟偏移)、安静时段(时区感知)、幂等性执行
- 任务数量:内置 21 + 个定时任务,具体数量以
gbrain doctor输出为准
2. minion-orchestrator(Minion 编排器)
- 作用:将长时间运行的代理任务作为后台作业执行
- 优势:
- 生存网关重启
- 流式传输进度
- 支持暂停 / 恢复 / 中途引导
- 零额外基础设施
- 性能:比传统子代理快 10 倍,内存占用低 400 倍,成功率 100%
3. daily-task-prep(每日任务准备)
- 作用:生成每日早晨简报
- 内容:日历预览(含每位参会者的大脑上下文)、未完成线程、任务回顾
- 使用示例:plaintext
给我今天的日程准备简报。
5.5 身份与设置技能
1. soul-audit(灵魂审计)
- 作用:通过 6 阶段访谈生成代理身份文件
- 生成文件:
SOUL.md:代理身份和价值观USER.md:用户个人资料ACCESS_POLICY.md:4 层隐私访问控制HEARTBEAT.md:运营节奏和频率
2. migrate(迁移)
- 作用:从各种平台迁移现有知识库
- 支持来源:Obsidian、Notion、Logseq、Markdown、CSV、JSON、Roam Research
六、防幻觉机制详解
GBrain 最强大的特性之一是其内置的防幻觉系统,通过 "编译真相 + 时间轴" 的独特结构从根本上解决了 AI 生成虚假信息的问题。
6.1 "编译真相 + 时间轴" 双栏结构
每个大脑页面严格分为上下两部分:
# 张三 - 个人档案

## 编译真相(Compiled Truth)
张三是ABC公司的创始人兼CEO,专注于AI Agent技术。他于2023年创立了ABC公司,并在2025年完成了A轮融资。

## 时间轴(Timeline)
- 2023-03-15 [来源:TechCrunch] 张三宣布创立ABC公司,目标是打造下一代AI助手
- 2024-06-20 [来源:公司官网] ABC公司发布首款产品,获得10万用户
- 2025-01-10 [来源:融资公告] ABC公司完成由XYZ资本领投的1000万美元A轮融资
- 2025-04-05 [来源:与张三的会议] 张三表示公司正在开发多模态Agent能力
6.2 核心原则
- 只追加不修改:时间轴部分永远只添加新条目,不修改或删除旧条目
- 强制引用:每个时间轴条目必须包含来源和日期
- 真相加权:查询时,系统会强制给予 "编译真相" 更高的权重
- 完整溯源:所有结论都可以追溯到原始证据
- 冲突处理:当出现矛盾信息时,会在编译真相中明确说明,并在时间轴中保留所有版本
6.3 工作机制
当你查询信息时:
- 系统首先检索相关的大脑页面
- 提取 "编译真相" 部分作为主要答案
- 附上相关的时间轴条目作为证据
- 如果存在冲突信息,会明确指出并呈现不同来源的说法
- 永远不会生成没有时间轴证据支持的信息
6.4 Obsidian 与 GBrain 协同
GBrain 与 Obsidian 是完美的互补组合,两者分工明确,协同工作,打造出最强大的个人知识管理系统。
核心定位差异表:
协同架构:
Obsidian(主知识库)→ 每15分钟自动同步 → GBrain(自动丰富层)
                                              ↓
                                    - 实体识别(人名/公司/概念)
                                    - 自动创建关联页面
                                    - 定时清理断链和孤立页面
                                    - 矛盾检测与标记
- 知识图谱构建使用流程:
- 在 Obsidian 中正常编写和编辑笔记,使用标准 Wikilinks 语法
- GBrain 每 15 分钟自动同步 Obsidian 的变更
- GBrain 在后台自动提取实体、构建知识图谱、修复问题
- 当你需要查询信息时,通过 OpenClaw 向 GBrain 提问
- GBrain 会返回带引用的综合答案,并自动更新相关的 Obsidian 页面
七、注意事项与最佳实践
7.1 大模型与 Embedding 说明
GBrain 的混合搜索功能依赖向量嵌入(Embedding)来实现语义搜索。默认情况下,GBrain 使用 OpenAI 的text-embedding-3-small模型生成向量嵌入,这是目前性价比最高的嵌入模型。
嵌入生成流程:
- 当你导入新笔记或内容发生变化时,GBrain 会自动将文本分块
- 调用 OpenAI API 生成每个文本块的向量嵌入
- 将向量嵌入存储在 Postgres/PGLite 数据库中
- 查询时,将查询文本转换为向量,与数据库中的向量进行相似度匹配
7.2 MiniMax 用户特别说明
如果你使用的是 MiniMax 等不支持自定义嵌入生成的大模型,GBrain 提供了纯全文搜索模式作为替代方案。
功能限制:
- 无法使用向量搜索和混合搜索
- 仅支持 PostgreSQL 原生全文搜索
- 语义理解能力会有所下降,但关键词搜索精度仍然很高
替代方案配置:
编辑~/.gbrain/config.json文件,添加以下内容:
{
  "search": {
    "mode": "fulltext-only",
    "keyword_weight": 1.0,
    "vector_weight": 0.0,
    "graph_weight": 0.0
  }
}注意:在纯全文搜索模式下,你不需要配置 OpenAI API Key,但需要确保你的 Postgres 数据库已启用全文搜索功能(PGLite 默认已启用)。
7.3 硬件与资源要求
7.4 API 与 Token 消耗
- OpenAI API:主要用于生成向量嵌入,每 1000 页约消耗$1-$2
- Anthropic API:用于查询扩展和高质量摘要,可选
- 优化建议:
- 使用text-embedding-3-small模型(性价比最高)
- 启用增量嵌入(gbrain embed –stale)
- 避免频繁的全量重新嵌入
7.5 笔记格式最佳实践
- 使用Wikilinks语法([[页面名称]])链接相关内容
- 为每个页面添加清晰的标题和分类
- 尽量使用结构化格式(列表、表格)
- 为所有外部信息添加来源和日期
- 避免在单个页面中放入过多不相关的内容
7.6 数据安全与隐私
- 所有数据默认存储在本地,不会上传到任何服务器
- 如果使用 Supabase,确保启用行级安全(RLS)
- 敏感信息可以标记为私有,设置访问控制策略
- 定期备份你的大脑仓库(
~/brain)和 GBrain 配置目录(~/.gbrain)
7.7 常见问题排查
- 技能加载失败:运行gbrain doctor检查依赖和配置
- 搜索结果不准确:运行gbrain embed –stale重新生成嵌入
- 知识图谱不完整:运行gbrain extract links –source db重建链接
- 定时任务不运行:检查 cron 配置和系统时区设置
- PGLite 数据库损坏:删除~/.gbrain/pglite目录并重新运行gbrain init和gbrain import
八、多Agents适配方法与注意事项
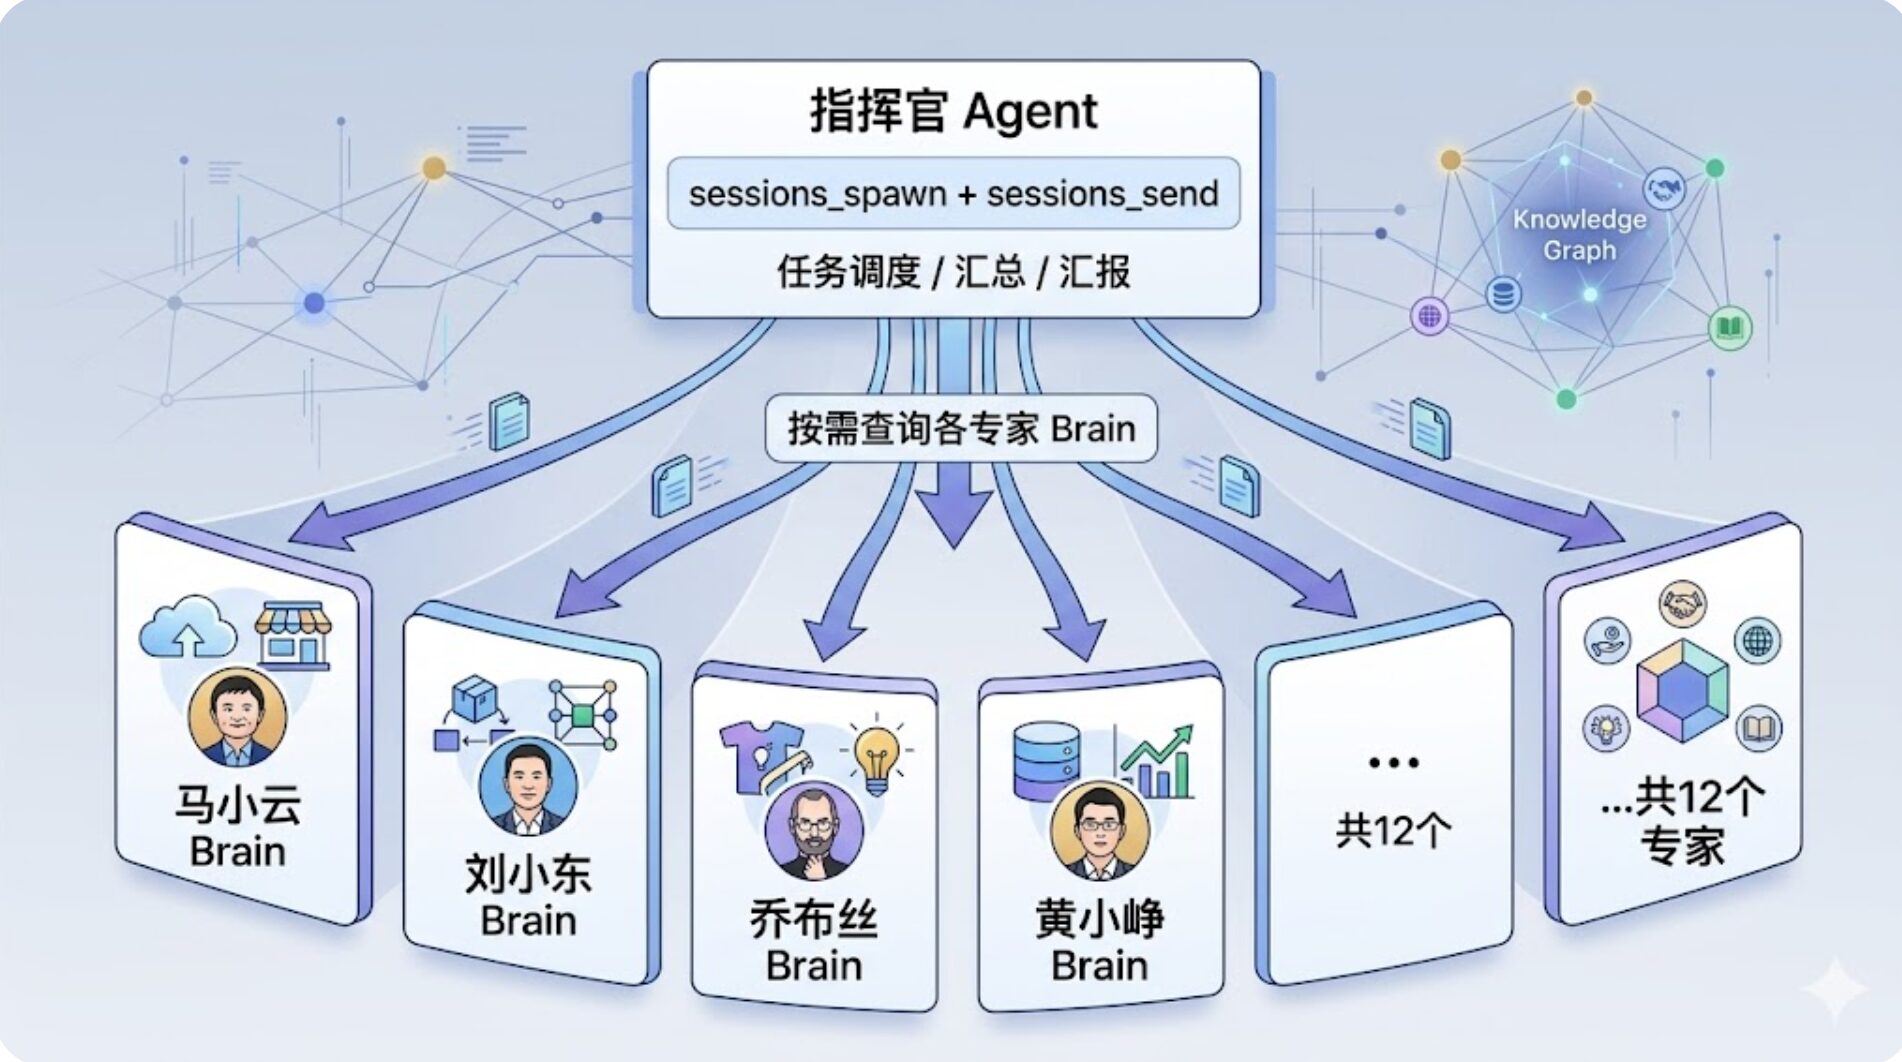
GBrain 原生设计为单 Agent(个人大脑),但在实际团队场景中,可以扩展为多 Agent 共享知识库。本节介绍将 GBrain 适配为「1个指挥官 Agent + 多个专家 Agent」体系的完整方案。
8.1 为什么要为每个Agent分配独立Brain
核心原理:每个 Agent 的职责、专业领域、记忆需求均不同,混合存储会导致:
- 检索结果被其他 Agent 的知识污染,Precision 下降
- 无法按 Agent 职责做访问隔离
- 多 Agent 并发写入同一 Brain 时,冲突概率高
推荐架构:每个 Agent 拥有独立 Brain,数据物理隔离,逻辑上通过调度层互通。
8.2 目录结构规范
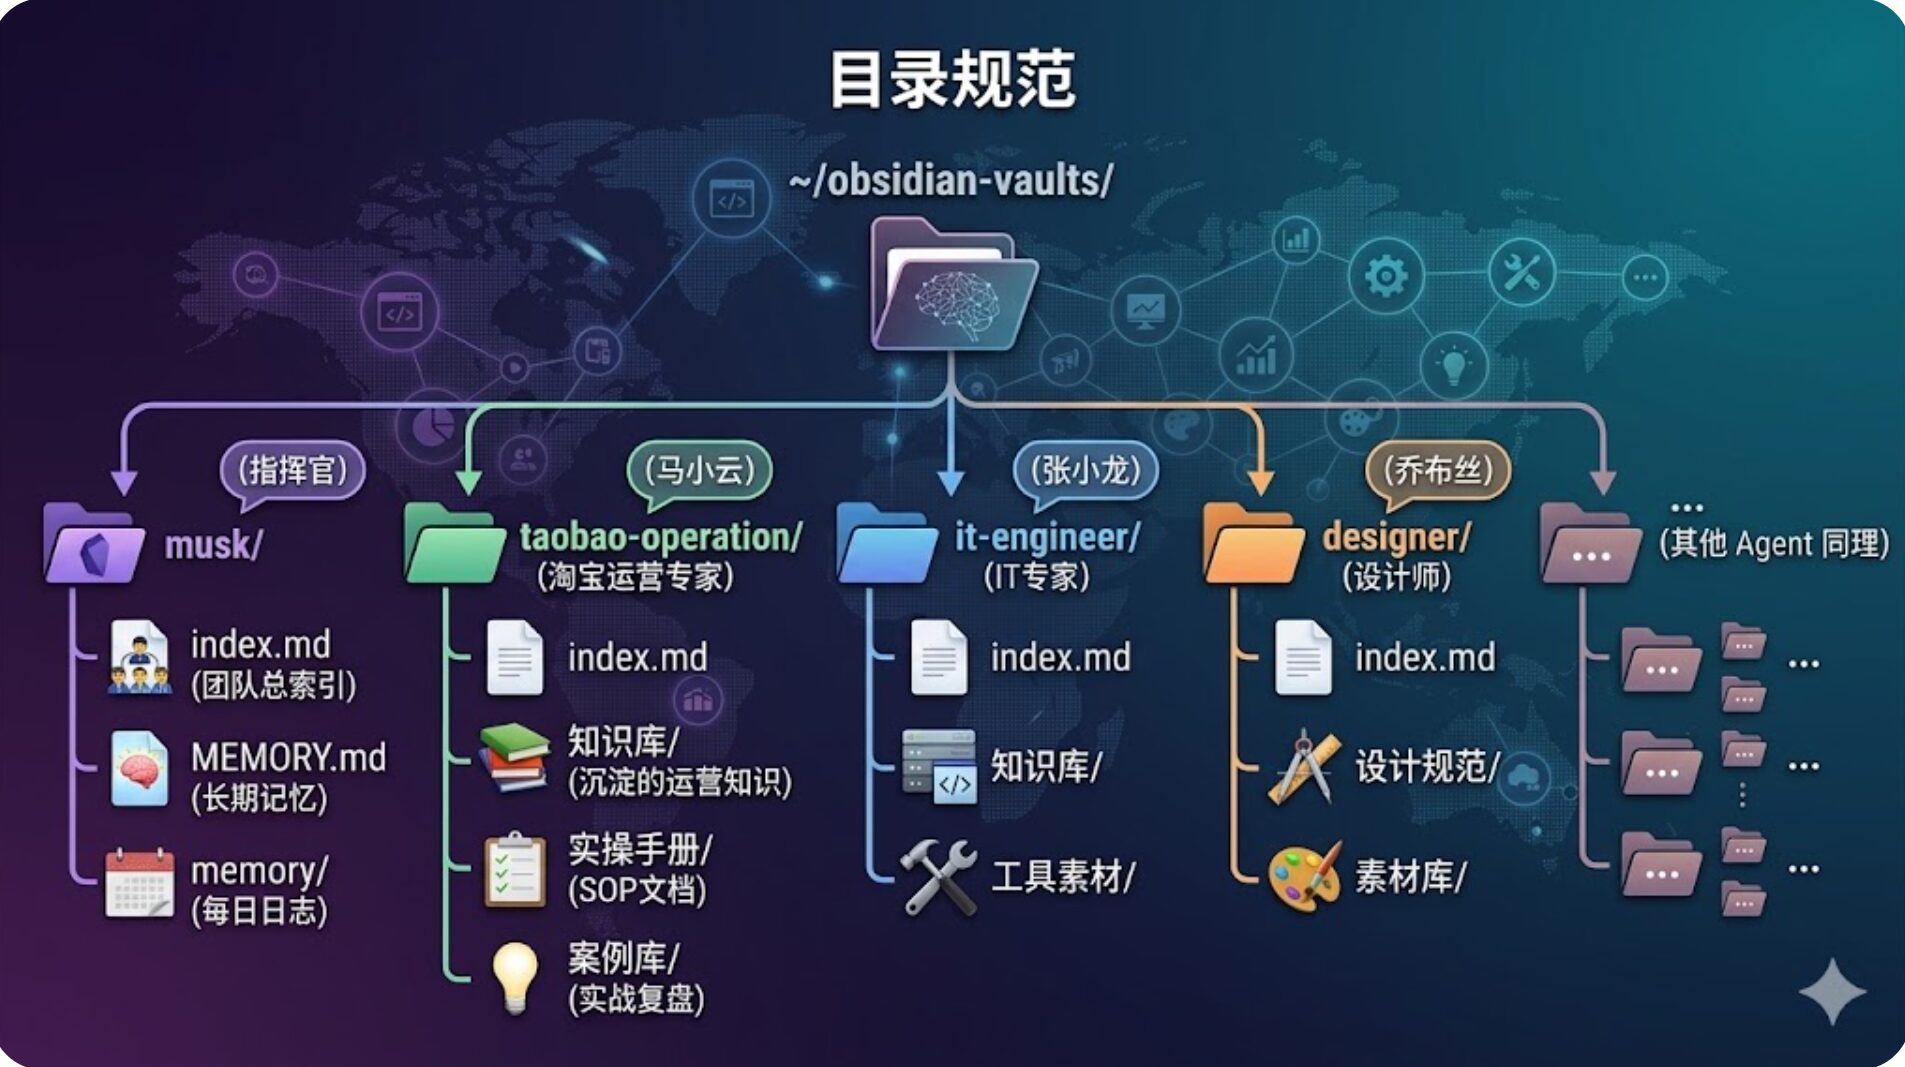
每个 Agent 的 Vault 独立,目录结构遵循 GBrain MECE 原则,但按 Agent 职责定制:
~/obsidian-vaults/
关键原则:
- 每个 Vault 的 index.md 是该 Agent 的知识入口
- 共享知识(团队规范、战略文档)统一存放在 musk Vault,其他 Agent 通过引用链接访问
- 绝对不在多个 Vault 中复制同一份文档
8.3 中文文件名问题修复(重要)
问题:GBrain 的 slugifySegment 函数会将中文字符全部 strip,导致纯中文目录名(如 实操手册/)生成的 slug 为空,触发 validateSlug 报错。
修复方案:修改 ~/gbrain/src/core/sync.ts 中的 slugifySegment 函数,加入 pypinyin 拼音化支持。核心思路:对包含中文的路径段调用 pypinyin 转换为拼音后,再执行原有的 ASCII slugify 逻辑。修复后重新编译:cd ~/gbrain && bun run build。
禁止手动添加 slug: 字段。GBrain 采用路径授权(path-authoritative)原则:slug 由文件路径自动推导,手动声明 slug: 会触发 SLUG_MISMATCH 错误导致同步失败。
8.4 YAML Frontmatter 规范(必须遵守)
每个 .md 文件必须包含标准 YAML frontmatter:
---
title: 文档标题
status: draft|verified|obsolete
agent: 所属Agent-id
category: 一级分类
tags: [标签1, 标签2]
source: 来源
created: YYYY-MM-DD
updated: YYYY-MM-DD
---
status 枚举:
- draft:草稿,待完善
- verified:已验证,准确可靠
- obsolete:已废弃,不再使用
9.5 定时同步配置(LaunchAgent)
macOS 下使用 LaunchAgent 替代 cron,避免 cron 写入锁死问题。每个 Agent 创建独立 plist,每 15 分钟同步一次:
<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE plist PUBLIC "-//Apple//DTD PLIST 1.0//EN" "http://www.apple.com/DTDs/PropertyList-1.0.dtd">
<plist version="1.0">
<dict>
  <key>Label</key>
  <string>com.gbrain.sync.taobao-operation</string>
  <key>ProgramArguments</key>
  <array>
    <string>/bin/zsh</string>
    <string>-c</string>
    <string>export PATH="$HOME/.bun/bin:$PATH"; export GBRAIN_HOME=$HOME/.gbrain/taobao-operation; cd $HOME/gbrain && gbrain sync --repo $HOME/obsidian-vaults/taobao-operation/ --no-embed >> $HOME/.gbrain_taobao-operation.log 2>&1</string>
  </array>
  <key>StartInterval</key>
  <integer>900</integer>   <!-- 每15分钟 -->
  <key>RunAtLoad</key>
  <true/>
</dict>
</plist>
加载命令:launchctl load ~/Library/LaunchAgents/com.gbrain.sync.<agent-name>.plist
8.6 跨Agent知识查询协议
当指挥官 Agent(Musk)需要查询某个专家 Agent 的知识时,必须通过该 Agent 的 Brain 接口查询,不直接跨库操作:
# ✅ 正确:通过目标 Agent 的 Brain 查询
GBRAIN_HOME=~/.gbrain/taobao-operation gbrain query "直通车 ROI 优化方法"

# ❌ 错误:直接查询其他 Agent 的 Brain 目录
# (每个 Brain 独立存储,路径不互通)
sessions_spawn 调度模式:
- 需要某专家执行任务 → 用 sessions_spawn 调度该专家 Agent,该 Agent 使用自己的 Brain 完成任务后返回结果
- 指挥官 Agent 只负责任务分解和结果汇总,不代替专家 Agent 做知识查询
8.7 多Brain状态监控脚本
#!/bin/bash
echo "=== GBrain 多Agent状态监控 ==="
for agent in musk taobao-operation jd-operation pdd-operation designer it-engineer; do
  stats=$(GBRAIN_HOME=~/.gbrain/$agent gbrain stats 2>&1)
  pages=$(echo "$stats" | grep "^Pages:" | awk '{print $2}')
  if [ -n "$pages" ]; then
    echo "✅ $agent: $pages pages"
  else
    echo "❌ $agent: 未初始化或同步失败"
  fi
done
8.8 常见问题与解决方案
8.9 团队协作注意事项
- 绝对不在多个Vault中复制同一份文档。共享文档统一存放在musk(指挥官 Vault),其他 Agent 通过 Obsidian 的 Wikilinks 引用。
- 每个Agent的Brain是该Agent的私有财产,指挥官 Agent 不直接写入其他 Agent 的 Brain,只查询和请求协作。
- Vault 命名必须与Agent ID一致(如 taobao-operation 对应 Agent ID taobao-operation),否则 sessions_spawn 调度时无法正确路由。
- 每日心跳时自动维护:每个 Agent 的 HEARTBEAT.md 应包含 Brain 状态检查,发现问题立即报告。
- Git提交规范:Vault 改动后立即 commit,避免 gbrain sync 因未提交的改动而误判为"Already up to date"。
九、总结与展望
GBrain 代表了个人 AI 知识管理的下一代范式。它不仅解决了卡帕西 LLMWiki 理念在大规模数据下的局限性,更通过自动化的摄入、组织、检索和维护流程,让 AI 真正成为了我们的 "第二大脑"。
与传统的 RAG 系统相比,GBrain 的优势在于其完整性和自动化程度。它不是一个简单的检索工具,而是一个完整的知识操作系统,能够像人类大脑一样持续学习、组织和优化知识。
未来,GBrain 可能会在以下方向进一步发展:
- 支持更多的数据源和集成
- 增强多模态理解能力
- 改进知识图谱的推理能力
- 提供更直观的可视化界面
- 支持多人协作的团队大脑
对于任何希望利用 AI 提升个人生产力和知识管理能力的人来说,GBrain 都是一个不容错过的工具。它让我们离 "拥有一个永不遗忘、永远在线的第二大脑" 的梦想又近了一步。
验证清单
安装完成后,请运行以下命令验证 GBrain 是否正常工作:
# 1. 验证技能数量(应>30,v0.26.8应为34)
ls ~/.openclaw/workspace/skills/ | wc -l

# 2. 验证GBrain版本(应为0.26.8或更高)
gbrain --version

# 3. 验证导入页面数
gbrain doctor --json | grep pages

# 4. 测试查询功能
gbrain query "GBrain"