
今天要拆解的,是 GitHub Trending 上正在疯涨的一个项目——revfactory/harness。它解决了一个让无数 AI Agent 玩家都头疼的问题:
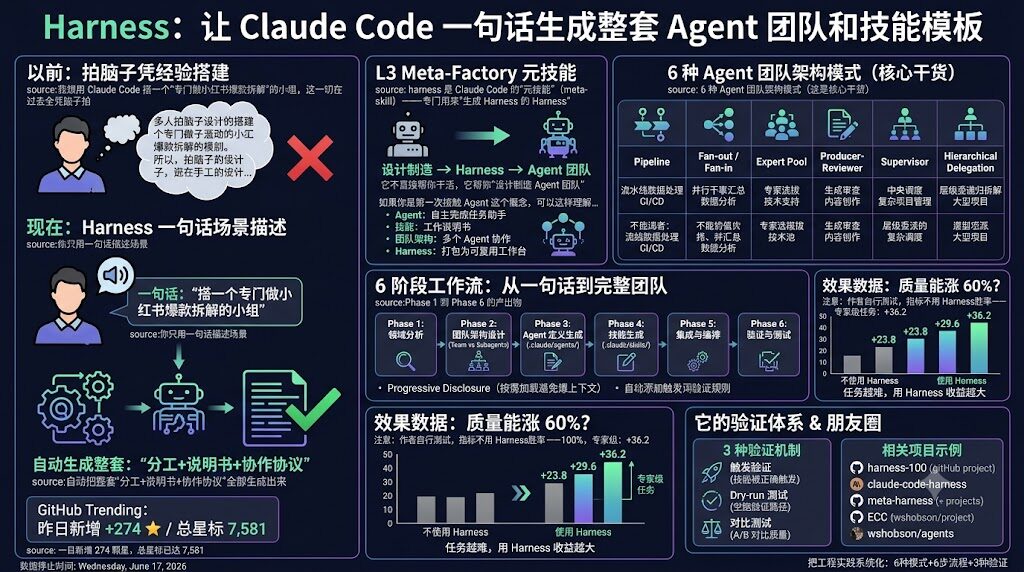
我想用 Claude Code 搭一个"专门做小红书爆款拆解"的小组,每个角色该干什么、怎么配合、用什么说明书——这一切在过去全凭脑子拍。
这个仓库给出的解法是:你只用一句话描述场景,它会自动把整套"分工+说明书+协作协议"全部生成出来。
它到底是什么?
用一句话描述:harness 是 Claude Code 的"元技能"(meta-skill)——专门用来"生成 Harness 的 Harness"。
如果你是第一次接触 Agent 这个概念,可以这样理解:
- Agent = 一个能自主完成某类任务的 AI 助手(比如"专门写公众号文章的 Agent")
- 技能(Skill) = Agent 的工作说明书(告诉它遇到什么场景该怎么处理)
- 团队架构 = 多个 Agent 怎么协作(谁负责写、谁负责审、谁负责发布)
- Harness = 把上面所有东西打包成一个可复用的"工作台"
harness 的特殊之处在于:它不直接帮你干活,它帮你"设计制造 Agent 团队"。它处于 L3 Meta-Factory 层(团队架构工厂层),是"生成 Harness 的 Harness"。
6 种 Agent 团队架构模式(这是核心干货)
harness 把所有 Agent 团队协作方式抽象成了 6 种模式。每种模式都有明确的适用场景,你可以直接对照自己的业务挑:
| 架构模式 | 一句话描述 | 典型适用场景 |
|---|---|---|
| Pipeline(流水线) | 任务像流水线一样一个接一个,前一步的输出是后一步的输入 | 数据处理流水线、CI/CD 自动部署 |
| Fan-out / Fan-in(扇出扇入) | 多个 Agent 并行干同一件事的不同维度,最后汇总 | 代码审查、多维度数据分析 |
| Expert Pool(专家池) | 准备一堆专家 Agent,根据问题上下文动态选谁来回答 | 技术支持、多领域咨询 |
| Producer-Reviewer(生成-审查) | 一个 Agent 生成内容,另一个 Agent 负责质量审查 | 内容创作、代码生成 |
| Supervisor(中央调度) | 一个中央 Agent 动态把任务分发给下级 Agent | 复杂项目管理 |
| Hierarchical Delegation(层级委派) | 自上而下递归委派,主管把任务拆给组长、组长拆给组员 | 大型项目分解 |
对运营人的启发:你不需要把这 6 种都搞懂。你只要想清楚——"我的 AI 团队,到底是流水线、是分工协作、还是专家会诊?"——然后选一种最贴近你业务的方式,就能立刻少走 80% 的弯路。
6 阶段工作流:从一句话到完整 Agent 团队
harness 的整个生成流程被拆成了 6 个阶段,每个阶段都有明确的产出物:
Phase 1: 领域分析
  ↓
Phase 2: 团队架构设计 (Agent Teams vs Subagents)
  ↓
Phase 3: Agent 定义生成 (.claude/agents/)
  ↓
Phase 4: 技能生成 (.claude/skills/)
  ↓
Phase 5: 集成与编排 (数据传递/错误处理/协调协议)
  ↓
Phase 6: 验证与测试 (触发验证/dry-run/对比测试)
这几个关键词解释一下,免得非技术读者卡壳:
- Agent Teams vs Subagents:Team 是平级协作的多 Agent 系统,Subagent 是主 Agent 调用子 Agent 的层级关系
- .claude/agents/ 和 .claude/skills/:Claude Code 用来存放 Agent 定义和技能文件的目录
- Progressive Disclosure(渐进式披露):技能文件不是一次性全塞给 Agent,而是按需加载,避免"上下文窗口爆掉"(简单说就是"AI 一次性读不完所有说明书"的问题)
还有一个细节很关键:harness 会自动给生成的技能加上触发词(比如用户在 Claude Code 里说"用拆解爆款",对应的技能就会自动启动),以及验证规则(确保技能真的能被触发而不是"摆设")。
效果数据:质量真的能涨 60%?
⚠️ 注意:以下数据是作者自行测试(n=15),第三方复现仍在进行中。
| 指标 | 不用 Harness | 用 Harness | 提升幅度 |
|---|---|---|---|
| 平均质量分 | 49.5 | 79.3 | +60% |
| 胜率(任务完成度) | — | — | 100%(15/15) |
| 输出方差(质量稳定性) | — | — | −32% |
更有意思的是按任务复杂度拆分的提升幅度:
- 基础任务:+23.8
- 高级任务:+29.6
- 专家级任务:+36.2
翻译一下:任务越难,用 Harness 的收益越大。这和直觉一致——简单任务靠运气就能做对,复杂任务必须靠"结构化预配置"才能稳定输出。
它的验证体系:3 种测试帮你判断技能是不是"假把式"
很多团队的 AI 工作台都死在"技能生成了但从没被触发"这一步。harness 专门设计了 3 种验证机制:
- 触发验证:确保技能能被正确触发(比如你说"拆解爆款",它真的会启动那个技能,而不是跑去干别的)
- Dry-run 测试:空跑一遍整个流程,验证路径完整(不真正调用 LLM,省钱)
- 对比测试(A/B Test):同一个任务,有技能 vs 没技能的输出质量对比(这就是上面 60% 数据怎么来的)
对运营团队来说,对比测试特别值得借鉴——你下次评估一个新工具/新 prompt,先跑一组"用 vs 不用"的对照实验,比拍脑袋决策靠谱得多。
它周围的"朋友圈":5 个相关项目
| 项目 | 它和 Harness 的关系 |
|---|---|
| harness-100 | 100 个生产就绪的 Harness,覆盖 10 个领域 × 2 种语言,可以直接抄作业 |
| claude-code-harness | 基准测试项目,15 个软件工程任务的 A/B 对比数据来源 |
| meta-harness | Codex 运行时移植版(不只 Claude Code 能用) |
| ECC(Everything Claude Code) | 跨 Harness 标准化层(L2),可与 Harness 串行组合 |
| wshobson/agents | Agent/Skill 目录库(182 agents, 149 skills),可以当作"零件超市"用 |
它适合谁用?
如果你符合下面任一情况,harness 可能对你有用:
- 已经在用 Claude Code 做日常任务,想系统化地"造 Agent"而不是每次都靠 prompt 凑
- 团队里有 3+ 个不同领域的 AI 协作场景,想统一管理技能文件
- 对"AI 输出质量不稳定"这件事很头疼,想要可复现、可验证的 Agent 设计流程
暂时不适合你的情况:
- 只用 ChatGPT 网页版,没用过 Claude Code 这种带文件系统的 Agent 工具
- 只是个人玩玩,没有复用的需求
- 对"Agent 协作"的概念完全陌生(建议先看 OpenAI 的 Agent 入门文档)
💡 落地案例:把它当方法论抄
老实说,harness 的直接部署价值有限——它是 Claude Code 专用插件,跟其他 Agent 框架(比如 OpenClaw 这类多 Agent 协作系统)不直接兼容。但它的方法论价值很高,我尤其推荐这 3 点:
- 6 种架构模式可以直接抄:不管你用什么 Agent 框架,先把你的协作模式归类到这 6 种里,立刻能发现自己团队到底缺哪种协作(很多团队其实是 4 种模式混着用,互相打架)
- Progressive Disclosure 思路:别再一次性把全部 skill 描述塞给 Agent,按需加载是未来方向
- A/B 对比测试:评估任何 AI 工具/工作流改造前,先跑对照实验,用数据决定要不要全面铺开
你也可以用类似思路:先列出你团队所有重复性工作 → 给每类工作选一种最贴近的架构模式 → 写最小可运行的 prompt 模板 → 用对照实验验证效果 → 把验证通过的模板沉淀成"团队 SOP"。这个流程不依赖任何特定框架,通用性很强。
总结
revfactory/harness 的核心价值,是把"如何为领域设计 Agent 团队"这件事从直觉变成了可复用的工程实践。它不神奇——它只是把专家脑子里"我设计 Agent 团队时凭的那套经验"系统化了:6 种模式 + 6 步流程 + 3 种验证。
GitHub Trending 上一日涨 274 颗星,说明越来越多人在为同一个问题找答案:AI 工作台的"装配线"到底怎么搭?harness 给出了一个可参考的样板。
不管你最后用不用它的代码,这套思路都值得你花 30 分钟认真读一遍——尤其是那 6 种架构模式,几乎能直接套到任何"多人 + 多 AI"协作场景里。