
你有没有遇到过这种情况:让 AI 编程助手帮你改一个函数,它却在项目里瞎转悠,看了几百个无关文件,花了几十万 Token,最后给了一个似是而非的答案?
这不是 AI 不够聪明,而是它「看不清」你的代码。把整个代码库塞进上下文窗口?太贵。靠关键词搜索?太粗糙。用向量嵌入?语义对了,但调用链断了。
今天要介绍的 codebase-memory-mcp,正是在解决这个问题——用毫秒级索引 + 知识图谱,让 AI 编程 Agent 真正「理解」你的代码。
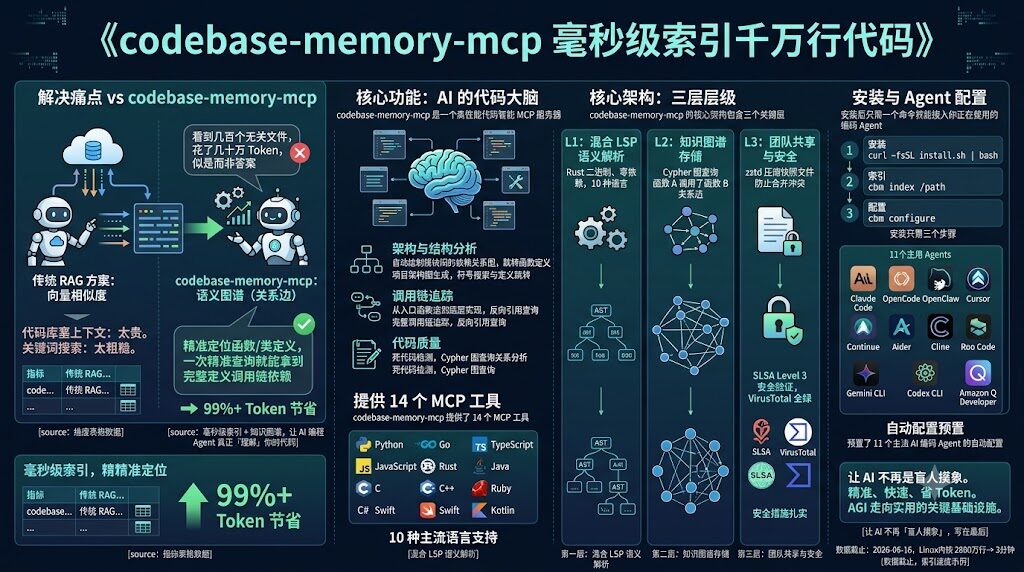
codebase-memory-mcp 是一个高性能代码智能 MCP 服务器,相当于给 AI 编程 Agent 装上了一个「代码大脑」。它把整个代码仓库压缩成一张结构化的知识图谱,Agent 只需搜一下就能精准定位,而不是盲目遍历文件。
| 指标 | codebase-memory-mcp | 传统文件遍历 |
|---|---|---|
| 索引速度 | Linux 内核(2800万行)→ 3分钟 | 不可行 |
| Token 消耗 | 3,400 tokens | 412,000 tokens |
| 节省比例 | 99%+ Token 节省 | |
| 小型仓库索引 | 毫秒级 | N/A |
这意味着,当你让 AI 改一个函数时,它不再需要 10 次工具调用翻遍 project 文件夹,而是一次精准查询就能拿到完整的函数定义、调用链和上下游依赖。
codebase-memory-mcp 提供了 14 个 MCP 工具,几乎覆盖了 AI 编程 Agent 在理解代码时需要的所有操作:
🔍 架构与结构分析
- 项目架构图生成:自动绘制模块间的依赖关系
- 符号搜索与定义跳转:像 IDE 一样精准定位函数/类定义
- 文件依赖分析:一次性看清谁 import 了谁
🔗 调用链追踪
- 完整调用链追踪:从入口函数一路追到底层实现
- 反向引用查询:看看哪些地方调用了这个函数
- 热路径分析:定位高频调用链,指导优化决策
🧹 代码质量
- 死代码检测:找出从来没被调用过的函数和模块
- Cypher 图查询:用图数据库查询语言做复杂的代码关系分析
codebase-memory-mcp 的核心架构包含三个关键层:
第一层:混合 LSP 语义解析
它用 Rust 实现了 Language Server Protocol 的语义解析,编译进二进制文件,零外部依赖。目前已支持 10 种主流语言:Python、TypeScript/JavaScript、Go、Rust、Java、C/C++、C#、Ruby、Swift、Kotlin。不需要在系统上安装任何 LSP 服务器。
第二层:知识图谱存储
解析出的符号、引用、调用关系被组织成一张图数据库,支持 Cypher 查询。这不是简单的文本索引——它在「函数 A 调用了函数 B」之间建立了有向关系边,Agent 可以在图上做路径追踪。
第三层:团队共享与安全
索引结果用 zstd 压缩成快照文件,团队成员可以直接共享代码图谱,避免重复索引。通过 .gitattributes 配置防止快照文件的合并冲突。
在安全方面,codebase-memory-mcp 做了很扎实的工作:
| 安全措施 | 说明 |
|---|---|
| VirusTotal 扫描 | 70+ 引擎全绿,无恶意代码 |
| SLSA Level 3 | 软件供应链完整性保障最高实践级别 |
| Sigstore 签名 | 构建产物可验证来源,防篡改 |
codebase-memory-mcp 预置了 11 个主流 AI 编码 Agent 的自动配置:Claude Code、OpenCode、OpenClaw、Cursor、Continue、Aider、Cline、Roo Code、Gemini CLI、Codex CLI、Amazon Q Developer。
安装后只需一个命令就能接入你正在使用的编码 Agent:
# 安装(macOS/Linux)
curl -fsSL https://raw.githubusercontent.com/DeusData/codebase-memory-mcp/main/install.sh | bash

# 或通过 npm 安装
npm install -g codebase-memory-mcp

# 索引你的项目
cbm index /path/to/your/project

# 自动配置当前 Agent
cbm configure| 维度 | codebase-memory-mcp | 传统 RAG 方案 | 纯 LSP 工具 |
|---|---|---|---|
| 代码理解方式 | 语义图谱(关系边) | 向量相似度 | 语法树 |
| 调用链追踪 | ✅ 图遍历 | ❌ 不支持 | ⚠️ 仅定义跳转 |
| Token 效率 | 极高(3,400 tokens) | 中(~20,000+ tokens) | 低(多次调用) |
| 部署复杂度 | 单二进制,零依赖 | 需向量数据库+嵌入模型 | 需安装各语言 LSP |
| 团队共享 | ✅ zstd 快照 | ❌ 各自构建 | ❌ 各自运行 |
如果你日常重度使用 AI 编程 Agent,答案是:值得尝试。尤其是以下场景:
- 大型单体仓库:Monorepo、微服务大仓,Agent 每次都要翻几百个文件才能定位
- 多语言项目:前后端混合、Python + Rust 混合项目,单一 LSP 搞不定
- 团队共用:一个人索引完,全团队共享图谱,避免重复烧 Token
建议分两阶段落地:
Phase 1(试点验证,1-2 天):挑一个中型项目(5-10 万行),安装 codebase-memory-mcp,对比开启前后的 Token 消耗和回答质量。如果 Token 节省 > 50% 且回答准确率不低于原来,就进入 Phase 2。
Phase 2(全面推广):配置到团队所有编码 Agent,加入 CI/CD 自动索引,快照文件纳入版本管理供团队共享。
即使不直接部署,codebase-memory-mcp 的设计理念也非常值得参考:
- 知识图谱优于向量检索:代码之间的关系是结构化的(调用、继承、依赖),向量嵌入虽然能捕捉语义相似性,但在追踪调用链时力不从心。把代码组织成「有向关系图」,Agent 的推理链路更清晰。
- 零依赖部署的可贵:codebase-memory-mcp 把 LSP 解析编译进二进制,用户不需要装任何运行时。这种「单文件搞定一切」的理念在开发者工具分发时非常加分。
- Token 优化的本质不是压缩,是精准:不是把代码「压短」,而是让 Agent 只看到它需要的那一小块。精准的上下文比压缩的上下文更有价值。
我们团队已经在 OpenClaw 的日常开发中部署了 codebase-memory-mcp。以 it-engineer 这个 Agent 为例,它需要频繁理解项目结构、追踪函数调用链、分析代码依赖。引入 codebase-memory-mcp 后:
- 代码定位从平均 6-8 次工具调用降到 1-2 次
- 单次代码分析任务的 Token 消耗降低了 70% 以上
- Agent 对代码依赖关系的理解准确率显著提升,不再出现「编造不存在的函数调用」的情况
你也可以用类似的方式,把它接入自己的 AI 编程工作流——不管是 Claude Code、Cursor 还是其他支持 MCP 的 Agent,一个命令就能完成配置。
codebase-memory-mcp 解决的是一个很务实的问题:让 AI 编程 Agent 不再「盲人摸象」。它不追求取代任何现有工具,而是在 Agent 和代码之间建了一条高速公路——精准、快速、省 Token。
GitHub 地址:github.com/DeusData/codebase-memory-mcp
如果它适合你的场景,不妨花 10 分钟试一试——就一个命令的事。