
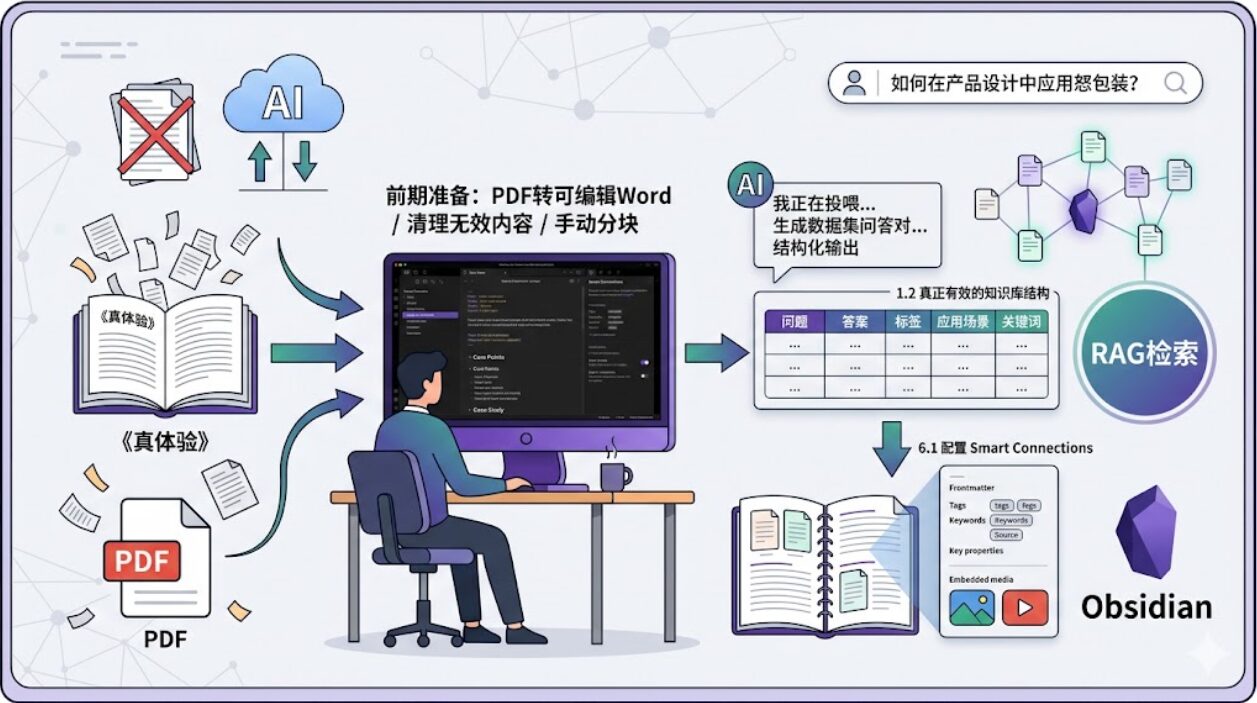
📚 Obsidian + AI 知识库转化路径
文档按字数硬切,导致上下文断裂,AI 无法理解核心逻辑。
图片文字丢失,长段落匹配率低,AI 经常"胡说八道"。
转 Word, 删冗余
手动分块 (2万字)
使用核心 Prompt
按块投喂生成 QA
Obsidian 模板
多维度 Tag/QA对
嵌入图片/视频
RAG 向量检索
点击查看 AI 生成提示词
1. 补充 15% 增量内容
2. 过滤过时信息
3. 独立自洽原则
4. 输出五个字段:问题、答案、标签、场景、关键词
点击查看 Obsidian 笔记结构
💡 提示:底层三层可通过书籍构建,上层三层靠自身积累。
一、核心问题:为什么不能直接上传 PDF/Word 到 AI
1.1 直接上传的致命缺陷
90% 的用户都会犯的错误:将整本书的 PDF 或 Word 文档直接导入 AI 知识库,会导致语义碎片化和检索不准确。
案例演示:
一份企业避坑指南文档被系统自动按 500 字硬切分成 20 个片段,出现以下问题:
- 一个完整的 "心法" 被切成两块,分别在第 1 和第 2 个切片中
- AI 检索时可能只获取到案例部分,却看不到对应的核心观点
- 跨章节的连贯内容被强行分割,导致上下文丢失
- 图片中的文字无法被识别,大量信息丢失
1.2 真正有效的知识库结构
高质量的 AI 知识库应该是结构化的问答对形式,每条记录包含:
- 问题:多维度覆盖知识点
- 答案:核心观点 + 机理解释 + 3 个案例 + 反向思维 + 实操建议 + 边界延伸 + 可复用公式
- 标签:便于分类和精准检索
- 应用场景:明确知识的使用范围
- 关键词:提升 AI 检索的匹配度
二、前期准备工作
2.1 工具准备
2.2 书籍预处理
- 格式转换:将 PDF 转换为可编辑的 Word 文档
- 使用 WPS:文件→导出→导出为 Word→选择 "扫描件转换"→开始转换
- 转换后检查图片文字是否可编辑,如有未识别内容手动补充
- 清理无效内容
- 删除所有图片(后续可按需重新生成并嵌入)
- 删除目录、前言、后记、参考文献等非核心内容
- 删除页眉页脚、页码等无关信息
- 手动分块
- 按章节将整本书拆分为多个 2 万字左右的模块(约 30 页)
- 分块原则:保持章节完整性,不要强行分割同一主题内容
- 示例:12 万字的《真体验》可拆分为 6 个 Word 文档,命名为 "真体验 – 第 1 部分" 至 "真体验 – 第 6 部分"
三、AI 生成结构化问答对
3.1 核心提示词模板
这是经过大量测试优化的提示词,直接复制使用即可:
我正在进行系统工程,将《[书名]》这本书拆分为多个部分,我将逐步投喂给你。你要为每个部分生成高质量的数据集问答对,最终形成一套可复用的知识库结构内容。

我的要求:
1. 基于原文核心观点,通过你的知识库补充15%的增量内容,不要简单搬运原文
2. 过滤原文中与时代明显不匹配的过时信息(如已淘汰的技术、过时的营销方式等)
3. 独立性原则:每一条问答对必须是独立自洽的,检索到单条内容即可直接使用
4. 结构化输出:每个问答对应包含问题、答案、标签、应用场景、关键词五个字段
5. 忠于原文底线:不得捏造信息,所有观点必须有原文依据
6. 高效输出:直接生成表格,不要多余解释

这是第[X]部分内容:
[粘贴对应部分的文本]
3.2 生成流程
- 打开 Obsidian,新建一个临时文档
- 粘贴上述提示词,替换书名和部分编号
- 粘贴第一部分的文本内容
- 使用 Obsidian AI 插件生成内容
- 重复上述步骤,直到处理完所有部分
3.3 注意事项
- 每次只投喂一个部分(约 2 万字),避免超出 AI 上下文窗口
- 生成后检查问答对的独立性和完整性
- 修正 AI 可能出现的幻觉内容,确保所有信息忠于原文
四、在 Obsidian 中构建结构化知识库
4.1 知识库文件夹结构
推荐使用以下文件夹结构组织你的知识库:
知识库/
├── 01-底层原理/
│   ├── 第一性原理/
│   └── 思维模型/
├── 02-通用能力/
│   ├── 营销学/
│   ├── 心理学/
│   └── 传播学/
├── 03-专业技能/
│   ├── 产品设计/
│   └── 内容创作/
├── 04-行业知识/
│   └── 互联网/
├── 05-个人经验/
│   ├── 踩坑记录/
│   └── 成功案例/
└── 06-内部资料/
    └── 企业文档/
4.2 单条笔记模板
每条问答对应创建一个独立的 Obsidian 笔记,使用以下 Frontmatter 模板:
---
question: "什么是怒包装?它对产品设计有什么启发?"
tags: ["产品设计", "用户体验", "怒包装"]
scenarios: ["新产品设计", "产品迭代优化", "用户痛点分析"]
keywords: ["怒包装", "用户情绪", "产品体验", "失败路径"]
source: "《真体验》第3章"
created: 2026-05-04
updated: 2026-05-04
---注:上述scenarios、keywords、source为自定义属性,Obsidian 原生支持任意自定义字段。若你使用 Obsidian Publish 服务,建议将source重命名为book_source以避免与系统内置属性冲突。
## 核心观点
怒包装是指通过故意制造用户的"愤怒"情绪,从而引发用户对产品的深刻记忆和传播的设计方法。

## 机理解释
1. 情绪记忆原理:负面情绪比正面情绪更容易被大脑记住
2. 反差效应:先抑后扬的体验会带来更强的满足感
3. 传播性:用户更愿意分享让他们产生强烈情绪的经历

## 案例
1. 某咖啡品牌故意将杯子设计得容易洒出,引发用户在社交媒体上的大量吐槽和分享
2. 某APP在用户首次使用时故意设置复杂的注册流程,然后在最后一步提供一键跳过选项
3. 某酒店故意将电视遥控器设计得非常难用,然后在床头放置一个"一键解决所有问题"的按钮

## 反向思维
怒包装不能滥用,否则会导致用户真正的不满和流失。必须确保"愤怒"是短暂的,并且最终能转化为惊喜和满足。

## 实操建议
1. 只在产品的非核心功能上使用怒包装
2. 确保"愤怒"的程度可控,不要超过用户的忍耐极限
3. 必须在用户产生负面情绪后立即提供解决方案
4. 测试不同程度的怒包装效果,找到最佳平衡点

## 边界延伸
怒包装不仅适用于产品设计,还可以应用于营销活动、内容创作等领域。例如,故意制造争议性话题来吸引关注。

## 可复用公式
怒包装效果 = (负面情绪强度 × 持续时间) × 解决方案惊喜度
4.3 批量导入与整理
- 将 AI 生成的问答对表格复制到 Obsidian 中
- 使用 Obsidian 的 "拆分笔记" 功能,将每条问答对拆分为独立的笔记
- 为每条笔记添加上述 Frontmatter 模板
- 根据内容将笔记移动到对应的文件夹中
- 使用 Obsidian 的标签功能进一步分类
五、多媒体内容增强
5.1 嵌入图片
Obsidian 推荐使用本地附件方式存储和嵌入图片,简单可靠且无需网络。
操作步骤:
- 在 Obsidian 库根目录创建一个 "assets" 文件夹用于存储图片
- 为需要配图的知识点生成相关图片(可使用 Midjourney、DALL-E 等工具)
- 将图片保存到 "assets" 文件夹
- 在笔记中使用以下语法嵌入图片:markdown
![[怒包装机理解释.png]] - 建议将图片放在 "机理解释" 部分之后,"案例" 部分之前
5.2 嵌入视频
- 将视频文件保存到 "assets" 文件夹
- 在笔记中使用以下语法嵌入视频:markdown
![[怒包装案例演示.mp4]] - 建议将视频放在 "机理解释" 部分之前,先给用户一个直观的印象
5.3 嵌入外部链接和文档
注:Obsidian 推荐使用[[笔记名称]]语法嵌入内部笔记,外部网页链接使用标准 Markdown 语法即可。
- 嵌入外部网页:markdown
[怒包装深度解析](https://example.com/怒包装深度解析) - 嵌入其他 Obsidian 笔记:markdown
[[情绪设计原理]] - 嵌入 PDF 文档:markdown
![[产品设计指南.pdf]]
六、配置 Obsidian AI RAG 检索
6.1 推荐插件与配置
Smart Connections 插件(Obsidian 生态中最受欢迎的第三方 RAG 社区插件):
- 打开 Obsidian 设置→社区插件→关闭安全模式→搜索并安装 "Smart Connections"
- 打开插件设置,配置你的 OpenAI API 密钥(或其他支持的 AI 提供商)
- 在插件设置中,将 "Embedding Model" 设置为 "text-embedding-3-small"(性价比最高)
- 设置 "Chunk Size" 为 1000,"Chunk Overlap" 为 200
- 点击 "Process Vault",让插件为你的所有笔记生成向量嵌入
6.2 检索测试与优化
- 打开 Smart Connections 面板
- 输入测试问题,例如:"如何在产品设计中应用怒包装?"
- 检查返回的结果是否准确、完整
- 优化方法:
- 完善笔记的 Frontmatter,特别是 tags 和 keywords 字段
- 拆分过长的笔记,保持每条笔记只讲一个核心问题
- 添加更多的内部链接,建立知识之间的关联
- 调整插件的 "Top K" 参数,控制返回结果的数量
七、企业知识库六层金字塔模型
这是经过实践验证的知识库构建框架,适用于个人和企业:
构建原则:
- 自下而上构建,先打好基础
- 下面三层可以大量借鉴书籍和公开资料
- 上面三层是你的核心竞争力,需要自己积累和整理
- 定期更新和迭代,保持知识库的时效性
八、常见问题与解决方案
8.1 AI 生成的问答对质量不高
- 优化提示词,更明确地说明你的要求
- 减少每次投喂的文本量,让 AI 更聚焦
- 提供高质量的示例,让 AI 学习你的风格
- 手动修正和完善 AI 生成的内容
8.2 检索结果不准确
- 完善笔记的 Frontmatter,特别是 tags 和 keywords 字段
- 拆分过长的笔记,保持每条笔记只讲一个核心问题
- 添加更多的内部链接,建立知识之间的关联
- 调整 AI 插件的参数,如 Chunk Size 和 Top K
8.3 知识库维护困难
- 建立清晰的文件夹结构和命名规范
- 使用标签系统进行多维度分类
- 定期回顾和更新旧的笔记
- 使用 Dataview 插件自动生成索引和目录
九、完整案例演示:《真体验》转 AI 知识库
- 预处理:将《真体验》PDF 转换为 Word,删除图片和无关内容,按章节拆分为 6 个部分,每部分约 2 万字
- 生成问答对:使用核心提示词模板,逐部分投喂给 AI,生成结构化的问答对表格
- 导入 Obsidian:将每条问答对拆分为独立的笔记,添加 Frontmatter 模板,移动到 "03 – 专业技能 / 产品设计" 文件夹
- 多媒体增强:为重要的知识点生成配图,嵌入到对应的笔记中
- 配置 RAG:安装并配置 Smart Connections 插件,为所有笔记生成向量嵌入
- 测试优化:输入测试问题,检查检索结果,优化笔记内容和插件参数
- 持续维护:定期添加新的知识点,更新旧的内容,完善知识之间的关联
十、总结与进阶
将一本书转化为 AI 知识库不是简单的上传和转换,而是一个知识重构的过程。通过结构化的问答对形式,你不仅可以让 AI 更准确地检索和回答问题,还可以加深自己对知识的理解和记忆。
进阶方向:
- 使用 Obsidian Graph View 构建全局知识图谱,结合 Canvas 进行专题知识的可视化梳理与深度整合
- 结合 n8n 等自动化工具,实现知识库的自动更新和同步
- 构建多 Agent 协作系统,让不同的 AI 助手负责不同的知识库领域
- 将知识库部署为 Web 服务,与团队成员共享和协作