
每个写过前端页面的人,大概都见过这样一幕:让 AI 生成一个落地页,拿回来的东西第一眼就带着"机器味"——通篇 Inter 字体、紫蓝渐变铺底、卡片里再套卡片、标题上方永远挂一个圆角方块小图标、彩色底上配灰字。功能都对,气质全无。
一个专门解决这件事的开源项目Nutlope/hallmark, 不是一套配色建议,而是一套"不许这样设计"的硬门禁,配一个不依赖大模型的确定性检查器。
一个专门收拾 AI 生成界面的 Skill
hallmark 的形态是 Claude Code / Codex / Cursor / OpenCode 四端通用的设计 Skill,以斜杠命令的形式出现,官方站点是 usehallmark.com。
它做的事情可以概括成一句话:把"什么叫难看的 AI 味"翻译成机器可以逐条判定的规则,然后在你交付之前把这些规则跑一遍。
它长什么样
仓库里的文件结构本身就是一份说明书:references/gates.md 是规则真源,scripts/sloplint.mjs 是执行者,references/themes/ 目录下是几十份视觉材料,references/ 下还有二十多份细分参考文档——从解剖结构、字体、品牌真相、色彩与纹理,到滚动编排、交互状态、响应式、深色模式、可视化、导出格式,逐一分开。
值得注意的是它同时提供 agents/openai.yaml 适配文件,为 OpenAI 一端做了兼容,说明作者从一开始就没把它锁死在单一工具里。
它的命令只有两个
/hallmark redesign <path> 保留内容和接线、只重建外观;/hallmark audit <path> 只出报告不改文件。动词受限,边界清楚。
这半年它涨了多少
项目 2026-04-27 建仓,到 10 月 26 日发稿时已经攒到 34,810 星、1,813 个 fork,最近一次推送是 10 月 22 日——半年不到从零做到三万四千星,而且还在涨:当天中午抓日榜时是 34,236 星,单日增量就有一千三百多。仓库主语言标注为 CSS,本质是一套 CSS 与 Node 组成的工具链;开放 issue 60 个,对于这个体量的项目属于正常水位。
AI 味到底是从哪来的
要理解这个项目的价值,得先看清它针对的那个具体问题。
同一批默认值
hallmark 项目自己的说法是,所有在 SaaS 模板上训练过的模型,生成的前端都带着同一批"机器味"默认值:到处 Inter 字体、紫蓝渐变、卡片套卡片、彩色底上的灰字、每个标题上方都挂一个圆角方块图标。
这些不是随机误差,是训练数据的统计结果。模型在给定"做一个好看的落地页"时,输出必然收敛到那个被验证过最多次的模板上。
为什么"给点建议"没用
常见做法是给模型一份风格指南:"请避免使用紫蓝渐变""请不要用 emoji 当图标"。问题在于,提示词是软的,模型可以在下一次生成时忘记它,也可能把禁令当成一条可以权衡的偏好。
hallmark 的选择相反:不写进提示词,而是写进检查器里的规则。模型无法绕过——要么修,要么正式豁免并留下证据。
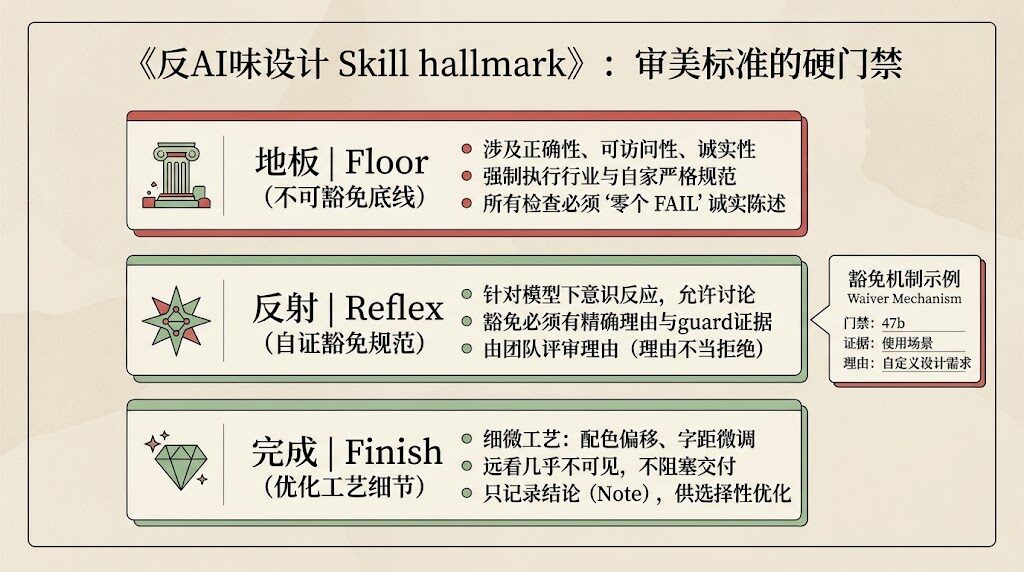
三层门禁:Floor、Reflex、Finish
这个项目最核心的抽象,是把设计门禁分成三个等级,写在 39KB 的 references/gates.md 里。
- Floor(底线):涉及正确性、可访问性、诚实性和禁令类要求,永远不能豁免。判定结果是 FAIL,不通过就不许交付。
- Reflex(反射):模型的下意识反应,可以带着真实理由豁免。判定结果是 REFLEX,要么修掉,要么记录理由后放行。
- Finish(收尾):工艺细节,远看基本看不见。判定结果是 ANSWERED,只回答、不阻塞。
- 另有一层 Ledger(记账):重复性问题的记录,判定结果是 NOTE,从不影响结论。
三个等级各管什么
Floor 管的是"不能错"的事。比如图片撑破网格、文字溢出容器、动画没有 prefers-reduced-motion 兜底、紫色蓝色渐变、卡片套卡片、用 emoji 冒充图标。Reflex 管的是"最好别这样"的事,比如首屏文字太多、装饰性元素抢戏。Finish 管的是配色偏移、字距微调这类肉眼几乎看不出来的细活。
判定和报告是两件事
文档里有一句相当清醒的表述:目标是让"零个 FAIL"这句话始终是对 Floor 而言的诚实陈述。换句话说,通过了所有底线检查,不等于页面设计得好——反射层没处理,照样是问题。
报告口径和判定口径分开,是评审系统里很值得抄的一点。很多团队的检查报告混在一起,最后只剩一句"基本通过",读者根本不知道哪些是硬伤、哪些是建议。
为什么只有 4 条进了 Floor
Floor 里并非所有规则都塞满,gates.md 明确写了:只有 4 条(眉标题 eyebrow、屏幕字数预算、模板标点、全大写标签)是因为"作为自家规矩比行业更严"才被放进 Floor,其余一律不进。
这避免了把标准写成不可违的圣旨。大多数门禁是可以讨论的,只有真正会伤到用户或伤到诚实性的才值得锁死。
豁免必须自证
如果规则只有"不可违反"三档,聪明的使用者会绕过整条规则链——最省事的做法是把检查器关掉。hallmark 的应对是:允许豁免,但豁免必须留下可核验的证据。
豁免写在 CSS 注释块里,三个字段:门禁编号、guard 证据、理由。
豁免要写三样东西
门禁号必须精确到子条款(写 47b 不能写 47),guard 是指出这个页面哪里满足了例外情况,理由是自然语言说明。三者缺一,检查器不接受。
理由的门槛:短、具体、不能复用
理由必须和当前页面的用词共享至少一个词,长度短于 24 个字符,不能是样板话,也不能在另一处被逐字复用过。理由太笼统、太长、或者复制粘贴的,一律拒绝。
这三条约束看起来琐碎,但它们精确针对一个真实问题:一旦理由可以随便写,豁免记录就会退化成一句"这里特殊"。
连续豁免三次,它就变成你的风格
同一个门禁被连续豁免三次,检查器不再报错,而是判定"这是你的 house style"(你自己的风格),并提示把它写进 design.md。
这条设计是整套机制里最漂亮的:把"我总这么干"从违规降级成风格,但要求你把它写下来。风格被显式承认之后,它就不再是"每次都要找个借口"的事。
退役的编号永不复用
项目里有一批已退役的门禁编号(5、13、14、21、31、35、36、43、45、51、52、57、60、61 等),明确规定永不复用。这样一来,写在旧页面里的老戳记依然能读懂当时豁免的是哪一条。
版本化审计做到这一步,才算真正成立。
规则和实现同源:文档是唯一真源
references/gates.md 39KB,是全库最长的参考文件,里面编号门禁正好 88 条,外加 21 条需要人判断的条款和 26 项只记录不阻塞的收尾检查。scripts/sloplint.mjs 231KB,加上渲染版 99KB、主题模块 59KB、引用检查 21KB,是整个检查引擎。
关键的一行写在 gates.md 第 1 节:sloplint.mjs 实现所有带 M 标签的门禁,并从这份文档里派生层级映射,两者冲突时以文档为准。
这解决的是一个很常见的隐患——文档写一套,脚本实现另一套,改了文档忘了改脚本,或者反过来。规则从文档派生,文档就是单一事实源,冲突有明确裁决方。
检查器是确定性的,模型绕不过去
Skill 的 allowed-tools 只允许跑本地检查器。检查器是纯规则代码,不需要大模型,不需要 API key。
它分两层工作。静态层直接分析 CSS 和标记结构;渲染层用 --render 参数跑真实浏览器,检查实际渲染结果。
交付前的要求写得很硬:如果环境里有 Node,交付之前必须跑一次检查器,所有 FAIL 全部修掉,所有 REFLEX 要么修掉要么正式豁免。
这跟"让模型自己检查自己"完全是两回事。模型能绕过提示词,但绕不过一个确定性脚本——它只能修,或者按规矩留下证据。
主题是材料,不是方案
48 个主题,每个主题一个文件(每个不超过 8KB),放在 references/themes/ 目录下,每个配一张成品页面截图。README 里的原话是:主题是材料而非方案,它永远不告诉你一个页面该放什么内容、按什么顺序排,所以同一个主题下的两个提示词会做出两个不同的页面。
每次只读一个主题
每个构建过程只读取一个主题文件,8KB 的上限本身就是在强制渐进式披露。主题只给材料——纸的质感、字体、颜色、表面处理、自带组件和纹理,不给内容结构。
为什么这能解决"每次生成都一样"
模型连续生成几次,输出会不自觉收敛到同一个样子。让每次构建只从一份材料里取材,不同提示词就会落到不同页面上。
顺带一提,references/themes/ 目录实测有 577 个文件,其中 48 个是主题 markdown——和 README 标注的 48 个主题完全对得上,其余是配图、示例这类配套资源。这种"文档数字与实际文件对得上"的仓库,读起来会省心很多。
诚实是底线级要求
Floor 第 8 条写得毫不含糊:绝不编造指标、证言、logo 墙或案例数量。
对应的做法是"只问一次"。在真正开工之前,工具会一次性问清四组信息:材料(截图、录屏、真实照片、真实数字、带名字的引语、logo)、受众、页面要驱动的唯一动作、以及语气。
其中有一条规则值得单独拎出来:事实永远不被推断。没给的数字、引语或 logo 就是不存在。还有一条是语气必须给一个极端,"干净又现代"不算语气。
没给的事实不存在
这一条对做内容的人来说是可直接照搬的硬规则:商品参数、功效宣称、认证资质、库存数据,没提供就是没有,不能编。
一次问清,不再追问
"Ask once" 的意思是这些信息在开工前一次性收齐,之后流程里不再回头问你。这对使用者是好事——反复追问的 AI 工具会让人疲掉,答案质量也会一路下降。
缺素材时的降级路径
没给照片,就用项目内置的 755 张开放许可照片库(索引文件 45 万字节)里的占位图,并且明确标注待替换。同时还有 capture.mjs 脚本可以直接截取自己产品的真实界面。
不编造素材,也不因为缺素材就停摆——这是两件事。
先读你的项目,再来问你
流程的第 0 步是 pre-flight,信号有明确的优先级顺序:项目根目录的 design.md 或 DESIGN.md(锁定设计系统,优先级压过其他一切)→ 项目里的品牌规范或提示中点名的真实品牌(走品牌真相文件,禁止凭记忆给真实品牌配主题)→ 项目自身的字体、色板、间距、动效库、框架 → 产品本身(能打开的网址、能跑起来的开发服务器,脚本会自己截图)→ 灵感检索 → 用户提示 → API 密钥。
保留什么,引入什么
产出是一份带文件行号引用的缓存结果(preflight.json),并且明确区分"哪些被保留、哪些被引入"。
显式二分加行号引用加缓存复用——这比"我看一眼项目然后开始写"强了一个量级,因为每一步都能被追溯。
交付物自带说明
Floor 第 15 条规定:CSS 源文件的第一行非空内容是 Hallmark 戳记,紧跟批判行,然后是豁免行。
也就是说交付出去的东西自带自证元数据。机器能读出这份产物过了哪些门禁、豁免了什么,人也能一眼看到。
禁用项清单
除了网格规则,Floor 里还有一批明确禁令:禁止眉标题(标题上方那个小标签,这是"AI 味"最典型的符号之一)、禁止紫蓝渐变、禁止卡片套卡片、禁止用 emoji 当图标、禁止手绘风格的浏览器或操作系统窗口。
hero 区的验收也有硬指标:标题、一句话说明、主行动按钮必须在 1280×800 的视口下全部可见,不需要滚动;任一屏的文字量上限大约 80 词。
另外还有一条放在 Reflex 层的:有锚定主色时,页面上不许出现零彩度中性色(纯黑、纯灰必须带色相)。它没被列进 Floor,是因为有些页面确实需要中性底色——但只要页面定了主色,就不该再冒出没色相的灰。
顺带一提的网格纪律
Floor 第 5 条的网格纪律写得很专业:带图片的网格轨道用 minmax(0, 1fr),标题容器带 overflow-wrap: break-word 和 min-width: 0——这是 grid 和 flex 布局溢出问题的根因级规则,不是碰运气式的补丁。
同一批里,还有几个值得看的项目
10 月 26 日当天的 GitHub 日榜上,除了 hallmark,还有几个方向相近的项目,横向对照能看出这条赛道的分层。
pbakaus/impeccable:把设计规则全写成 Rust
Rust 写的检测引擎,8.8 万星,一个 Skill 加 24 条命令加 62 条确定性检测规则(数字出自其 README),仓库里 16 个 crate、4,881 个文件,这两项是树结构实测。规则分布在 crates/foundation/src/rules/ 和 crates/core/src/checks/rules.rs(后者明确标注是从另一个项目的 JavaScript 版本移植而来),crates/detect/src/list_rules.rs 提供规则清单。
它的工程取舍很清楚:Skill 的 allowed-tools 只允许跑 npx impeccable *,检测器不需要大模型也不需要 API key,二进制自包含,连 Node 都不需要装。
两个与 hallmark 明显不同的路线选择:impeccable 把 PRODUCT.md(产品真相:受众、目的、运行上下文、约束、语气、证据)和 DESIGN.md(视觉系统)拆成两份文件,hallmark 则是用 pre-flight 缓存加 design.md 锁定系统;impeccable 还有浏览器实时变体模式,能在真实浏览器里迭代元素而不是靠人挑,hallmark 走的是 48 个主题发牌。
它还专门建了 reference/degraded/ 目录,放了四个降级角色(素材产出者、文档撰写者、收尾评审者、手工编辑执行者)——降级路径是显式建模的,不是"失败就完"。
反模式清单也相当直白:禁用泛滥的 Inter 类字体、禁彩色底上配灰字、禁纯黑纯灰(必须带色相)、禁卡片套卡片、禁 bounce/elastic 缓动。
AgriciDaniel/claude-seo:把 SEO 拆成一支队伍
一个 Claude Code 插件,2.1 万星,由 26 个子技能加 19 个专职 Agent 组成,最多 17 个 Agent 同时跑。覆盖范围包括技术 SEO、E-E-A-T、Schema.org、GEO 与 AEO(AI 搜索引用)、站点地图、性能、视觉、本地 SEO、电商 SEO、国际 SEO。
最有意思的是它对前沿概念的覆盖:Lighthouse Agentic Browsing、WebMCP、llms.txt——这些是专门给 AI 爬虫准备的可读性契约。README 上挂着 1077 个测试通过的徽章,还自报 12 周 10.8K 的 Search Console 点击量。作者自述在 Trendshift 日榜上排到 Repository Of The Day 第 12 名。
它的商业化路径也值得注意:开源部分做漏斗,同时运营付费社区。
makecindy/cindy:多 harness 混用的客户端
5,518 星的 Electron + Expo 移动端客户端,Apache-2.0。核心主张是多 harness(Claude Code / Codex 加自研原生 harness)与多模型自由混用、中途可切换,而工作区、记忆、技能、工具保持连续。
能力面上,记忆是跨 harness 共享的——纠正一次就长期正确;自动化能让任务定期自排自跑自汇报。
不过有一个明显风险信号:1,969 个 open issue,对 5,518 星的项目来说异常高(对比同期 hallmark 的 60 个、impeccable 的 47 个),这是早期项目社区大但 Issue 管理混乱的典型特征。真要部署,评估维护能力得放在前面。
JetBrains/thinkrail:官方下场做同一件事
2,203 星的 JetBrains 官方"vibe code"轻量 IDE,用 pi agent 驱动,标签里带 spec-driven 和 agent-skills。星数不高,但官方背书值得关注——它对 Skill 格式的标准化动作,可能比单个项目的星数更有影响力。
可以直接抄走的六条做法
一、门禁分级,豁免要自证,连续三次就转成风格
把"绝对不能做"和"最好不要做"分开。前者永不豁免,后者允许豁免但必须写清编号、证据和理由,理由要具体、简短、不可复用;同一门禁连续豁免三次,自动判定为你的风格并提示写进设计文档。
还有一条容易忽略的:退役编号永不复用。
补充:先把「底线」和「建议」分开写
大部分规范失败的原因不是不够严,而是所有条款看起来一样重。结果是团队要么全盘忽略,要么全盘照搬。
二、规则和实现同源,文档为准,脚本派生
文档是唯一真源,脚本从文档派生层级映射,冲突时以文档为准。这直接解决了多版本规则互相比对的痛点——不需要人工判断哪版支配哪版。
补充:编号退役后永不复用
这条听着像小事,其实是整套规则体系能不能长期维护的前提。编号一旦被复用,几年前写下的豁免记录就失去了含义,历史文档全部作废。
三、检查器要覆盖渲染层
现在很多检查脚本只做文本和 HTML 的静态分析,缺"实际渲染出来是否溢出、对比度够不够、首屏看不看得见"这类检查。hallmark 的做法是加一个 --render 参数用真实浏览器跑一遍。
对做内容和发布链路的人来说,渲染层是当前最明显的盲区——静态检查全绿,页面上照样可能溢出屏幕。
四、主题是材料,不是方案
Skill 生态里现在普遍缺"材料层"。各类 Skill 给的都是方法论(怎么做),很少有"长什么样"的材料包(视觉、文风、语气)。
可以照着做的是:准备几套风格材料,每次只加载一份,同一套提示词也能产出不同表达。这比再加一份写作规范文档有效得多。
五、事实与推断严格分离
没给的数字、引语、logo 就是不存在,不许编。这条规则在做电商详情页时是硬约束——参数、功效、认证、库存都不能编。
六、显式写清降级路径和适用边界
工具在什么情况下会失败、失败时走哪条路、明确不适合用在什么场景,都应该写出来。补上这两段比补功能更能减少误用。
电商场景怎么用
hallmark 本身是给前端页面做的,形态上离电商运营有点远。但它的方法论里,有三条是可以直接搬到内容生产上的。
第一条是"没给的事实不存在"。 做详情页文案时最怕的是"限时优惠最后三天"这种编出来的紧迫感、"月销 10 万+"这种没有来源的数字、"进口原料"这种无法核验的宣称。规则很简单:所有没有来源的数字、说法、承诺,一律不写。素材不够就用明确标注的占位,等真实素材到位再替换。
第二条是"保留 vs 引入"的显式二分。 写文案前先做一次 pre-flight,把手里已有的东西(品牌手册、产品参数表、真实客户评价、历史爆款结构)和需要新引入的东西分开列出来,产出时注明每一段的信息来源。写完回头对一遍,缺料的地方会自己浮出来。
第三条是"连续三次就是风格"。 记录哪些表达被反复豁免、被反复否定。如果一个团队连续三次拒绝某种标题结构,那不是个例,那是风格,该写进规范。
粗算一下 ROI:把"事实核对 + 来源标注"这两件事前置,比发布后被读者抓错再回滚便宜得多。适合在有专人复核的环节做;纯靠一个人拍脑袋出稿的小团队,收益会被复核成本吃掉。
什么时候不适合装
它是为 Web 前端页面设计的。 48 个主题、1280×800 的首屏视口验收、网格溢出规则、浏览器渲染层检查——这些前提在你写公众号、写小红书文案、写邮件时基本用不上。硬套只会增加噪音。
它有明确的适用边界声明。 文档里写着:除非用户明确点名 Hallmark,否则不要把它用在既有设计上。它默认从零开始,不默认接管你已有的页面。
同赛道还有更贴近的选择。 同一个项目组的前后脚作品 pbakaus/impeccable 是 Rust 二进制加 npx 安装链,检测规则 62 条、命令 24 条,同样是纯确定性检查、不需要大模型和 API key;而对内容站点更相关的是那个 SEO 插件——2.1 万星、1077 个测试、覆盖 AI 搜索引用和 llms.txt 这类新概念。如果目标是给 aiec.fun 这类内容站做搜索和 AI 引用层面的优化,那条线的相关性远高于设计 Skill。
生态风险的一句提醒
另外提醒一句生态风险。 同一批里那个多模型客户端项目 open issue 高达 1,969 个,说明这类早期项目的维护能力需要单独评估;看星标数选型的时候,把 issue 密度一起看一眼会稳很多。
一句话总结
hallmark 真正值得学的地方,不是它的 48 个主题或者 88 条门禁,而是它把"品味"这件事从模糊的建议变成了可执行、可豁免、可追溯的规则集——底线永不豁免,柔性条款允许豁免但必须自证,连续三次就承认它是你自己的风格。
对做 AI 工作流的人来说,这套模式可以直接套到任何"要有标准、又不能僵化"的场景上:文案规范、素材审核、发布前检查,都可以按 Floor / Reflex / Finish 分层,都能要求豁免留下证据。
值得注意的是,hallmark 本身并不是一个能立刻装上就用的大众工具,它更值得当一份设计得相当好的参考实现来读。但它证明了一件事:只要把规则写成可判定的形式,AI 产出质量就不再完全依赖模型今天的心情。