
你最近有没有发现:当你给ChatGPT或Claude一个复杂任务时,它总能给你一个看起来不错的答案,但一旦细节多了、步骤长了,它就很容易在中间某个环节"翻车"——忘了前面说过什么,或者在两个互相矛盾的分析之间反复横跳。
这不是你的prompt写得不好。这是一个架构问题。
最近看了一份来自技术社区的分析,详细拆解了Claude Code这个AI编程工具底层是怎么调度多个AI协同工作的。看完之后,我最大的感受是:未来真正能打的AI应用,不会是"一个超级聪明的AI",而会是"一群各司其职的AI组成的团队"。
这篇文章,我就用大白话聊聊多智能体协作背后的工程逻辑,以及我们能从中学到什么。
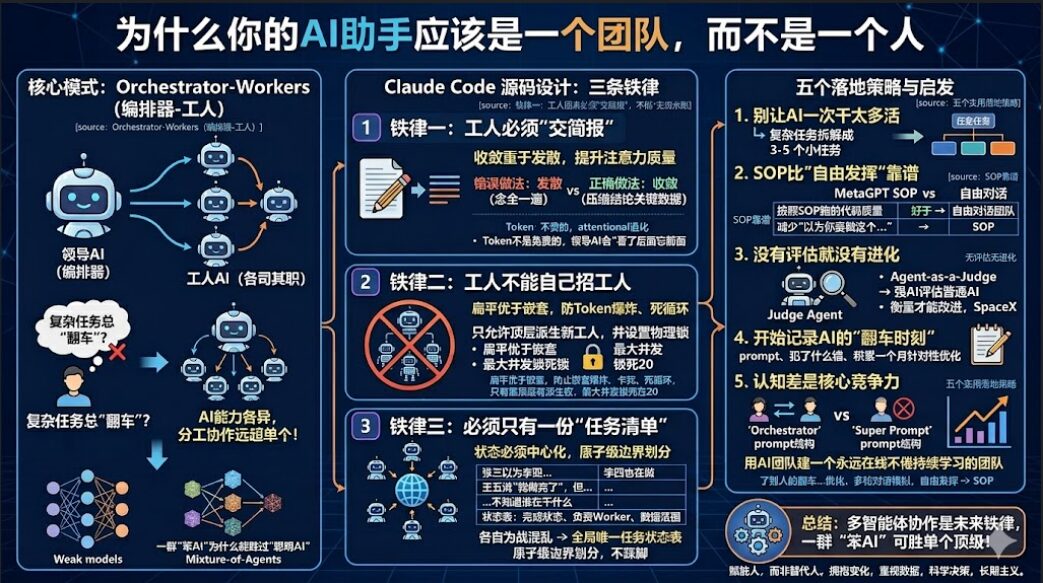
一个领导,一群工人
想象一下你是一个项目经理。手头有一个大项目:做一份竞品分析报告,涵盖价格对比、用户评价分析、推广策略评估。
如果你自己做,你得一个接一个地查资料、整理数据、写报告,可能要做一整天。
如果你有一个团队呢?你只需要做三件事: 1. 把任务拆开:张三查价格、李四看评价、王五分析推广 2. 把活儿分出去 3. 等他们交作业,你拼成最终报告
这就是多智能体协作的核心模式——Orchestrator-Workers(编排器-工人)。这个概念来自Anthropic公司2024年底发布的一份技术文章,是他们总结了跟几十个团队合作后的经验提出的。
它的意思是:有一个"领导AI"负责理解任务、拆解任务、分配任务,一群"工人AI"各自完成自己的部分,最后由领导汇总输出。
微软的AutoGen框架、学术界大热的MetaGPT,底层逻辑都是这一套。区别只是"领导怎么派活"和"工人之间怎么配合"。
从Claude Code源码里挖出的三条铁律
Claude Code是Anthropic推出的AI编程助手,可以在终端里帮你写代码、改bug、重构项目。它的架构就是典型的Orchestrator-Workers模式。
有意思的是,有人在分析了它的源码后,总结出了三条"工程铁律"。这些铁律非常简洁,但每一条背后都有扎实的工程理由。
铁律一:工人回来必须"交简报",不能"交流水账"
用技术的话说,这叫"收敛重于发散"。
什么意思呢?假设你派了一个工人AI去分析1000条用户评价。它可以给你两种汇报:
错误做法(发散):
"第1条评价说好,第2条说差,第3条……"(把1000条全念一遍)
正确做法(收敛):
"好评率78%,核心好评点是物流快、客服好;差评集中在外包装破损(占差评60%)和尺码不准(占25%)。建议优先优化包装。"
为什么收敛这么重要?两个原因:
- Token不是免费的:你把1000条原始数据全塞回给领导AI,上下文窗口瞬间爆炸,Token成本飙升
- 领导AI会"看了后面忘前面":长文本的注意力退化是LLM的已知缺陷,信息密度越低,决策质量越差
所以Claude Code的设计要求:每个工人AI在返回结果前,必须先自我压缩,只带回精炼结论和关键数据。原始数据放文件里,需要时再调取,别硬塞进对话里。
铁律二:工人不能自己再招工人
这叫"扁平优于嵌套"。
你觉得这很反直觉——工人如果能自己招人,不就能更快了吗?来,我们推演一下。
你派工人A去分析竞品价格。工人A心想:"好复杂,我招两个小弟吧,一个看淘宝一个看拼多多。"小弟1又觉得:"淘宝店铺太多,我再招三个小小弟。"小弟2觉得拼多多不好搞,也招了四个……
结果会怎样?
- Token指数爆炸:每多一层嵌套,消息量翻倍
- 你完全不知道发生了什么:任务追踪链断裂,某个小弟卡死了你都不知道
- 死循环风险:万一某个Agent陷入"解决不了→派生新Agent→还是解决不了"的循环呢?
所以工程上必须一刀切:只有最顶层的领导AI有权力派生新工人。任何人都不许越级招人。
Claude Code还加了一道物理锁:最大并发数锁死在20。任你什么场景,同时干活的工人不能超过20个。超过了?排队。简单粗暴,但有效。
铁律三:必须有且只有一份"任务清单"
这叫"状态必须中心化"。
继续用项目管理的比喻。如果你和你的团队没有共享文件,而是各自记各自的笔记,会发生什么?
- 张三以为李四在做价格分析,结果李四也在做
- 王五说"我的部分做完了",但他的"做完"和张三定义的"做完"不是一回事
- 你作为项目经理,完全不知道谁在干什么
多智能体系统也一样。Claude Code的做法是维护一份全局唯一的任务状态表,每种子任务的完成状态、负责Worker、占用的数据范围,全部清清楚楚。
更重要的是:原子级边界划分。比如"分析天猫店1-3月的销售数据"和"分析天猫店4-6月的销售数据",数据范围天然不重叠,两个工人不会互相踩脚。
一群"笨AI"为什么能胜过"聪明AI"
讲到这里你可能会想:把任务拆给一群AI,听起来需要很多模型调用,划算吗?
2024年6月,一个叫Mixture-of-Agents的研究给出了一个反直觉的答案:划算,而且效果可能更好。
他们做了一个实验:用多个开源模型(能力比GPT-4差)组成一个协作网络,每层模型的输出作为下一层的参考。结果呢?这个"开源弱模型联盟"在AlpacaEval 2.0评测中拿到了65.1分,而GPT-4 Omni只有57.5分。
一群普通AI的协作,战胜了单个顶级AI。
为什么?因为"三个臭皮匠"效应在AI领域同样成立——不同模型有不同的"偏见"和"盲区",互相补充后,整体判断更全面。就像你不会只问一个医生的意见来确诊重病,而是要会诊。
当然,这不意味着你什么事都需要调五个AI来做。Anthropic自己也在技术文章里反复强调一句话:
"从最简单的方案开始。很多时候,优化一次LLM调用就足够了。"
这跟普通开发者和创业者有什么关系?
你可能不做AI基础架构。但这套"多智能体协作"的思维模式,对我们日常使用AI工具或者设计业务流程都很有启发。
1. 不要再写"超级Prompt"了
很多人用ChatGPT的习惯是:在一段prompt里塞入所有要求——"你是一个专家,请先分析X,再分析Y,然后对比Z,注意格式A、B、C,最后输出一个……"
结果呢?GPT经常在第二步就偏离方向了。
不如换一种思路:用多轮对话模拟Orchestrator-Workers。
- 第一轮:让AI帮你拆任务(Orchestrator角色)
- 第二轮:一个子任务一个问题(Worker模式)
- 第三轮:汇总整合
虽然没有真正的多Agent并发,但效果显著优于一个超大prompt。
2. SOP比"自由发挥"靠谱
MetaGPT这个研究项目做了一个有趣的实验:他们不是让一群AI自由对话协作,而是先把人类的标准操作流程(SOP)编码成Prompt,再让AI按照SOP执行。
结果呢?按照SOP跑的团队,产出的代码质量明显好于自由对话的团队。因为SOP减少了"我以为你要做这个,你以为我要做那个"的误解——而这些误解在AI之间的对话中格外常见。
这对我们的启发是:如果你想让AI做复杂的业务流程,先把你自己的SOP写清楚,再交给AI。 别指望AI自己琢磨。
3. 没有评估就没有进化
你用了AI工具帮你工作,你怎么知道它是不是越来越好了?还是越来越差了?
学术界最新的方向叫Agent-as-a-Judge——用更强的AI来评估普通AI的工作质量。不只是看最终结果,还包括中间每一步的推理过程。
Musk的SpaceX有一句话:"如果你不衡量它,你就无法改进它。"AI领域也一样。如果你只是"感觉AI的答案还行",你永远不知道它在哪个环节掉链子。
总结:三个可以马上做的事
聊了这么多理论,说三件你现在就能做的事:
- 别让AI一次干太多活:把复杂任务拆成3-5个小任务,每次只给AI一个明确的小目标。这不需要任何技术门槛,只是思维模式的小转变。
给你的AI流程写SOP:如果你每天用AI做的事有固定流程,花20分钟写下来,固定成模板。你会发现AI的出错率明显下降。
开始记录AI的"翻车时刻":不需要什么高级工具,就一个简单的笔记。每次AI给出不满意的结果,记录一下:是什么任务、你的prompt是什么、AI犯了什么错。积累一个月,你会发现模式——然后你就能针对性地优化。
多智能体协作不是一个遥远的概念,它正在以我们看不到的方式改变AI的使用方式。
从"一个人干所有事"到"带团队",从"写超级Prompt"到"设计协作流程"——这不只是技术升级,而是一次思维方式的转变。