
最近,一款叫 Kronos 的金融 K 线大模型在技术圈迅速走红,短短几个月收获 2.5 万 GitHub 星,相关论文还被人工智能顶会 AAAI 2026 正式收录。
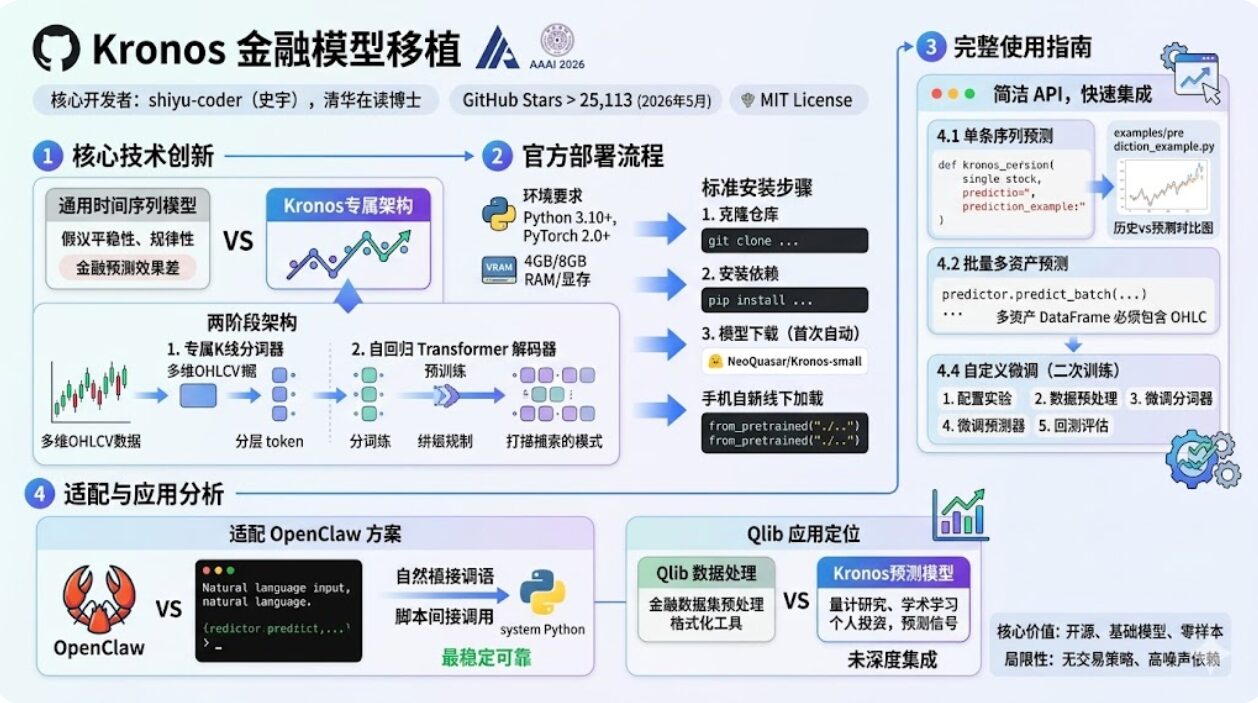
一、项目基础信息:开发者与背景
根据 GitHub API 公开的开发者信息验证,Kronos 的核心开发者为 shiyu-coder(史宇):
- 教育背景:南京大学本科毕业,清华大学在读博士生
- 项目热度:截至 2026 年 5 月,GitHub Stars 突破 25,113
- 开源协议:MIT License,允许个人和商业免费使用
- 学术认可:相关论文已被 AAAI 2026 正式接收
- 训练数据:覆盖全球 45 + 交易所的金融 K 线数据
二、Kronos 的核心定位与技术创新
Kronos 是全球首个专门为金融 K 线数据设计的开源基础模型,它解决了通用时间序列模型在金融场景表现不佳的痛点。通用时间序列模型通常假设数据具有平稳性和规律性,但金融数据具有高噪声、非平稳性、复杂时序依赖等独特特性,导致通用模型在金融预测任务中效果大打折扣。
Kronos 采用了创新的两阶段架构,专门针对金融 K 线数据进行优化:
- 专属 K 线分词器:将连续的多维 OHLCV(开盘、最高、最低、收盘、成交量、成交额)数据量化为分层离散 token,同时保留价格动态和交易活动模式
- 自回归 Transformer 解码器:在离散 token 序列上进行预训练,学习 K 线序列的生成规律和时序依赖关系
这种架构设计让 Kronos 能够更好地捕捉金融市场的复杂模式,在零样本场景下也能取得不错的预测效果。
三、官方标准部署流程
Kronos 的部署非常简单,官方文档明确给出了两步标准流程,无需任何复杂的编译或额外系统依赖。
3.1 环境要求
- Python 3.10+
- PyTorch 2.0+(支持 CPU 和 GPU)
- 至少 4GB 内存(运行 Kronos-small 模型)
- 推荐 8GB 以上显存(GPU 加速推理)
3.2 标准安装步骤
# 第一步:克隆官方仓库
git clone https://github.com/shiyu-coder/Kronos.git
cd Kronos

# 第二步:安装依赖(官方唯一指定命令)
pip install -r requirements.txt
3.3 模型下载说明
Kronos 的所有预训练模型都托管在 Hugging Face Hub 上,首次运行时会自动下载对应的模型和分词器。如果需要离线部署,可以提前手动下载模型到本地:
# 下载Kronos-small模型和分词器
git lfs install
git clone https://huggingface.co/NeoQuasar/Kronos-small
git clone https://huggingface.co/NeoQuasar/Kronos-Tokenizer-base
然后在代码中指定本地模型路径即可:
tokenizer = KronosTokenizer.from_pretrained("./Kronos-Tokenizer-base")
model = Kronos.from_pretrained("./Kronos-small")
四、完整使用指南
Kronos 提供了非常简洁的 API,只需几行代码就能完成从数据加载到预测的完整流程。
4.1 单条 K 线序列预测
这是最基础的使用方式,适用于单个金融资产的走势预测。
from model import Kronos, KronosTokenizer, KronosPredictor
import pandas as pd

# 1. 加载模型和分词器
tokenizer = KronosTokenizer.from_pretrained("NeoQuasar/Kronos-Tokenizer-base")
model = Kronos.from_pretrained("NeoQuasar/Kronos-small")

# 2. 初始化预测器
# max_context参数需要与模型匹配:small/base为512,mini为2048
predictor = KronosPredictor(model, tokenizer, max_context=512)

# 3. 准备输入数据
# 数据必须包含['open', 'high', 'low', 'close']列,volume和amount为可选
df = pd.read_csv("./data/XSHG_5min_600977.csv")
df['timestamps'] = pd.to_datetime(df['timestamps'])

# 定义历史窗口长度和预测长度
lookback = 400  # 历史数据条数,不超过max_context
pred_len = 120  # 预测未来的时间步数

# 提取历史数据和时间戳
x_df = df.loc[:lookback-1, ['open', 'high', 'low', 'close', 'volume', 'amount']]
x_timestamp = df.loc[:lookback-1, 'timestamps']
# 生成预测时间戳(这里假设是5分钟K线)
y_timestamp = pd.date_range(start=x_timestamp.iloc[-1] + pd.Timedelta(minutes=5),
                            periods=pred_len, freq='5T')

# 4. 生成预测
pred_df = predictor.predict(
    df=x_df,
    x_timestamp=x_timestamp,
    y_timestamp=y_timestamp,
    pred_len=pred_len,
    T=1.0,          # 采样温度,值越高随机性越强
    top_p=0.9,      # 核采样概率,值越高多样性越强
    sample_count=1  # 生成的预测路径数量,会自动取平均值
)

# 5. 查看结果
print("预测结果前5行:")
print(pred_df.head())官方还提供了完整的可视化示例脚本examples/prediction_example.py,运行后会生成历史数据与预测数据的对比图。
4.2 批量多资产预测
当需要同时预测多个金融资产时,使用predict_batch方法可以大幅提高效率,它会利用 GPU 并行处理能力同时进行多个序列的预测。
# 准备多个数据集
df1 = pd.read_csv("./data/stock1.csv")
df2 = pd.read_csv("./data/stock2.csv")
df3 = pd.read_csv("./data/stock3.csv")

# 处理每个数据集的时间戳
for df in [df1, df2, df3]:
    df['timestamps'] = pd.to_datetime(df['timestamps'])

# 提取历史数据和时间戳
lookback = 400
pred_len = 120

df_list = []
x_timestamp_list = []
y_timestamp_list = []

for df in [df1, df2, df3]:
    x_df = df.loc[:lookback-1, ['open', 'high', 'low', 'close', 'volume', 'amount']]
    x_ts = df.loc[:lookback-1, 'timestamps']
    y_ts = pd.date_range(start=x_ts.iloc[-1] + pd.Timedelta(minutes=5),
                         periods=pred_len, freq='5T')

    df_list.append(x_df)
    x_timestamp_list.append(x_ts)
    y_timestamp_list.append(y_ts)

# 批量预测
pred_df_list = predictor.predict_batch(
    df_list=df_list,
    x_timestamp_list=x_timestamp_list,
    y_timestamp_list=y_timestamp_list,
    pred_len=pred_len,
    T=1.0,
    top_p=0.9,
    sample_count=1,
    verbose=True
)

# 查看每个资产的预测结果
for i, pred_df in enumerate(pred_df_list):
    print(f"\n资产{i+1}预测结果:")
print(pred_df.head())批量预测注意事项:
- 所有序列必须有相同的历史长度(lookback)和预测长度(pred_len)
- 每个 DataFrame 必须包含 ['open', 'high', 'low', 'close'] 列
- volume 和 amount 列是可选的,如果缺失会自动填充为 0
4.3 无成交量数据预测
如果你的数据中没有成交量和成交额信息,可以使用官方提供的无成交量预测示例examples/prediction_wo_vol_example.py,只需在准备数据时不包含这两列即可。
4.4 自定义数据微调
Kronos 提供了完整的微调脚本,支持用户在自己的数据集上进行二次训练,以获得更好的领域适配效果。官方以中国 A 股市场为例,展示了完整的微调流程。
微调分为四个主要步骤:
- 配置实验:修改
finetune/config.py文件,设置数据路径、训练参数等 - 数据预处理:运行
python finetune/qlib_data_preprocess.py,将原始数据处理成 Kronos 能接受的格式 - 微调分词器:运行
torchrun --standalone --nproc_per_node=NUM_GPUS finetune/train_tokenizer.py - 微调预测器:运行
torchrun --standalone --nproc_per_node=NUM_GPUS finetune/train_predictor.py - 回测评估:运行
python finetune/qlib_test.py --device cuda:0,评估微调后模型的性能
微调后的模型可以像预训练模型一样使用,只需在加载时指定本地检查点路径即可。
五、Kronos 与 OpenClaw 的适配方案
关于 Kronos 与 OpenClaw 的适配,很多朋友都比较关心。目前官方状态是:Kronos 仓库中暂未提供 OpenClaw 专属技能包或相关适配文档。
同时,根据 OpenClaw 的官方规范,标准 SKILL.md 仅支持name和description两个必填字段。
基于两者的技术特性,目前最稳定可行的适配方案是通过脚本间接调用:
- 先在本地服务器上,按照上述官方方法完整部署好 Kronos 环境
- 在 OpenClaw 中编写普通的命令行调用指令,让它调用系统 Python 执行 Kronos 的推理脚本
- 将预测结果以文本或图片的形式返回给用户
这种方法兼容性最好,不会因为 OpenClaw 的版本更新而失效。如果需要更深入的集成,可以在 OpenClaw 侧编写一个简单的包装脚本,将自然语言指令转换为 Kronos 的命令行参数。
六、Qlib 在数据预处理中的应用
关于 Qlib 的使用,官方有明确的定位:它是用来准备和格式化金融数据集的工具。
在 Kronos 的微调流程中,Qlib 的作用是帮助用户将从各个渠道获取的金融数据,处理成 Kronos 能接受的标准格式。官方提供了基于 Qlib 的数据预处理示例脚本,方便用户快速上手。
需要说明的是,Qlib 只是一个数据处理工具,Kronos 本身并没有与 Qlib 的量化策略系统进行深度集成,也没有提供专门的 A 股市场微调模板。用户可以根据自己的需求,使用任何数据处理工具来准备 Kronos 的输入数据。
七、Kronos 的价值与局限性
7.1 核心价值
- 创新价值:Kronos 是全球首个专门针对金融 K 线数据设计的开源基础模型,它提出的两阶段架构为金融时序建模提供了新的思路,推动了金融人工智能领域的发展。
- 实用价值:Kronos 开箱即用,无需复杂的配置就能进行金融时序预测。它提供了多个不同容量的模型版本,适配从个人电脑到服务器的各种计算环境。
- 学术价值:Kronos 的相关论文被人工智能顶会 AAAI 2026 接收,证明了其学术价值。它为金融时序预测领域提供了一个新的基准模型。
- 可扩展性:Kronos 提供了完整的微调脚本,用户可以根据自己的需求在特定市场或资产上进行二次训练,进一步提高预测效果。
7.2 局限性
- 定位限制:Kronos 是一个基础模型,它只负责生成预测信号,不包含任何量化交易策略、实盘交易接口或风控逻辑。用户需要自己构建完整的量化交易系统。
- 性能未公开:官方没有在 README 中发布具体的性能指标和实盘回测数据,用户需要自己验证模型在特定场景下的效果。
- 推理速度:虽然 Kronos 提供了轻量化模型,但对于高频交易场景来说,推理速度仍然不够快,更适合中低频的量化策略。
- 数据依赖:预测结果的准确性高度依赖于输入数据的质量和完整性,垃圾数据会导致垃圾预测。
7.3 适用场景
- 量化研究:作为量化研究的工具,生成预测信号
- 学术研究:用于金融时序建模相关的学术研究
- 个人投资者:作为投资决策的辅助工具
- 金融机构:用于内部的金融数据分析和风险评估
八、写在最后
Kronos 确实是一个非常优秀的金融时序模型,它为量化研究提供了一个强大的基础工具。通过 Kronos 生成的预测信号,可以结合个人的交易策略和风控体系,构建完整的量化交易系统。
最后提醒一句:金融市场有风险,任何模型的预测结果都仅供参考,投资决策需要结合多方面因素综合判断。