
快速落地方法: 本文及本站大部分openclaw相关文章,都可以让Openclaw agent阅读,然后进行应用,参考Prompt如下: 请阅读这篇文章:
https://www.aiec.fun/%e4%bb%8eclaude-mem%e5%88%b0openclaw%ef%bc%9a9%e5%a4%a9%e6%89%93%e9%80%a0%e4%b8%93%e5%b1%9eai%e6%8c%81%e4%b9%85%e5%8c%96%e8%ae%b0%e5%bf%86%e6%8a%80%e8%83%bd/ 分析有哪些内容,对我们优化工作流程有价值。并严格根据openclaw/Darwin-Skill最新官方文档进行核对,排除错误及过时信息,制定落地计划,安装和部署GBrain。 详细方法,参考文章 >>>
一、项目概述
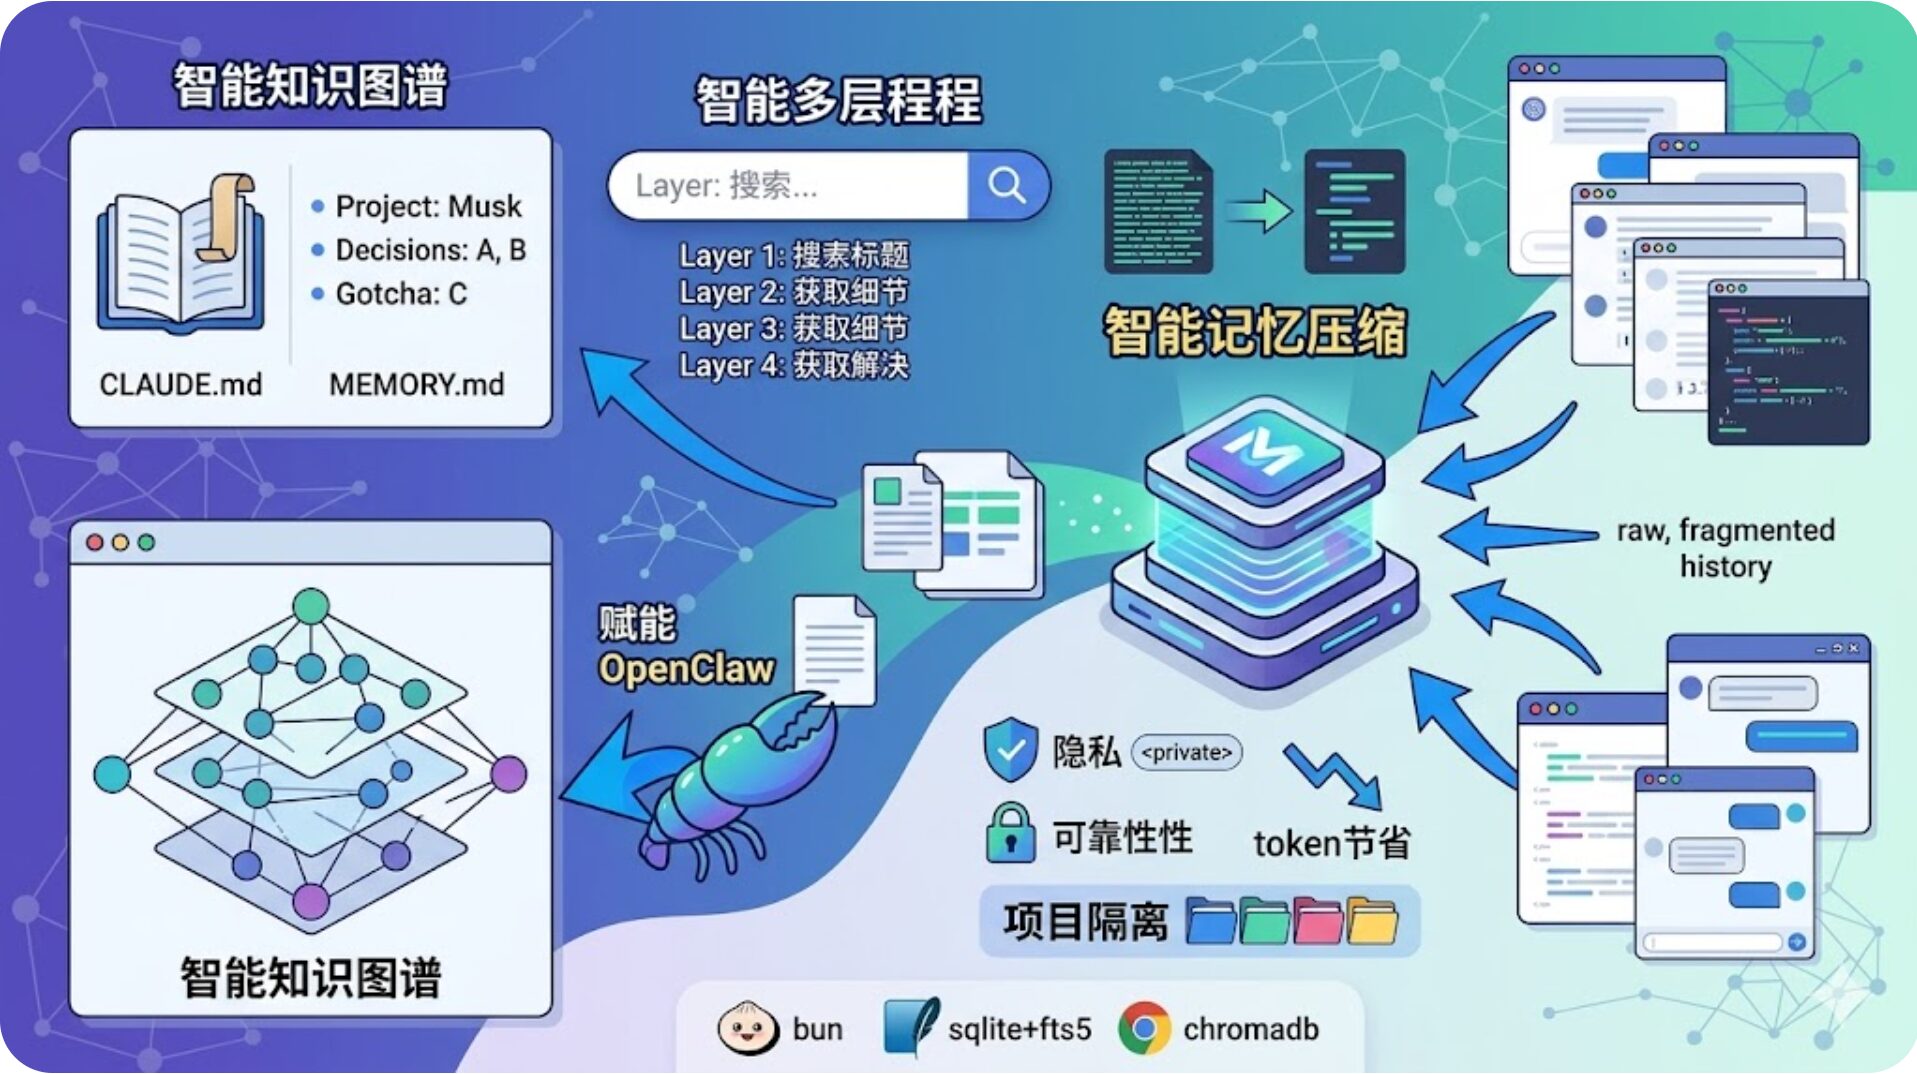
Claude-Mem是由 Alex Newman (@thedotmack) 开发的开源持久化记忆压缩系统,专为 AI 编码助手设计。截至 2026 年 5 月,项目已发布多个大版本,持续活跃迭代,在 GitHub 上获得了广泛关注,是目前最成熟、最实用的 AI代理个人记忆解决方案之一。- GitHub 仓库:github.com/thedotmack/claude-mem
- 官方文档:claude-mem.ai/docs
- 许可证:Apache-2.0
- 核心定位:彻底解决 AI 助手的 "上下文失忆" 问题,使 AI 能够跨会话记住个人项目历史、决策和偏好
二、核心价值与作用
1. 解决 AI 开发的核心痛点
Claude-Mem 精准击中了所有 AI 编码助手共有的致命缺陷 ——"上下文失忆":- 每次会话结束后,AI 会完全忘记所有项目上下文
- 开发者需要反复向 AI 解释项目结构、技术栈和历史决策
- 大量宝贵的 token 被浪费在重复的上下文说明上
- 多日开发任务的连续性被无情打断
2. 核心功能特性
3. 技术架构优势
Claude-Mem 采用了精心设计的分层解耦架构,确保了高性能和高可靠性:- 插件钩子层:轻量级 IDE 钩子,不阻塞主会话执行
- 工作服务层:独立的 Bun 进程处理 AI 压缩和 HTTP 请求
- 数据库层:SQLite+FTS5 提供高性能本地持久化存储
- 搜索层:混合搜索系统支持自然语言查询
- UI 层:实时 SSE 推送的 Web 管理界面
三、对 OpenClaw (小龙虾) 的参考价值
1. 架构层面的参考
Claude-Mem 的以下架构设计理念对 OpenClaw 有重要的借鉴意义:- 非阻塞后台处理:所有计算密集型的记忆压缩和索引操作都在独立的工作进程中进行,不影响主代理的执行
- 标准化生命周期钩子:通过定义清晰的钩子接口,实现了与 IDE 的无缝集成
- 混合搜索策略:结合全文搜索的精确性和向量搜索的语义理解能力
- 渐进式披露机制:先返回轻量级索引,再按需获取详细内容,最大化 token 效率
- 事务安全存储:使用 SQLite 的 WAL 模式确保数据一致性,防止系统崩溃导致的数据丢失
2. 功能层面的参考
Claude-Mem 的以下功能设计可以直接借鉴到 OpenClaw 中:- 结构化观察设计:将原始工具输出转化为包含 title、narrative、facts、concepts 等字段的标准化格式
- 会话交接生成:在会话结束时自动生成结构化的交接文档
- 知识 agent 工作流:Build→Prime→Query 的知识处理流程
- 文件夹文档自动生成:根据项目内容自动生成标准化的项目文档
- 内容类型分类:为不同类型的内容 (bugfix、feature、refactor、discovery、decision、change) 设置不同的处理策略
3. 最佳实践参考
Claude-Mem 经过多个版本的迭代,积累了大量 AI 记忆系统的宝贵最佳实践:- 概念标签系统:使用 how-it-works、why-it-exists、what-changed、problem-solution、gotcha、pattern、trade-off 等标签对观察进行分类
- 用户 / 代理分离:将用户输入与代理生成的操作记忆分开处理
- 资源优先原则:静态知识 (如架构文档、API 参考) 不应用时效性衰减
- 渐进式加载:根据 token 预算动态调整注入的上下文量
- 手动清理机制:用户可通过 clean 命令手动清理不再需要的 folder CLAUDE.md 文件
四、OpenClaw 集成可行性深度分析
1. 官方支持状态
Claude-Mem 官方文档列举的受支持 IDE 包括:Claude Code, Cursor, Gemini CLI, Windsurf, OpenCode, Codex CLI, OpenClaw。OpenClaw 在列表中排在最后,说明集成深度明显不及 Claude Code 原生,且官方文档未提供 OpenClaw 的专门集成步骤。 GitHub 仓库中确实存在openclaw/目录,包含 OpenClaw 集成代码,但具体功能完整性和稳定性需要进一步验证。
2. 官方安装方式
Claude-Mem 官方提供三种标准安装方式:- 推荐方式:bash运行
npx claude-mem install该命令会启动交互式安装程序,要求用户手动选择 IDE,不具备自动检测 OpenClaw 的能力。 - 插件市场方式:bash运行
/plugin marketplace add thedotmack/claude-mem /plugin install claude-mem - 源码编译方式:bash运行
git clone https://github.com/thedotmack/claude-mem.git cd claude-mem npm install npm run build
3. 集成难度评估
4. Claude-Mem 对 OpenClaw 的适配分析
核心结论:OpenClaw 的最大差距有两个:一是没有工具调用级的钩子机制,这是 Claude-Mem 实现全自动记忆的核心;二是没有原生的 "会话结束" 事件,无法在用户离开会话时自动触发压缩。但其余功能 (结构化压缩、3 层检索、会话摘要) 都可以通过定时任务 + 子 agent+skill 开发来模拟。五、最优解:OpenClaw 专属轻量级记忆助手
1. 为什么不直接安装 Claude-Mem
2. 轻量级记忆助手能解决的核心问题
3. 开发方法:用 OpenClaw 开发 OpenClaw
核心思路:完全使用 OpenClaw 本身的能力来开发这个工具,不需要任何额外的外部框架。 关键发现:OpenClaw 的钩子体系按 turn / 事件粒度设计,没有等效的 session-end 兜底钩子。agent_end属于插件钩子而非内部钩子,无法通过~/.openclaw/hooks/目录注册,只能通过开发完整插件实现。它每次 turn 结束后触发,是 fire-and-forget 模式,不能可靠地启动异步子 agent。因此,cron 定时任务是最直接可靠的触发方案,也是目前唯一不需要开发插件就能实现的方式。
推荐方案流程图:
cron定时任务(每小时/每天)
    ↓
    调用sessions_spawn --session isolated
        ↓
    启动"记忆压缩"子agent
        ↓
    读取 session → 生成摘要 → 输出摘要.md + 原始.jsonl
        ↓
    读取sessions_history
        ↓
    生成结构化压缩(结论/决策/待办/知识点)
        ↓
    写入memory/YYYY-MM-DD.md
        ↓
同步GBrain typed links原始记录(系统目录,不动):
~/.openclaw/agents/musk/sessions/
d44cbc8a...jsonl ← timestamp: 2026-05-17T00:21
abc123...jsonl ← timestamp: 2026-05-17T11:45
def456...jsonl ← timestamp: 2026-05-16T19:02
摘要记录(新目录):
memory/
2026-05-17/
session-d44cbc8a-summary.md ← 对应 d44cbc8a...jsonl
session-abc123-summary.md ← 对应 abc123...jsonl
2026-05-17-daily-index.md ← 日级索引
2026-05-16/
session-def456-summary.md ← 对应 def456...jsonl
2026-05-16-daily-index.md4. 详细开发步骤
第一步:设计"摘要生成Prompt"(Day1) 目标:生成一份高质量的会话摘要 Prompt,不删除原始 交付物:- memory-session-summary/SKILL.md
## Session 摘要 Prompt(每个 session 生成一份)
---
title: [该 session 的一句话主题]
date: [会话日期]
session_key: [原始 session key]
summary_type: session_summary
---
## 会话结论
- [具体结论]
## 知识点
- [新认知]
## 待办事项
- [ ] [待办] @[负责人]
## 日级索引 Prompt(每天生成一份)
---
title: [日期] 日汇总
date: [日期]
summary_type: daily_index
---
## 今日会话索引
| 时间 | Session | 主题 | 结论 |
|------|---------|------|------|
| 09:00 | sess_xxx | TradingAgents-CN部署 | 确认API格式问题 |
| 11:00 | sess_yyy | 轻量级记忆助手 | 采用方案A |
## 今日关键结论
- [最重要的结论1]
- [最重要的结论2]
## 今日待办
- [ ] [待办1]# memory-session-compress
## 描述
将指定会话记录压缩为结构化的摘要,包含会话结论、知识点和待办事项。
## 触发方式
由cron定时任务或agent主动触发,无需用户手动调用。
## 参数
- session_key: 要压缩的会话唯一标识(可选,默认为当前会话)openclaw cron add
--name "memory-compress"
--cron "0 * * * *"
--session isolated
--message "扫描所有未压缩的会话,调用 memory-session-compress skill 生成结构化摘要,写入 memory/YYYY-MM-DD.md 并同步 GBrain"memory_search一个搜索工具,在AGENTS.md 中增加 3 层检索指引,通过prompt 指令实现三层检索逻辑,无需创建新工具:
六、总结与建议
1. 项目价值总结
Claude-Mem 是目前最成熟、最实用的 AI 代理个人持久化记忆解决方案。它通过自动观察、AI 压缩和智能检索,彻底解决了 AI 助手的 "上下文失忆" 问题,大幅提升了个人开发效率。对于 OpenClaw 生态来说,Claude-Mem 是一个极具参考价值的项目,其架构设计和功能实现为 OpenClaw 的记忆系统提供了优秀的范本。2. 最终建议
短期建议:不推荐直接安装 Claude-Mem。由于 OpenClaw 缺乏工具调用级钩子和原生会话结束事件,直接安装的集成价值非常有限,反而可能与现有的 GBrain/MEMORY.md 系统产生冲突。 中期建议:启动轻量级记忆助手项目。先从 Phase 1 开始,设计并测试压缩 Prompt,在真实业务中验证效果。这一步不需要开发人员介入,产品或运营人员即可完成。触发机制使用 cron 定时任务,这是目前唯一不需要开发插件就能实现的可靠方案。 长期建议:逐步完善记忆系统。在验证了压缩效果和触发机制后,再逐步开发 Skill、配置 cron 任务、实现 3 层检索,最终打造一个完全适配 OpenClaw 架构和业务需求的专属记忆系统。如果需要更实时的触发机制,可以考虑开发完整的 OpenClaw 插件来使用agent_end钩子。
3. 未来展望
随着 AI 代理技术的不断发展,持久化记忆将成为 AI 助手的核心竞争力之一。通过借鉴 Claude-Mem 的先进理念并结合 OpenClaw 的自身特点,我们可以打造一个更加强大、更加智能、更加贴合业务需求的 AI 开发助手,为团队带来显著的效率提升。 同时,我们也期待 OpenClaw 官方能够在未来版本中添加原生的会话结束钩子和工具调用拦截机制,这将极大地降低记忆系统的开发难度,推动整个生态的发展。
阅读量:
258