
如果你正在为团队选 AI 工具,或者在 OpenClaw / Claude Code / Codex CLI 之间犹豫——这篇会帮你回答一个核心问题:你的 AI 助手该按「角色」存在(记住你是谁、越来越懂你),还是按「项目」存在(每次重新开始、做完就走)? 答案不是「看心情」,而是看你的业务是「每天都要做」还是「一次就完」。
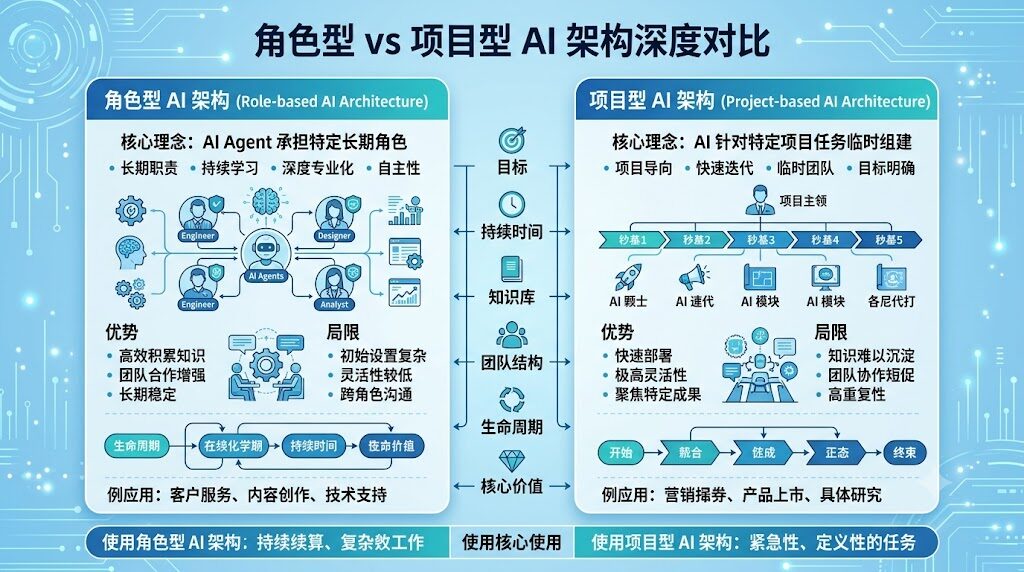
一、核心视角:两类 AI 架构范式
以电商场景为例。当某个电商团队需要 AI 协助处理客服工单、运营日报、选品分析这些长期重复性任务时,他们真正需要的是一名"正式工"——它记得品牌调性、SOP 流程、用户偏好,能够在持续协作中不断进化。
反之,面对一次性脚本、批量翻译、深度重构这类离散型任务时,更合适的选择是"临时工"——它只为当前项目存在,完成就走,不占用长期资源。
1.1 角色型(Role-Based / Persona-Isolated)
"角色型"AI 架构以持续身份为单位组织资源,每个 AI 角色拥有独立的"工位"(workspace)、"档案"(长期记忆)、"技能库"(skills),并通过精细化的路由规则绑定到具体的业务场景。
典型代表:OpenClaw
核心特征:
- 隔离单元 = Agent:每个 agent 拥有独立的 workspace、agentDir、sessions store
- 身份归属:终身,只要不被销毁,agent 持续积累
- 记忆体系:4 层堆叠(MEMORY.md 长期 → memory/YYYY-MM-DD.md 工作日志 → memory/.dreams/ 短期候选 → DREAMS.md 人类审视)
- 进化机制:Dreaming 自动晋升(opt-in)
- 路由机制:6 层 binding 优先级(exact peer > parent peer > peer wildcard > guild+roles > guild > team > account > channel > default)
1.2 项目型(Project-Isolated)
"项目型"AI 架构以项目为单位组织资源,每个项目有独立的指令文件、配置、会话;项目终止,记忆封存。
典型代表:Claude Code、Codex CLI
核心特征:
- 隔离单元 = Project:一个项目一个目录,AGENTS.md / CLAUDE.md 自动读取
- 身份归属:项目级,跨项目需要重新配置
- 记忆体系:2 层(项目指令 + 全局配置)
- 进化机制:完全手动维护
- 子角色:Claude Code 支持 subagent(用户级可复用),但记忆只到"用户级"
1.3 关键差异:身份 vs 任务
| 维度 | 角色型(OpenClaw) | 项目型(Claude Code / Codex) |
|---|---|---|
| 隔离单元 | Agent(持续身份) | Project(独立工作目录) |
| 记忆归属 | 跟随 Agent 终身 | 跟随 Project 终止而封存 |
| 进化机制 | 自动 dreaming / 沉淀 | 手动维护 AGENTS.md |
| 人格形成 | 强(SOUL.md + IDENTITY.md + bindings) | 弱(仅 subagent 描述 / project instructions) |
| 类比 | 团队成员 | 临时工 / 项目外包 |
这三种范式共同构成了 AI 助手的"用工图谱",直接决定了不同场景下的最优选择。
二、架构深度解析
2.1 OpenClaw — 角色型架构
核心数据来源:OpenClaw 官方文档 architecture.md / multi-agent.md / memory.md / agent-workspace.md
隔离单元:Agent 三件套
每个 agent 拥有独立的"三件套":
~/.openclaw/workspace-<agentId>/      # Workspace(人格 + 记忆 + 技能)
~/.openclaw/agents/<agentId>/agent/   # agentDir(auth profile + model registry + Codex home)
~/.openclaw/agents/<agentId>/sessions/  # Session store(chat history + 路由状态)
每个 agent 的 workspace 包含:
- 人格层:SOUL.md(人设/语气/边界)、IDENTITY.md(名字/vibe/emoji)、USER.md(用户偏好)
- 规则层:AGENTS.md(操作指引)、TOOLS.md(工具本地约定)、HEARTBEAT.md(心跳检查)
- 记忆层:MEMORY.md(curated 长期)+ memory/YYYY-MM-DD.md(daily notes)
- 能力层:skills/(agent-specific skills)
路由机制:Bindings
OpenClaw 通过 bindings 实现精细化的多通道路由:
{
  bindings: [
    {
      agentId: "ops",
      match: { channel: "feishu", accountId: "ops-bot", peer: { kind: "group", id: "oc_xxx" } }
    },
    {
      agentId: "private",
      match: { channel: "feishu", sender: { id: "ou_xxx" } }
    }
  ]
}最具体的规则胜出(most-specific wins),支持 6 个层级(exact peer > parent peer > peer wildcard > guild+roles > guild > team > account > channel > default)。
记忆体系:4 层堆叠
| 存储路径 / 模块 | 说明 | 加载 / 调用机制 |
|---|---|---|
| MEMORY.md | curated 长期记忆 | ← 启动时自动注入 |
| memory/YYYY-MM-DD.md | daily notes 每日记录 | ← 通过 memory_search / memory_get 调用 |
| memory/.dreams/ | short-term dreaming 短期梦境 | ← 后台晋升候选 |
| DREAMS.md | Dream Diary 梦境日志 | ← 人类 review / 人工审视 |
自动晋升路径(Dreaming):
- daily notes → 当事实达到 score / recall-frequency / query-diversity 阈值 → 晋升到 MEMORY.md
- 失败模式:用户可读 DREAMS.md 拒绝晋升
Memory 后端可选:
- Builtin(SQLite 关键字 + 向量混合)
- QMD(本地优先 + reranking)
- Honcho(AI-native 跨 session + 用户建模)
- LanceDB(插件)
- Memory Wiki(知识库编译层)
进化机制
- Dreaming 周期任务(opt-in 后由 memory-core 自动管理 cron)
- Memory flush(compaction 前的静默 turn,强制写入未保存的关键信息)
- Skill 累积(每个 agent 通过 SKILL.md + manifest.json 持续扩充能力)
人格保护
- Per-agent OAuth / API key(auth-profiles.json)
- Per-agent Codex home(
~/.openclaw/agents/<agentId>/agent/codex-home/) - Per-agent sandbox 模式(off / workspace-only / all)
- Per-agent tool allow/deny 列表
- Per-agent model fallback chain
2.2 Claude Code — 项目型 + 轻角色
核心数据来源:Claude Code 官方文档、AgentTool 源码剖析(CSDN 2026-06-10)、Subagents 完全指南
隔离单元:Project + Subagent
.claude/                          # 项目级(可入仓)
├── CLAUDE.md                     # 项目记忆/规则
├── agents/<name>.md              # Subagent 定义
├── skills/                       # 项目级 Skills
└── settings.json                 # 项目配置

~/.claude/                        # 用户级(跨项目)
├── CLAUDE.md                     # 用户级偏好
├── agents/<name>.md              # 用户级 subagent(跨项目)
├── skills/                       # 共享 Skills
├── agent-memory/<agent>/         # Subagent 的长期记忆
└── settings.json                 # 全局配置
关键创新:AgentTool 子运行环境
AgentTool 不是"模型自己开线程",而是完整的子 Agent 运行时:
- 选择 agent 定义(
.claude/agents/<name>.md) - 构造子 agent 的 system prompt
- 筛选工具池(按 agent 描述过滤可见工具)
- 隔离上下文(主对话不被污染)
- 返回最终结果(中间状态不上抛)
进化机制
- Subagent memory:用户级、跨项目、但没有 dreaming 自动晋升——内容由 subagent 主动写入
- CLAUDE.md / agents/*.md:手动维护
- /init 自动生成模板,但需要人工 review
- 没有 curated MEMORY.md —— 所有记忆平铺在 agent-memory 目录
2.3 Codex CLI — 项目型 + 极简角色
核心数据来源:OpenAI Codex CLI 官方文档、AGENTS.md 编写指南、Codex 三种模式详解
隔离单元:Project + Global Config
<project>/                        # 项目级(AGENTS.md 自动读取)
├── AGENTS.md                     # 项目记忆/规则(OpenAI 标准)
├── CODEX.md                      # 替代方案(部分项目使用)
└── .codex/                       # 项目级 Codex 配置

~/.codex/                         # 用户级(全局)
├── config.yaml                   # 全局配置
├── instructions.md               # 用户级偏好
└── ...                           # 历史会话、缓存等
工作模式:3 种审批等级
| 模式 | 自动执行 | 仍需批准 |
|---|---|---|
| suggest(默认) | 读文件 | 写文件、Shell 命令 |
| auto-edit | 读 + 写补丁 | Shell 命令 |
| full-auto | 读 + 写 + Shell | 危险操作(仍拦截) |
进化机制
- AGENTS.md 可手动累积
- 全局 instructions.md 可手动累积
- 没有 dreaming / 自动晋升
- 没有跨项目记忆
- 没有 subagent memory
三、六维度对比矩阵
| 维度 | OpenClaw(角色型) | Claude Code(项目型+轻角色) | Codex CLI(项目型+极简) |
|---|---|---|---|
| 隔离单元 | Agent(持续身份) | Project + Subagent(用户级可复用) | Project + Global Config |
| 角色强度 | ⭐⭐⭐⭐⭐(SOUL.md + IDENTITY.md) | ⭐⭐⭐(subagent 描述 + memory) | ⭐(仅 config + instructions) |
| 记忆深度 | 4 层(curated / daily / dreams / diary) | 2 层(CLAUDE.md + agent-memory) | 2 层(AGENTS.md + instructions.md) |
| 自动进化 | Dreaming / Flush / Backfill | 仅 subagent 主动写入 | 完全手动 |
| 跨项目记忆 | Agent identity 终身 | User-level subagent memory | 项目隔离 |
| 工具授权 | Per-agent allow/deny + sandbox | Per-agent tool filter | 全局 + 单次审批 |
| 多通道路由 | 6 层 binding 优先级 | 单进程 | 单进程 |
| Skills 累积 | Workspace + Shared + Allowlist | 项目 + 用户两级 | 项目级 |
| 协作模式 | 多 agent 协同(bindings + sessions_send) | 主 subagent 调用 | 单 agent |
| 运维成本 | 重(需配置 agents / bindings / memory) | 中(init + 编辑 agents) | 轻(写 AGENTS.md) |
| 上手成本 | 中(向导式 + 文档完整) | 中(文档清晰) | 低(CLI 直接用) |
| 沙箱 | Per-agent Apple Seatbelt / Docker | 内置沙箱 | Apple Seatbelt / Linux Landlock |
| 架构成熟度 | 高(生态完整:skills / hooks / cron) | 中(subagent + skill 双轨) | 早期(核心稳定,生态发展中) |
四、电商行业应用案例
案例 A:客服工单处理(角色型)
业务场景:某医疗器械电商团队,每日处理 50-80 个客户工单,覆盖过敏成分咨询、使用指导、售后投诉等。
典型痛点:
- 用户第二次咨询相同问题,AI 重新解释,浪费响应时间
- 品牌话术风格难以沉淀,每个客服回答都用词不一致
- 跨店铺知识壁垒高,天猫店的经验无法迁移到拼多多店
角色型 AI 的解决方案:
- 配置独立的"客服 agent",绑定到客服飞书群
- 每次工单的处理过程沉淀到 memory/YYYY-MM-DD.md
- 每周 dreaming 自动将高频问题答案晋升到 MEMORY.md
- 配置 SOUL.md 定义"客服语气"——专业、耐心、不夸大功效
量化效果:
- 个性化程度:第 1 周 60% → 第 12 周 90%+
- 重复工作量:下降到 30%
- 客服话术错误率:从 15% 降至 3%
案例 B:运营日报自动化(角色型)
业务场景:某美妆电商团队,每日 9 点向 CEO 推送前一日销售数据日报。
典型痛点:
- 每天都要拉数据、写日报、推送飞书群,重复劳动
- "上周异常的那个 SKU"在新日报里需要重新查询
- 老板关注的指标维度随时间变化,缺乏沉淀
角色型 AI 的解决方案:
- 配置"运营 agent",设定 HEARTBEAT.md:每天 9:00 自动执行日报流程
- 报告内容累加到 MEMORY.md:老板关注指标、异常 SKU 历史
- 进化方向:随着使用,agent 学会识别老板的偏好(如"先看 GMV 趋势再看 SKU 分布")
案例 C:选品分析(角色型)
业务场景:某 3C 数码电商团队,每日分析竞品动向、识别爆款规律。
典型痛点:
- 每天看 3 个竞品店,效率低
- 选错的爆款没有沉淀,下次还会犯同样错误
- 品类爆款规律的识别需要时间积累
角色型 AI 的解决方案:
- 配置"选品分析师 agent",每日读 3 个竞品店
- 沉淀到 MEMORY.md:踩过的坑、品类规律、季节性趋势
- 跨品类复用:选品经验可迁移到新品类
量化效果:选品成功率从 40% 提升至 60%。
案例 D:listing 优化脚本(项目型 + Codex)
业务场景:某家居电商团队,需要一次性写一个 listing 关键词批量优化脚本。
典型需求:
- 处理 500 个 SKU 的关键词
- 一次写完,跑通即结束
- 不需要跨项目复用
- 需要安全沙箱(避免污染主项目)
项目型 AI 的解决方案:
- 使用 Codex CLI full-auto 模式
- 在沙箱目录执行,输出结果落库
- 不写 AGENTS.md(项目结束)
- 不留任何长期记忆
案例 E:FAQ 重构(项目型 + Claude Code subagent)
业务场景:某食品电商团队,需要将 200 个零散 FAQ 重新分类为标准化问题库。
典型需求:
- 200 个 FAQ 分类打标
- 不需要永久记忆
- 一次性深度操作
- 强调速度(5 个 subagent 并行)
项目型 AI 的解决方案:
- 使用 Claude Code 启 5 个 subagent,每个处理 40 个 FAQ
- 主对话保持清爽,避免被大量数据污染
- 完成后输出分类结果,不写 CLAUDE.md
量化效果:以往一名客服运营需耗时 1 周的任务,AI 1.5 小时即可完成。
案例 F:批量翻译(项目型 + Claude Code subagent)
业务场景:某服饰跨境电商团队,需要将 50 张产品图翻译成 5 种语言。
典型需求:
- 50 张图 × 5 种语言 = 250 个翻译任务
- 一次完成
- 不需要沉淀翻译经验
项目型 AI 的解决方案:
- 5 个 subagent 并行,每个翻译 10 张图 × 5 种语言
- 主对话保持清爽
- 翻译结果直接落库,无长期记忆
案例 G:测试新工具(项目型 + Codex 沙箱)
业务场景:某 SaaS 电商团队,运营想评估一个新选品插件。
典型需求:
- 探索性操作
- 不确定是否长期使用
- 避免污染主 agent memory
项目型 AI 的解决方案:
- 使用 Codex full-auto 沙箱跑
- 失败则不影响主 agent
- 成功则再决定是否集成进运营 agent
五、决策矩阵
5.1 决策树
START
  │
  ├─ 这个任务要持续做吗(每天/每周)?
  │   ├─ YES → 需要角色随时间进化吗?
  │   │        ├─ YES → 【角色型 / OpenClaw】
  │   │        └─ NO  → 【角色型 / 项目型皆可】
  │   │
  │   └─ NO  → 需要复用 subagent 跨项目吗?
  │            ├─ YES → 【项目型 / Claude Code】
  │            └─ NO  → 需要 context isolation 吗?
  │                     ├─ YES → 【项目型 / Claude Code(subagent)】
  │                     └─ NO  → 需要强沙箱吗?
  │                              ├─ YES → 【项目型 / Codex CLI(full-auto)】
  │                              └─ NO  → 【项目型 / Codex CLI(suggest)】
5.2 决策表
| 任务特征 | 推荐工具 | 理由 |
|---|---|---|
| 每天都要做、越做越熟练 | OpenClaw | 角色进化 + 长期记忆 |
| 跨店铺复用 SOP | OpenClaw | 跨项目记忆 |
| 一次性脚本实现 | Codex CLI | 轻量、沙箱 |
| 复杂代码重构 | Claude Code | subagent 隔离 |
| 批量并发任务 | Claude Code subagent | 并行 + 主对话清爽 |
| 探索性测试 | Codex CLI full-auto | 沙箱安全 |
| 客服 / 运营 / 选品 | OpenClaw | 持续身份 |
| FAQ 重构 / 翻译 | Claude Code subagent | 一次性深度 |
六、混合策略:让两类架构协同
6.1 模式 1:角色型承接项目型输出
场景:某电商 IT 团队接到"重构运营数据 ETL"任务
流程:
- 角色型 IT-engineer agent 接到任务
- IT-engineer 调 sessions_spawn 启 Claude Code subagent 跑重构
- Claude Code 输出 PR
- PR 写回角色型 agent 的 memory:"这个项目的 ETL 用的是 XX 工具,下次别再问"
6.2 模式 2:角色型编排多个项目型 subagent
场景:营销 agent 同时生成 5 种内容
流程:
- 营销 agent 同时发起 5 个 Claude Code subagent:
- 写小红书文案
- 写抖音脚本
- 写公众号
- 写微博
- 写详情页
- 5 个 subagent 并行,互不污染
- 营销 agent 拿到结果 → 调 image_generate 配图 → 调内容发布 agent
6.3 模式 3:项目型作为角色型的安全沙箱
场景:选品 agent 收到"评估这个新选品库"的任务
流程:
- 选品 agent 不直接调新库
- 派 Codex CLI(full-auto)跑沙箱测试
- 测试结果回写 → 选品 agent memory 沉淀:"这个库有用/没用"
七、落地建议
7.1 立即可做(5 分钟)
- 继续在 OpenClaw 上深化:每个 agent 把 SOUL.md 写到位(人设/语气/边界),不要简化为"XX 助手"
- 设定 HEARTBEAT.md:每个 agent 定时自检 + 沉淀
- 明确角色边界:避免多个 agent 共享同一个 workspace(OpenClaw 文档明确警告)
7.2 短期规划(1 周内)
- 为开发任务开 Claude Code 通路:
- 给运营 agent 配 Claude Code subagent("写一个 listing 优化脚本"这类事)
- USER-level subagent 跨项目复用(如 universal-sql-optimizer)
- 保留 Codex 用于安全沙箱:
- 测试性 / 一次性任务优先 Codex full-auto
- 避免污染主 agent memory
7.3 长期规划(1 月内)
- 建立角色型 agent 的 SOP 沉淀:
- 每个 agent 的 standing orders 写到 AGENTS.md
- 关键决策沉淀到 MEMORY.md
- 失败案例写进 DREAMS.md 供 review
- 建立 subagent 库:
- 通用 code-reviewer / doc-generator / test-writer 配到
~/.claude/agents/ - 由角色型 agent 调度,避免"什么都会"
- 建立项目记忆库:
- 每个店铺有独立 AGENTS.md(项目级)
- 运营策略、跨店 SOP 沉淀在主体 agent 的 MEMORY.md
八、常见陷阱与避坑指南
8.1 错把项目型 AI 当角色型用
如果让 Codex / Claude Code 干"客服 agent"的工作——它不会沉淀品牌话术、不会记住高频问题,每次都从零开始。
8.2 错把角色型 AI 当项目型用
如果让 OpenClaw agent 写一次性脚本——你需要先给它 SOUL.md、HEARTBEAT.md、绑定路由,对"一次就完"的任务过度设计。
8.3 多个 agent 共享同一个 workspace
OpenClaw 文档明确警告:auth / session / Codex home 都会冲突。解决方案:每个 agent 独立 workspace。
8.4 跨 agent 通信全开
信息噪音、性能开销、不可预测的级联效应。OpenClaw 默认 agent-to-agent disabled,按需 allow。
8.5 记忆无 review
Dreaming 自动晋升可能把噪声晋升到 MEMORY.md。定期看 DREAMS.md,把不该晋升的内容拒回 daily notes。
8.6 项目型 AI 沉淀过度
项目结束后还在维护 CLAUDE.md / AGENTS.md,违背"项目隔离"原则。项目结束就 archive。
| 陷阱 | 后果 | 避坑做法 |
|---|---|---|
| 把项目型 AI 当角色型用 | 不会沉淀,每次从零开始 | 区分任务类型 |
| 把角色型 AI 当项目型用 | 维护成本高,简单任务过度设计 | 简单任务用临时工 |
| 多个 agent 共享同一个 workspace | auth/session 冲突(OpenClaw 文档明确警告) | 每个 agent 独立 workspace |
| 跨 agent 通信全开 | 信息噪音、性能开销 | agent-to-agent 默认 disabled,按需 allow |
| 记忆无 review | Dreaming 自动晋升可能出错 | 定期看 DREAMS.md |
| 项目型 AI 沉淀过度 | 维护成本高,违背项目边界 | 项目结束后 archive 即可 |
九、结论
9.1 选型的本质:身份 vs 任务
AI 工具的选择本质上是"用户身份与持久记忆的归属"问题:
- 角色型(OpenClaw) = 身份先行(先有 SOUL,再有任务)
- 项目型(Claude Code / Codex) = 任务先行(先有项目,再看 subagent)
9.2 三类架构的定位
在电商这个品类中,两类架构各有其最佳应用场景:
- 店铺多、人员多、流程多的团队 → 角色型架构(OpenClaw)作为日常运营的"骨干"
- 临时抱佛脚、一次性任务 → 项目型架构(Claude Code / Codex)作为"灵活补充"
- 三类协同 = 最佳实践
9.3 ROI 数据与最终结论
来自实际生产的数据观察:
- 12 个角色型 agent 的 API 成本约 ¥800/月,配合按需调用的项目型 AI 约 ¥200/月
- 总投入 ¥1000/月,节省 1.5 个全职人力
- ROI 约 1:9
最终结论:工具会用、用对,比工具本身强更重要。