
当 AI 帮你分析一个 EXE、DLL、SYS 文件,它有多大概率是瞎编的?
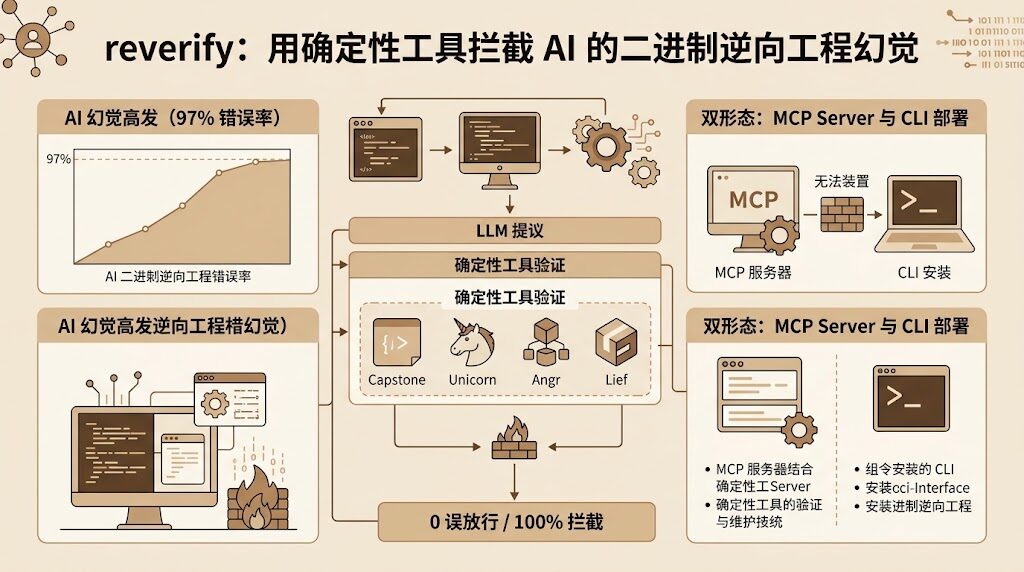
答案是 97%——这是 2akouwu/reverify 作者在 71 个真实 Windows 系统文件上跑出来的基准数据。LLM 在二进制逆向场景的幻觉率,比大多数人的直觉还要高两个数量级。
而 reverify 做了一件反直觉的事:它不去让 LLM "更谨慎",而是在 LLM 和结果之间插入一个确定性验证层。 模型照样可以"自信地胡说",但所有声明在交付前必须通过反汇编、字节模式匹配、CPU 模拟执行等确定性工具的审计。
结果:
- AI 教科书式回答错误率:97%
- reverify 拦截所有错误声明:100%
- 误放行率(False Positive):0
这不是营销话术,而是一个可复现的基准测试。对比当下大多数"反幻觉"方案只能定性描述,reverify 把反幻觉变成了可量化、可审计的工程实践。
下面我们拆解它的架构、验证工具链,以及对内容运营者和 Agent 工程师能借鉴什么。
一、reverify 是什么
| 维度 | 信息 |
|---|---|
| 项目名 | 2akouwu/reverify |
| Star | 1,036+(2026-09-10 数据) |
| Fork | 230+ |
| 许可证 | MIT |
| 语言 | Python |
| 作者 | 2akouwu |
| 创建时间 | 2026-08-31 |
| 最后提交 | 2026-09-07 |
| 定位 | AI 逆向工程的确定性验证层 |
核心定位一句话:LLM proposes, tools verify. 模型负责提议,工具负责审计,AI 自己说的不算。
二、问题:AI 在二进制场景为什么这么容易"瞎编"
逆向工程是一个对 AI 极其不友好的场景。LLM 在自然语言和代码层面表现良好,但面对二进制字节流时:
- 训练数据里几乎没有真实汇编指令的"语义标签"
- 一个函数可能有几十种等价的反汇编表达,模型倾向选"看起来像样"的那种
- 偏移量、跳转目标、寄存器约定都是硬数字,差一位就是灾难
- 模型会自信地补全它"以为应该有"的结构,而不是"实际有"的结构
结果就是:AI 给你一份看上去很专业的逆向报告,函数名、偏移、结构体字段一应俱全——其中 97% 是错的。
更糟的是,这种错不是"有一点偏差",而是错得理直气壮。它会引用真实的 WinAPI 命名约定、真实的中断号、真实的段寄存器规范,让审稿人也很难一眼识破。
三、reverify 的解决思路:LLM 提议 + 工具验证
reverify 的架构非常克制——它不试图训练"更靠谱的模型",而是在 LLM 输出和最终交付之间插一道确定性门控:
用户/Agent → "这个函数是什么?"
        ↓
   LLM 回答(可能幻觉)
        ↓
reverify 确定性工具验证
        ↓
实际字节数据 vs LLM 声明内容
        ↓
✅ 验证通过 → 接受声明
❌ 验证失败 → 拦截 + 标注错误点
关键设计:验证由不依赖 LLM 的工具完成。 反汇编(capstone)、字节模式匹配、CPU 模拟执行(unicorn)、符号执行(angr)这些工具的输出是确定性的——同一个输入永远给同一个结果。LLM 没办法"说服"反汇编器把 mov eax, 1 解释成 mov ebx, 2。
四、架构:MCP Server + CLI 双形态
reverify 同时提供 MCP Server 和 CLI 两种使用方式:
reverify
├── MCP Server     → 供 Claude Code、Cursor、Codex、Gemini CLI、OpenCode 等 Agent 调用
├── CLI            → 直接命令行使用
├── Python Core    → 核心验证引擎
└── 可选重型后端   → capstone / unicorn / lief / angr(按需安装)
MCP 集成覆盖面是它最值得关注的工程信号。 一周内同时支持 Claude Code、Cursor、Codex、Gemini CLI、OpenCode 五大主流 Agent,说明:
- MCP 协议已经足够成熟,能承载复杂的二进制分析工具接入
- 作者对 Agent 生态的理解到位,没有绑死单一平台
- 这类"AI 旁路工具"正在成为新的标准件赛道
安装与使用
# 快速安装
pip install reverify

# 启动 MCP Server
reverify mcp

# CLI 验证二进制文件声明
reverify verify --file /path/to/binary --claim "function X at offset 0x1234"

# 按需安装重型后端
pip install capstone unicorn lief angr
Rollover 机制
长任务交接时,reverify 自动将状态写入文件,在新 session 恢复——这个细节很重要。逆向分析往往是几小时甚至跨天的长任务,自动摘要会失真,状态文件化是更可靠的交接方式。
五、基准测试方法论:把"反幻觉"变成可量化指标
reverify 最值得学习的不是工具本身,而是它把反幻觉从定性话术变成可量化基准的方法论:
反幻觉方案评估 = 在 N 个真实样本上跑
               → 统计有多少幻觉被拦截
               → 统计有多少真实内容被误杀
               → 产出 Precision / Recall 指标
这套方法可以复用到任何"AI 输出可靠性"评估场景:
| 评估对象 | N 个真实样本 | Precision(拦截率) | Recall(误杀率) |
|---|---|---|---|
| 二进制逆向声明 | 71 个 Windows 文件 | 100% | 0% |
| 财报数据抽取 | 100 份 10-K | ? | ? |
| 法律条款引用 | 200 份合同 | ? | ? |
| 营销文案事实性 | 500 篇历史文章 | ? | ? |
每多一个这样的基准,"AI 幻觉"这个概念就从玄学变成工程问题。
六、对内容运营者和 Agent 工程师的借鉴
6.1 内容运营者:可量化的"反幻觉"标准
内容行业里"事实性错误"是个老大难——产品参数、数据引用、客户案例,常被 AI 辅助生产时"顺手编"一个看着合理的版本。reverify 的启示是:
- 不要只问"AI 写得对不对",要建一个 100-500 条的真实样本库做回归测试
- 每次接入新模型/新 prompt,先在样本库上跑一遍,统计错误率趋势
- 把 Precision/Recall 写进内容生产的 SLA,而不是靠"老师傅终审"
6.2 Agent 工程师:把验证层做成一等公民
reverify 的架构可以直接抽象成 Agent 系统的设计原则:
1. Skill 输出验证门控
Agent 调用 Skill 后的输出,应通过预置的确定性断言验证:
- API 调用:检查返回结构、必填字段、状态码
- 文件操作:检查文件存在性、权限、大小、编码
- 数据抽取:检查字段类型、取值范围、引用完整性
2. 多 Agent 协作的信任链
当多个 Agent 协作时,每个 Agent 的输出应该经过验证才能流入下一个 Agent。LLM 之间的"信任"是工程事故的温床,工具验证才是可审计的。
3. 自我验证闭环
借鉴 "LLM proposes, tools verify",Agent 的自我修正应优先依赖确定性工具(如重新调用 API、查数据库),而不是二次 LLM 调用——后者只会让错误以更高的置信度复述。
6.3 哪些场景适合引入这种验证层
| 场景 | 推荐程度 | 原因 |
|---|---|---|
| 二进制逆向工程 | ⭐⭐⭐⭐⭐ | 核心场景,错误率 97%,刚需 |
| 固件/IoT 安全分析 | ⭐⭐⭐⭐ | 同二进制域,工具链需扩展 |
| Agent 输出可靠性 | ⭐⭐⭐ | 方法论可直接借鉴 |
| 营销/法律/财务内容 | ⭐⭐⭐ | 错误代价高,样本库可建 |
| 源码级代码分析 | ⭐⭐ | 源码幻觉率较低,收益有限 |
七、它不试图解决的事
- 不替代领域专家:reverify 拦截的是"声明是否与字节事实一致",不判断"这个函数该不该这么实现"
- 不解决所有 Agent 幻觉:只针对二进制这一类高错误率垂直场景
- 不做 LLM 微调:纯外部验证层,对模型完全无侵入
这是个好设计——它承认 LLM 在某些场景就是要幻觉的,然后用工程手段把幻觉的影响控制在交付前。
八、总结
2akouwu/reverify 的真正价值不在于"又一个 AI 工具",而在于它示范了一套反幻觉的工程化范式:
- 承认 LLM 在特定场景的高错误率(97% 不丢人,掩盖才丢人)
- 用确定性工具做审计层(不依赖二次 LLM 调用的循环论证)
- 用可复现的基准做评估(71 个真实样本、100% 拦截、0 误杀)
- MCP 化交付(不绑死单一 Agent 平台)
它提醒我们:内容生产的"事实性"也可以用 Precision/Recall 来考核。对于 Agent 工程师,它示范了"验证层作为一等公民"该如何落地。
在 AI 越来越擅长"看起来很专业"的当下,愿意说"AI 自己说的不算"的项目,反而是更值得信赖的那一类。
项目地址:github.com/2akouwu/reverify
MCP 集成:Claude Code / Cursor / Codex / Gemini CLI / OpenCode