
在使用 openclaw 搭建业务 AI Agent 时,普遍会遇到一个核心痛点:Agent 默认优先联网检索,容易引入无关、过时甚至错误的公网信息。即便已经使用Obsidian搭建了专业的知识系统,小龙虾还是无法复用你在 Obsidian 中沉淀的业务规范、项目案例、工作流程等私有知识,导致输出结果不贴合实际业务、重复造轮子、一致性难以保障。
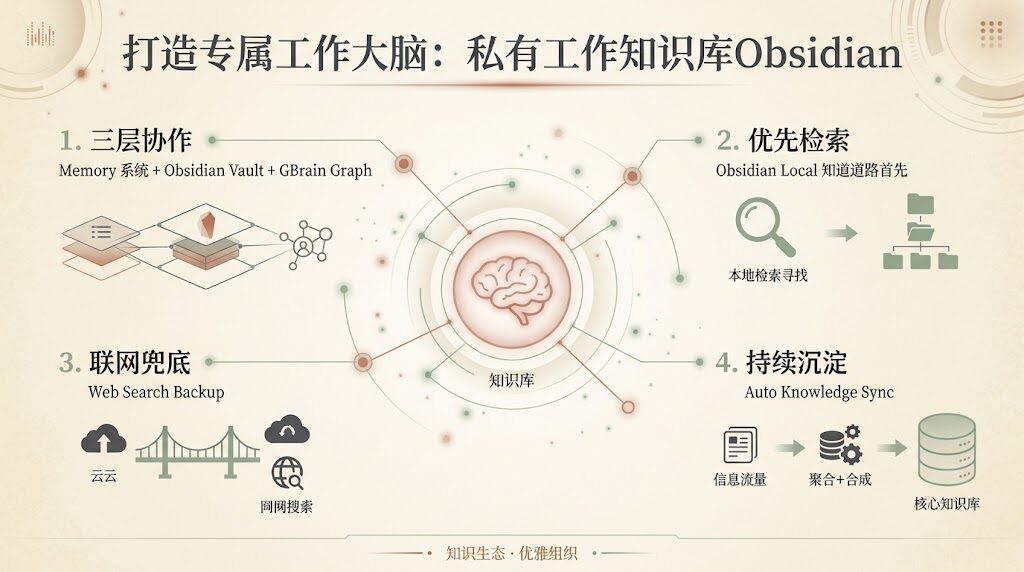
本文针对「私有知识无法优先调用、联网检索不可控、Agent 行为不统一」三大问题,提供一套温和且可落地的配置方法,通过 OpenClaw 内置的记忆体系、Obsidian 本地知识库与可选的 GBrain 知识图谱三层协作,让 Agent 始终以本地知识库为核心依据,公网信息做兜底补充,真正实现私有知识可控、AI 输出稳定、经验持续沉淀。
看不懂?让小龙虾帮你快速落地:
本文及本站大部分openclaw相关文章,都可以让OpenClaw agent阅读,然后进行应用,参考Prompt如下:
请阅读这篇文章:
https://www.aiec.fun/%e6%89%93%e9%80%a0%e4%b8%93%e5%b1%9e%e5%b7%a5%e4%bd%9c%e5%a4%a7%e8%84%91%ef%bc%9a%e8%ae%a9openclaw%e4%bc%98%e5%85%88%e4%bd%bf%e7%94%a8%e4%bd%a0%e7%9a%84%e7%a7%81%e6%9c%89%e5%b7%a5%e4%bd%9c%e7%9f%a5/
分析有哪些内容,对我们优化工作流程有价值,并严格根据openclaw最新官方文档核对,排除错误及过时信息,制定落地计划。
一、核心工作逻辑
本方案遵循「本地知识库优先,公网信息兜底」的智能检索流程,既保证工作内容贴合你的业务规范,又不丧失实时信息处理能力。
二、Obsidian 与 OpenClaw 基础对接
OpenClaw 通过memory-wiki插件与 Obsidian 进行集成,配合内置的memory_search工具实现知识库检索。无需手动创建软链接,直接通过配置文件指定 Obsidian vault 路径即可。
1. 工作区目录规范
在 OpenClaw 工作区建立 Obsidian 关联目录,用于统一管理知识库读写权限:
your-workspace/
├── skills/ # 自定义技能目录
├── memory/      # 每日记忆文件
├── knowledge-base/  # 知识库文档
├── AGENTS.md
├── SOUL.md
└── TOOLS.md
2. 配置 Obsidian Vault 路径
通过memory-wiki插件配置 Obsidian vault 路径,在~/.openclaw/openclaw.json中添加:
{
  "plugins": {
    "entries": {
      "memory-wiki": {
        "enabled": true,
        "config": {
          "vault": {
            "path": "/你的/Obsidian/仓库路径"
          },
          "bridge": {
            "enabled": true
          }
        }
      }
    }
  }
}
3. 基础连通性测试
在 OpenClaw 交互窗口中执行以下指令,验证文件访问正常:
openclaw wiki obsidian status
openclaw wiki obsidian search "业务关键词"
三、优先级配置:让 Agent 优先使用 Obsidian 知识
不采用激进的禁用联网策略,通过技能加载优先级 + 提示词强约束,实现 Obsidian 优先检索。
1. 技能加载优先级设置
OpenClaw 原生遵循工作区技能 > 全局技能 > 内置技能的调用顺序,将 Obsidian 相关检索工具放置在工作区技能目录,保证优先触发。
2. 检索权重与行为规范
通过 Agent 行为规则,固定检索顺序:
- 先读取 Obsidian 中的流程、规范、历史案例
- 本地信息不足时,自动进行联网补充
- 外部信息需与本地知识做交叉校验
四、Agent 行为约束配置
通过 AGENTS.md 引用子配置文件的方式,固化 Agent 的知识使用逻辑。
## 知识检索与执行规范
1. 处理任何工作任务,第一步必须检索 Obsidian 本地知识库。
2. 若本地存在完整方案、标准或案例,直接以此为依据完成任务。
3. 本地知识缺失或不完整时,可自动联网检索补充信息,无需人工确认。
4. 任务产出的新经验、新结论,自动整理并写入 Obsidian 更新知识库。
5. 外部信息仅作为补充,不得与本地已有规范冲突。
6. 以 Obsidian 中的私有工作知识为核心依据,保持输出一致性与专业性。
7. 优先使用你沉淀的业务流程、操作规范与历史经验。
8. 主动维护知识库,将新的工作成果同步归档,持续迭代知识体系。
9. 公网信息仅用于补充未知内容,不替代本地核心知识。
五、运行验证与日志排查
配置完成后,可通过任务执行结果判断优先级是否生效:
- 本地知识覆盖场景:Agent 直接引用 Obsidian 内容,无联网行为
- 本地知识缺失场景:Agent 先检索本地,再自动联网补充
- 知识沉淀场景:任务完成后自动生成笔记更新知识库
如需排查检索行为,可通过 OpenClaw 原生日志查看工具调用顺序,确认 Obsidian 检索优先触发。
附件:可直接复制的完整配置模板
1. 知识检索规范(建议添加到 AGENTS.md 或独立配置文件)
## 核心执行规则
1. 处理任何工作任务,第一步必须检索 Obsidian 本地知识库。
2. 若本地存在完整方案、标准或案例,直接以此为依据完成任务。
3. 本地知识缺失或不完整时,可自动联网检索补充信息,无需人工确认。
4. 任务产出的新经验、新结论,自动整理并写入 Obsidian 更新知识库。
5. 外部信息仅作为补充,不得与本地已有规范冲突。
2. SOUL.md 补充片段
## 工作风格
- 以 Obsidian 中的私有工作知识为核心依据,保持输出一致性与专业性。
- 优先使用你沉淀的业务流程、操作规范与历史经验。
- 主动维护知识库,将新的工作成果同步归档,持续迭代知识体系。
- 公网信息仅用于补充未知内容,不替代本地核心知识。
3. memory-wiki 插件配置示例
{
  "plugins": {
    "entries": {
      "memory-wiki": {
        "enabled": true,
        "config": {
          "vault": {
            "path": "~/Obsidian/你的Vault名称"
          },
          "bridge": {
            "enabled": true
          }
        }
      }
    }
  }
}
4. 可选:GBrain 知识图谱(团队增强层)
如果你的团队希望建立更强大的知识图谱关系网络,可以在 OpenClaw 基础上额外安装 GBrain。GBrain 是基于 Obsidian 的知识图谱增强工具,支持自动关系识别、语义搜索和跨页面链接。
安装方式:
npm install -g gbrain
mkdir -p ~/.gbrain/你的agent-id
gbrain init --engine pglite
gbrain import ~/Obsidian/你的Vault路径 --no-embed
GBrain 不是 OpenClaw 的必选项,而是团队自定义的增强层。如果只需要基础的 Obsidian 集成,使用memory-wiki插件即可。