
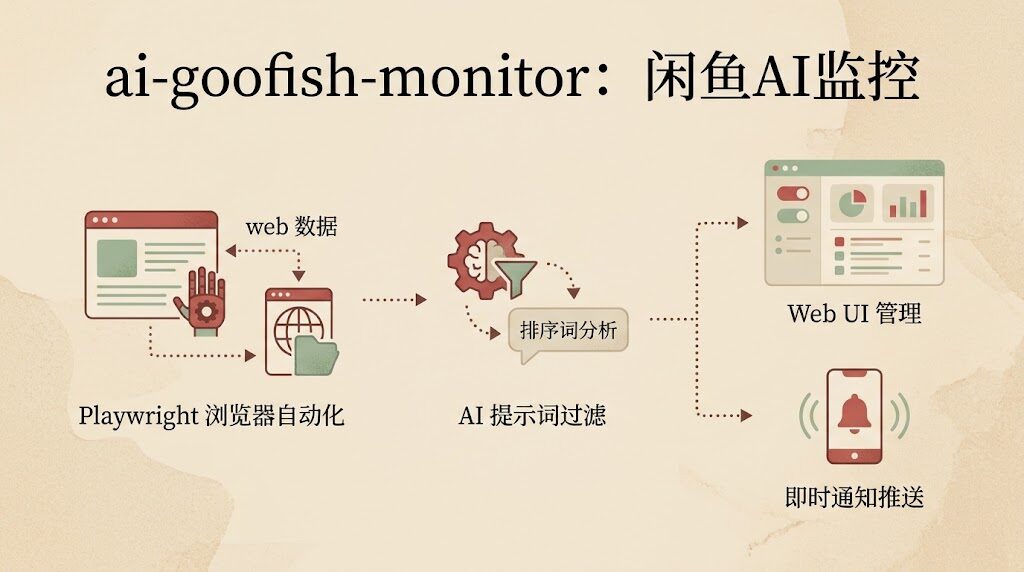
「盯着二手平台蹲一件特定商品,等它降到心理价位就提醒你」——这件事过去要么靠手点,要么靠一堆半吊子脚本。这个开源项目把整条链路做成了产品:Playwright 无头浏览器去搜索页翻页,多模态模型读图读描述判断值不值得买,命中了再通过七种渠道之一推给你。2026-11-06 的 GitHub Trending 日榜上能看到它,排在第 4 位。而更值得看的是它内部的实现方式:任务失败怎么自我熔断、坏资源怎么自动回池、模型输出怎么被约束成可复核的结论,这几件事在任何自建自动化流程里都用得上。
读它的理由可能和预期不一样。项目本身是个二手交易监控工具,但真正值得抄的是里面六个工程设计:任务连续失败时如何自动熔断并自我恢复、坏资源如何自动冷却回池、AI 判据如何与日常执行解耦、模型输出如何被逼成带证据的结构化结论。这几条在 Claude、OpenClaw 这类 agent 工具里同样成立。
一、它到底在做什么
闲鱼没有开放 API,只能自己去拿数据
闲鱼做的是 C2C 二手交易,没有对外开放平台接口。想持续盯某个关键词下的新货,常规做法就是用浏览器自动化去翻搜索结果页。这个项目用 Playwright 驱动浏览器完成抓取:Docker 镜像内置 Chromium 并固定使用它(本地环境可用 Edge 内核,靠 LOGIN_IS_EDGE 切换),抓到的商品标题、价格、描述和图片一起进入后端。
一条监控任务长什么样
一个任务等于:关键词 + 价格区间 + 一组筛选条件 + 一份判据 + 一条推送渠道,外加可选的定时规则。除关键词匹配外,它还支持省/市/区三级地域筛选、"新发布"时间范围、包邮筛选、个人卖家筛选等条件。多个任务可以并发跑,也能挂 cron 定期执行。
判据从哪来
有两条路。keyword 模式走确定性规则引擎,命中任一关键词即推荐;ai 模式则先让多模态模型生成一份分析标准,生成完再建任务——接口返回 202 和一个 job,前端轮询进度条,判据最终落盘到 prompts/ 目录下的文本文件(base_prompt.txt 是模板,macbook_criteria.txt 是一份品类实例)。
二、架构骨架:四层分层,边界清晰
规模先给个参照:仓库树里共 359 个条目、301 个文件,语言分布是 Python 115 · Vue 79 · TypeScript 46 · JSON 16 · Markdown 8,顶层目录 web-ui 143 · src 77 · tests 43 · chrome-extension 5 · static 4 · prompts 2。
仓库的 AGENTS.md 把分层写死:API → services → domain → infrastructure,避免跨层耦合。落到目录就是四层,跨层调用一眼能看出来。
路由层:9 个模块
src/api/routes/ 下是 9 个路由模块:tasks、accounts、login_state、logs、prompts、results、settings、dashboard、websocket。任务创建、结果查询、登录态校验这类对外接口都在这一层。
服务层:23 个模块,真正的重头
src/services/ 下 23 个服务模块承担业务:调度(scheduler_service)、任务生成(task_generation_service 与 runner)、模型调用与解析(ai_service、ai_response_parser、ai_request_compat)、通知(notification_service)、价格历史、卖家画像缓存、结果黑名单、分页搜索、账号策略、日志清理等。分层写清楚之后,读一个功能只要先在 services 里定位。
领域层与基础设施层:接口与实现分离
src/domain/ 只有 models(task、task_generation)和 repositories(task_repository)——仓储接口与实现刻意分开。src/infrastructure/ 分 external(ai_client 加 7 个通知渠道 client 与 factory)和 persistence(SQLite、JSON 两套 repository 实现加 bootstrap),外部依赖全部收在这一层。
前端与测试
web-ui/ 是 Vue 3.5 + Vite 7 + TypeScript 5.9 + vue-router 4,构建产物复制到根目录 dist/;tests/ 下 43 个文件用 pytest 覆盖核心服务、爬虫管道的异常分支与重试逻辑。后端分层 + 独立前端 + 仓储双实现,这套骨架接近生产级,不是跑通就算的玩具 demo。
三、任务级熔断器:失败不再是无限重试
它解决的是什么问题
自动任务最常见的两种死法:登录态失效或平台风控触发后,任务持续失败,而重试策略又没设上限,于是每隔一分钟就触发一次失败运行——模型调用照付、真实产出为零。反过来,如果失败得太安静,人又往往几天才发现任务早就躺了。
src/failure_guard.py 的模块说明写得直白:目标是在登录态失效或风控导致任务持续失败时,避免无限重试、避免高频请求;失败达到阈值后暂停任务一段时间;暂停期间最多每天通知一次,直到用户更新 cookies 或登录态文件后自动恢复。
三个要素缺一不可
熔断状态里记录三件事:失败次数阈值、暂停时长、每日通知上限。默认值写在 .env.example 里:
# 连续失败多少次后熔断
TASK_FAILURE_THRESHOLD=3
# 熔断后暂停多久(秒),默认暂停一天
TASK_FAILURE_PAUSE_SECONDS=86400
# 熔断状态文件路径,默认 logs/task-failure-guard.json
TASK_FAILURE_GUARD_PATH=
一天通知一次这一条常被忽略,但它决定了熔断之后人还看不看得到系统出事了。
怎么做到「状态一变就自动恢复」
恢复不靠定时器猜,而是靠一个便宜的信号:登录态 cookie 文件的修改时间。代码用 os.path.getmtime 取该文件的 mtime,与熔断时记录的值比对,一旦用户重新导入了登录态、文件被更新,就判定外部条件已恢复,解除熔断。跨进程并发则用 fcntl.flock 拿文件锁,保证同一时刻只有一个进程在改熔断状态。整个模块只用标准库,没有引入额外依赖。
四、轮换池与带 TTL 的黑名单:坏资源自己回池
代理与账号池的常见毛病
多账号、多代理的场景里,总有某个资源是坏的:代理超时、账号被限流、某个上游接口 500。朴素做法有两种极端——要么一直重复挑中那个坏资源,任务永远好不了;要么把坏资源永久摘除,池子容量越用越少,最后一个能用都没有。
冷却,而不是永久剔除
src/rotation.py 的 RotationPool 给每个条目记一份最近错误信息。取用时 pick_random 只在不在黑名单的条目里随机挑;某个条目失败后被 mark_bad 拉黑,黑名单条目带 TTL(默认 300 秒);过期条目由清理逻辑自动移出黑名单,重新回到可用池。
# 代理轮换开关与模式(per_task 按任务切换 / on_failure 失败时切换)
PROXY_ROTATION_ENABLED=false
PROXY_ROTATION_MODE="per_task"
# 单个资源失败后的重试次数
PROXY_ROTATION_RETRY_LIMIT=2
# 坏资源在黑名单里冷却多久(秒)
PROXY_BLACKLIST_TTL=300
这个模式的价值在于把失败资源当作「暂时不可用」而不是「永久报废」:容量不会因为一次故障而永久损失,冷却期满又能半开重试。
五、确定性判据优先,AI 只负责生成判据
两条创建路径
任务创建时可选两种判据模式。keyword 模式直接返回已创建任务;ai 模式返回 202 和一个 job,需要轮询 GET /api/tasks/generate-jobs/{job_id} 查进度。README 也把这条写成了问答:AI 任务创建为什么不是立即完成?——因为它会先生成分析标准,再创建任务。
判据落盘之后,匹配不再消耗模型调用
关键设计在于判据生成之后会被写成文件(prompts/base_prompt.txt 是模板,macbook_criteria.txt 是品类实例),后续每次匹配都是纯文本比对,不再调用模型。AI 被用在它不可替代的地方——写出判据;确定性的部分就交给确定性的规则。
keyword 模式还有一处细节值得抄:关键词判断引擎的说明写着「单组 OR 逻辑,命中任意关键词即推荐。纯英数字关键词按完整词匹配,避免 Q1 误命中 Q1R5」。英文与数字混排的关键词如果只做子串匹配,Q1 会误命中 Q1R5 这类条目,按完整词边界匹配才能避开。
六、多模态输出被强制成结构化 JSON
提示词里写死了输出契约
prompts/base_prompt.txt 以「你是世界顶级的二手交易分析专家,代号 EagleEye-V6.4」开头,随后规定:输出必须是单个 JSON 对象,不能包含任何额外文字或注释。schema 固定,包括 prompt_version、is_recommended、reason、risk_tags,以及逐维度展开的 criteria_analysis,每个维度都由 status、comment、evidence 三件套组成。
{
  "prompt_version": "EagleEye-V6.4",
  "is_recommended": true,
  "reason": "一句话综合评价",
  "risk_tags": ["string"],
  "criteria_analysis": {
    "condition": { "status": "PASS", "comment": "string", "evidence": "string" }
  }
}
evidence 是必填字段
每个维度的结论都必须挂上依据,evidence 不是可选项。这让「AI 说值得买」变成一条能回头查证的判断,而不是一句无法追溯的话。
卖家画像:把「可信度」拆成可核对的维度
卖家一项比别的维度更细:除 status、comment 外还带 persona 画像字段,comment 开头必须标注「首要结论」;其下再拆成 analysis_details,含时间线分析、售卖行为分析、购买行为分析,以及一段专门的行为总结——要求模型明确回答「这个卖家的行为逻辑链是否完整可信」。判断逻辑被写进了 schema,而不是只写在提示词里靠模型自觉。
七、通知渠道做成工厂:加一种渠道只加一个文件
七个渠道与一套装配方式
通知相关的外部依赖放在 src/infrastructure/external/notification_clients/ 下,共 7 个渠道实现:ntfy、Bark、Gotify、PushPlus、Telegram、Webhook、企业微信机器人。它们共享一个 base 抽象和一个 factory 装配器,加一个新渠道只新增一个文件,调用方一行不用改。
对应的配置项按渠道分组放在 .env 里,填一个就能收到推送:
NTFY_TOPIC_URL=
PUSHPLUS_TOKEN=
BARK_URL=
GOTIFY_URL=
GOTIFY_TOKEN=
WX_BOT_URL=
TELEGRAM_BOT_TOKEN=
WEBHOOK_URL=
为什么值得抄这一点
多个出口各写各的投递逻辑,很容易出现同一个事件被两条链路各发一次的情况。把「渠道」抽象成 base 加 factory 加统一装配点,消息出口契约才有地方做机器化校验——这比事后人工对账可靠得多。
八、存储迁移:一次性导入,同时保留兼容读
从 JSON 文件迁到 SQLite
在线主存储是 SQLite,默认路径 data/app.sqlite3,可以用环境变量 APP_DATABASE_FILE 改。应用启动时会自动建库建表,并尝试从旧的 config.json、jsonl/、price_history/ 导入一次历史数据。
迁,但不切流
关键在于旧数据源仍然保留挂载,确认新库内容正确后再决定是否清理旧目录;同时 SQLite 与 JSON 两套仓储实现并存,爬虫脚本默认读 SQLite,只有显式传 –config 参数才走 JSON 兼容模式。
# 默认走 SQLite
python spider_v2.py --task-name "MacBook Air M1" --debug-limit 3
# 显式指定旧 JSON 配置才走兼容模式
python spider_v2.py --task-name "MacBook Air M1" --config config.json
这是一次没有断崖式切换的迁移:老路径仍能跑,新路径默认启用。做过数据迁移的人都知道,「切换即改路径」意味着出问题只能整条链路回滚。
九、其余功能面速览
多任务并发与筛选组合
任务管理支持 AI 创建、关键词规则、价格范围、新发布范围、区域筛选、账号绑定与定时规则。多任务并发时,每个任务独立配置关键词、价格、筛选条件与提示词;任务还能绑定指定闲鱼账号,或不绑定交给系统自动选。
地域筛选来自页面抓取快照
省/市/区三级地域筛选内置了从闲鱼页面抓取的数据快照。README 的常见问题里专门提醒:区域筛选会显著缩小结果集,所以默认建议留空,先验证整体市场再逐步收窄。
价格历史、卖家画像缓存与结果黑名单
这三件套解决的是去重与增量问题:同一商品不重复通知、同一卖家不重复抓取、价格可追踪以做趋势告警。结果页与导出功能直接从 SQLite 查询,不再扫描 jsonl 文件。
登录态与账号管理
登录态通过 Chrome 扩展导出闲鱼登录状态 JSON,再粘进「闲鱼账号管理」,文件保存在 state/ 目录(例如 state/acc_1.json)。日志页按任务展示运行过程,便于排查登录态失效、风控拦截和 AI 调用异常。
十、上手前必须知道的四件安全与合规事项
默认口令必须改
Web UI 的默认账号密码是 admin/admin123,配置项是 WEB_USERNAME 与 WEB_PASSWORD。README 在两个位置都提示了:生产环境请务必修改。
登录态 cookie 是明文凭据
登录状态以明文 JSON 存在 state/ 目录里,拿到这个文件基本等于拿到账号。这一点在任何多人可访问的机器上都值得单独确认一次。
抓取本身处在平台风控对面
无头浏览器加账号池加代理轮换的组合,天然处在平台风控的对抗面上。README 的注意事项写得很清楚:请遵守闲鱼的用户协议和 robots.txt 规则,不要进行过于频繁的请求,以免对服务器造成负担或导致账号被限制;项目仅供学习和技术研究使用。
商品图与描述会送到外部模型
AI 分析会把商品图与描述一起送进外部模型端点,所以 OPENAI_API_KEY、OPENAI_BASE_URL、OPENAI_MODEL_NAME 三项都是必填,其中模型必须支持图片输入。接入前需要先想清楚数据流向。
十一、电商从业者拿它能干什么
二手与特价商品的盯盘
最直接的用法是当「蹲货」工具:设好关键词、价格区间、包邮、新发布范围和地域,把筛出来的新货推送到手机或电脑。这类需求的特点是量不大但时效敏感,人工刷的漏检率往往比想象中高。
卖家可信度的辅助判断
卖家画像那一维输出的是行为时间线、售卖行为、购买行为和一段行为逻辑链总结。它不能替代人工看货,但能在你不熟悉的品类里先给出一个「这个卖家的故事讲不讲得通」的判断,尤其适合评估客单价高、成色主观性强的二手数码。
什么场景用不上它
反过来也要说清楚:如果需求是偶发性的——一年问几次「这个型号现在多少钱」——开一套浏览器自动化加多模态分析的流水线明显不划算,手动搜一下更快。另外三类情况值得直接排除:
- 需要大规模批量抓取与结构化入库:这是专用爬虫框架的战场,不是这个项目的强项。
- 目标站点有正规开放 API:能走官方接口就别绕风控。
- 判定标准本身高度主观且不可描述:AI 判据写不出来,硬写只会得到一堆无法复核的结论。
十二、跟几类常见方案比一比
自己写脚本 vs 通用爬虫框架 vs 现成监控工具
| 方案 | 优势 | 短板 | 适合谁 |
|---|---|---|---|
| 自己写 Playwright 脚本 | 完全可控,无学习成本 | 判据、通知、重试全要自己写,多账号几乎必然崩 | 只抓一两个固定关键词的人 |
| 通用爬虫框架(如 Scrapling 这类) | 反爬能力强、扩展性好 | 判据和调度仍需自己搭,AI 分析要另外接 | 需要大规模抓取并做结构化入库的团队 |
| 现成商品监控 SaaS | 开箱即用,有维护 | 平台与字段受限,数据在自己手里,定制判据很难 | 只想要「有货提醒」这一件事的人 |
| 本项目这类开源监控器 | 判据、通知、多账号、调度、后台 UI 都齐,MIT 许可可自行改造 | 上手有门槛(Playwright + 登录态),且使用边界受平台规则约束 | 需要自定义判据与多渠道推送的中小团队 |
三个判断标准
选型时问三个问题就够了:第一,判据要不要自己写?要,就看有没有 prompt 模板和 schema 约束。第二,要不要多账号和代理轮换?要,就得有熔断和冷却池这类容错设计。第三,数据能不能留在自己机器上?要,就别选 SaaS。
十三、上手路径
Docker 一键部署
仓库提供 Dockerfile 与 docker-compose 配置,镜像内置 Chromium,默认对外服务监听 127.0.0.1:8000。常用命令:
git clone https://github.com/Usagi-org/ai-goofish-monitor && cd ai-goofish-monitor
cp .env.example .env
docker compose up --build -d
docker compose logs -f app
docker compose down
最小配置
三项必填是模型相关配置,模型必须支持图片输入:
OPENAI_API_KEY=sk-...
OPENAI_BASE_URL=https://api-inference.modelscope.cn/v1/
OPENAI_MODEL_NAME=XiaomiMiMo/MiMo-V2-Flash
再加上 Web UI 账号密码(默认 admin / admin123,务必改)。若走本地运行而不是 Docker,./start.sh 会检查 Playwright 与 Chromium 是否就绪,并依次安装依赖、构建前端、启动后端。
创建第一个任务
进「闲鱼账号管理」,用 Chrome 扩展导出闲鱼登录态 JSON 并粘贴,登录态文件会保存到 state/ 目录。然后在任务管理里新建任务:关键词、判据、价格区间、筛选条件、账号绑定和定时规则都在这一步配好。AI 创建会先跑判据生成,进度弹窗结束后任务才真正建立。
十四、小结
值得抄的是六个机制,不是这个项目本身
闲鱼监控这个场景偏窄,多数人用不上;但它把六件容易做错的事做对了:失败到阈值就熔断、状态变化就自动解封;坏资源进冷却池而不是永久报废;AI 只用来生成判据,日常执行走确定性规则;模型输出必须是带 evidence 的结构化 JSON;通知渠道收敛成 base 加 factory 的单一装配点;存储迁移做一次性导入并保留兼容读。
这六条对任何搭 AI 自动化流程的人都适用。哪怕你完全不碰电商,只要系统里有「定时跑、可能失败、要调模型、结果要推给人」这四件事,上面每一条都能直接对照检查。
一个提醒
登录态 cookie 以明文形式存放在 state/ 目录,Web UI 默认口令是 admin/admin123,这两项在对外暴露前必须先改掉。