
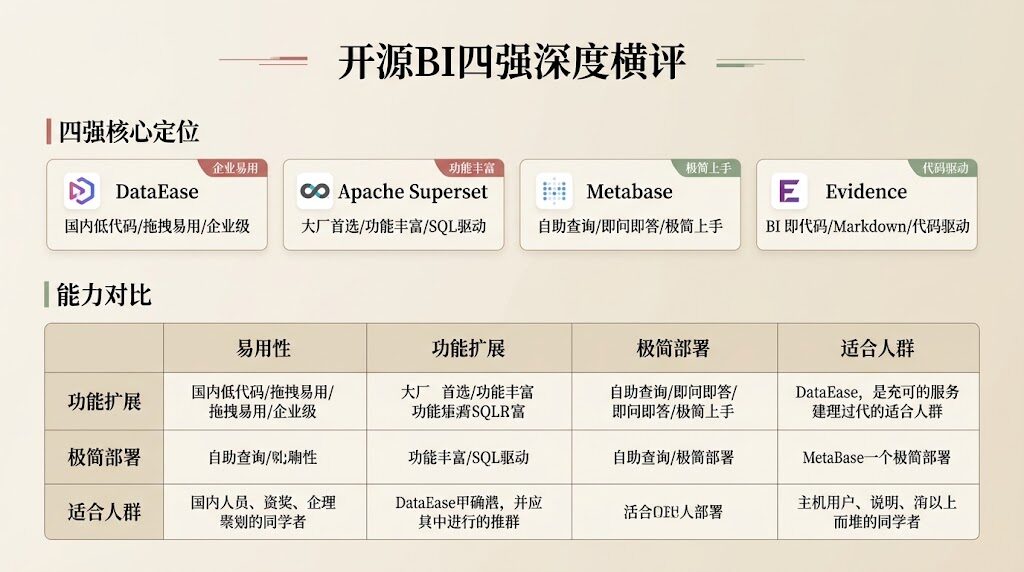
一、为什么要在 2026 年还聊开源 BI
SaaS BI 的便利已经把"开箱即用"做成了行业标配,但代价也很明显:报表定义存在厂商服务器上、数据出境合规难、AI Agent 没法读、改一个字段要走工单。这四条任何一条戳中,都会让一个 5-200 人的团队回到自托管阵营。
2026 年的开源 BI 已经不是"穷人版 Tableau"了。DataEase、Superset、Metabase、Evidence 四款项目加起来在 GitHub 上有超过 15 万 star,生态完整度、文档质量、AI 集成深度都已经走到能和商业产品扳手腕的位置。问题是:它们四个根本不是同一个物种——定位、用户群、技术路线都不一样,选错一个意味着 3-12 个月的返工。
本文的对比不预设结论,把每个项目按统一维度铺开,数据全部可溯源。
二、四款项目的"一句话自我介绍"
| 项目 | 官方定位 | 出品方 | 创立年 |
|---|---|---|---|
| DataEase | "人人可用的开源 BI 工具,数据可视化神器,An open-source BI tool alternative to Tableau" | FIT2CLOUD 飞致云(中国,无锡) | 2021-02 |
| Apache Superset | "A modern, enterprise-ready business intelligence web application" / "Data Visualization and Data Exploration Platform" | Apache 软件基金会(顶级项目) | 2015-07(孵化自 Airbnb) |
| Metabase | "The easy-to-use open source Business Intelligence and Embedded Analytics tool" | Metabase, Inc.(美国,YC 投资) | 2015-02 |
| Evidence.dev | "Business intelligence as code: build fast, interactive data visualizations in SQL and markdown" / "An agent-ready tool for creating reports using your data" | Evidence.dev Ltd.(创始团队英国/加拿大) | 2021-05 |
第一眼感受:DataEase 强调"人人可用"——中国式 SaaS BI 的体验、拖拉拽、低门槛;Superset 是企业级重型工具的代名词;Metabase 走"5 分钟上线"的非技术用户路线;Evidence 是个异类——它的官网首页就是给 AI Agent 看的(AGENTS.md 写在仓库根)。
三、GitHub 硬指标对比
3.1 星标 / Fork / 贡献者
| 维度 | DataEase | Superset | Metabase | Evidence |
|---|---|---|---|---|
| Stars | 24,383 | 74,554 | 49,008 | 6,896 |
| Forks | 4,250 | 18,206 | 6,777 | 404 |
| Watchers | 187 | 1,537 | 660 | 35 |
| 贡献者总数 | ~104 | ~1,718 | ~516 | ~76 |
| 30 天 commits | 44 | 200+ | 200+ | 24 |
| Open issues | 50 | 605 | 4,446 | 30 |
| 仓库体积(MB) | 352 | 1,127 | 2,247 | 315 |
怎么看这组数据:
- Superset 的体量是 4 倍 Metabase、11 倍 Evidence:这是 Apache 顶级项目十年积累的成果,生态最完整。代价是 1.1 GB 的源码、1,718 个贡献者的协调成本,新需求审批流程长。
- Metabase 的 4,446 个 open issues 是个红灯:它确实是最受欢迎的开源 BI 之一,但 bug 修复排期被指长期积压(GitHub Discussions 与 Discourse 上多次讨论)。这是商业化公司主导开源项目的典型问题——功能在加、技术债也在加。
- DataEase 30 天只 44 个 commit 看似偏低,但别忘了它在国内有 Gitee/GitCode 镜像,部分提交走飞致云内部仓库,GitHub 上反映的是开源同步量。实际项目活跃度需结合飞致云官网论坛判断。
- Evidence 24 个 commit 不算低:它代码体量小(Svelte + TS),24 次提交里通常是一次完整的功能迭代。它的"小而精"和 Metabase 的"大而全"是两种风格。
3.2 最新发布节奏
| 项目 | 最新版本 | 发布时间 | 距今 | 频率感受 |
|---|---|---|---|---|
| DataEase | v3.0.0 | 2026-08-31 | 当天 | 按月迭代(README 自述) |
| Superset | 6.1.0 | 2026-05-13 | ~3.5 个月 | 每 2-3 个月一个 minor |
| Metabase | v0.63.15 | 2026-08-26 | 5 天 | 接近周更(63.x 系列高频) |
| Evidence | 40.1.8 | 2026-02-06 | ~7 个月 | 早期 v40.x,后来每周都有 40.x.y 修复 |
说明:Metabase 用 0.x 版本号不代表"还不成熟"——它的商业化产品已经服务 9 万+ 企业,稳定度主要看 Semver 后的 minor 节奏。Evidence 用 40.x 这种"年累计"的命名,反而暴露了它还很年轻(2021 年才立项,产品形态还在快速演进)。
3.3 主仓库语言构成
| 项目 | 主语言及占比(字节) |
|---|---|
| DataEase | Java 16.2 MB · Vue 4.6 MB · Shell/Less/Lua · 全栈 Java+Vue |
| Superset | Python 24.5 MB · TypeScript 22.7 MB · Jupyter 11 MB · 罕见的"Python 全栈 + 大量 notebook 文档"组合 |
| Metabase | Clojure 49 MB · TypeScript 36 MB · JavaScript 4.3 MB · 最特殊的栈——后端 Lisp 系,前端 React |
| Evidence | TypeScript 5.1 MB · Svelte 1.1 MB · 全前端,无传统后端 |
关键解读:
- Metabase 的 Clojure 是一道墙:Clojure 是 JVM 上的 Lisp 方言,全球开发者存量不到 5 万人。意味着你雇不到、也找不到外包来改它的源码——这是一道隐性的"厂商锁定"。
- Superset 的 Python 是把双刃剑:你能用 Python 写自定义可视化插件,但 Python 解释器本身性能天花板低,大数据量 dashboard 容易卡。
- DataEase 的 Java+Vue 是中国公司最熟悉的栈:出了问题能在 CSDN/掘金/思否找到中文答案,这是它对国内中小企业的隐性优势。
- Evidence 的 Svelte+TS 是最轻的:但 Svelte 在中国大陆开发者中的熟悉度远低于 React/Vue,招人难。
四、数据源支持——这是 BI 的命门
4.1 Superset:60+ 数据源,SQL 世界的"瑞士军刀"
Superset 官方文档列出的 supported databases 超过 60 种(从 README 截图中的 logo 数量可见),包括几乎所有主流 SQL 数据库与大数据引擎:PostgreSQL、MySQL、Oracle、SQL Server、ClickHouse、Apache Doris、Apache Druid、Apache Pinot、Apache Hive、Apache Impala、Trino、Presto、Snowflake、Databricks、BigQuery、Redshift、Athena、MongoDB、Elasticsearch、DuckDB、SQLite、YugabyteDB、OceanBase、StarRocks、Databend、RisingWave、Dremio、SAP HANA、Teradata、Vertica 等。
任何带 SQLAlchemy dialect 与 Python DB-API 的数据源都能接——这是 Superset 的设计哲学。它是企业数据中台的首选。
4.2 Metabase:20+ 官方支持 + 社区驱动
Metabase 官方 databases 列表覆盖主流 OLTP(MySQL/PostgreSQL/Oracle/SQL Server/MariaDB),主流 OLAP(Snowflake/BigQuery/Redshift/Databricks/Presto/Trino),还有 MongoDB、Databricks、Athena、Google Sheets 等。它的数据源数量比 Superset 少但更聚焦:不在数量上赢,而在"装上就能用"上赢。配 JDBC 即可,不需要像 Superset 那样装各种 Python 驱动。
Metabase 的"商用版"还支持 Snowflake/Postgres 的 row-level security 与列级权限——但社区版也有基础权限模型。
4.3 DataEase:中国数据库生态全覆盖
DataEase 官方 README 列出:
- OLTP: MySQL、Oracle、SQL Server、PostgreSQL、MariaDB、Db2、TiDB、MongoDB-BI
- OLAP: ClickHouse、Apache Doris、Apache Impala、StarRocks
- 数据仓库: Amazon RedShift
- 文件: Excel、CSV
- API 数据源: 自定义 HTTP API
最大亮点是对国内数据库生态的支持:TiDB、Apache Doris、StarRocks 都是国内主流,Superset 的支持要靠社区插件、Metabase 部分缺失。DataEase 在国内企业落地时,这一项常常是"一票决定"。
4.4 Evidence:10+ 数据源,DuckDB 优先
Evidence 内置连接器(连接器即 npm 包,部署时按需装):
- OLAP/文件优先: DuckDB(本地文件、Parquet、CSV)、Snowflake、BigQuery、Redshift、Postgres、MySQL、SQL Server、Trino、ClickHouse、Databricks、MotherDuck、Athena
- 通过 dbt 接入:任意 dbt 支持的数据源都能间接打通
Evidence 的特别之处:默认推荐 DuckDB + dbt——这是它和另三款最大的区别。如果你的数据已经在 dbt 仓库里,Evidence 是"零摩擦接入"。
4.5 数据源对比表
| 类别 | DataEase | Superset | Metabase | Evidence |
|---|---|---|---|---|
| 数据源总数 | ~15 官方 | 60+ | ~25 官方 | ~15 (含 dbt 间接) |
| 国内数据库生态 | ★★★★★ | ★★ | ★★ | ★ |
| 云数仓(Snowflake/BQ) | ★★ | ★★★★★ | ★★★★★ | ★★★★ |
| 大数据引擎(Doris/Trino) | ★★★★ | ★★★★★ | ★★★ | ★★★ |
| Excel/CSV | ★★★★★ | ★★★ | ★★★ | ★★★★ |
| 接入门槛(配置难度) | 低 | 高 | 中 | 中 |
一句话总结:要"全"选 Superset;要"易"选 Metabase;要"国产化"选 DataEase;要"数据科学栈"选 Evidence。
五、AI 支持——2026 年最被关注的维度
5.1 Evidence:为 AI 而生
Evidence 的所有 AI 友好设计都写在官方 README 第一句——"An agent-ready tool"。
- 仓库根目录有
AGENTS.md,CLAUDE.md一行@AGENTS.md - 官方提供 Studio MCP server,Claude Code/Cursor 等 Agent 可以直接通过 MCP 调用 Evidence CLI 创建/修改报表
- 报表本身是
.md文件里的 SQL 块 + 组件——AI 写报表 = 写文件,AI 读报表 = 读文件 - 官网首页就是 AGENTS.md,所有文档按"AI 看得懂"的方式写
这是四个项目里唯一原生把"Agent 能读能写"当产品定位的。
5.2 Metabase:商用版 Metabot + 开放的 Agent API
Metabase 在 2024-2025 年大举投入 AI:
- 内置 Metabot(云端版与商用版内置,开源版部分功能可用)——自然语言问数、自动生成 SQL
- Agent API——官方文档公开,允许外部 Agent 调用 Metabase 查询
- 2026 年 8 月发布的 v0.63.x 系列持续加 AI 功能(Data Studio 里的 transforms 也在往 AI 方向走)
Metabase 的 AI 路线是"BI 自己变成 AI"——用户不需要懂 SQL 也能用。代价是商业版收费,社区版 AI 能力弱。
5.3 Superset:有 API 无原生 AI
Superset 是四个里 AI 集成最弱的:
- 有一套完整 REST API(可以做权限管理、查询执行)
- 没有内置 NL2SQL、没有 MCP、没有 Agent 友好设计
- 第三方有开源插件(如
superset-ai、LangChain 集成),但都不是官方
如果你要 Superset + AI,得自己写中间层。
5.4 DataEase:SQLBot 智能问数
DataEase 通过兄弟项目 SQLBot(独立仓库 dataease/SQLBot)提供 AI 问数能力——这也是飞致云的产品矩阵中的一环。
- 自然语言转 SQL
- 可视化问答
- 与 DataEase 仪表板打通
SQLBot 是单独部署的产品,不是 DataEase 内嵌。这意味着你要为 AI 能力额外运维一套服务。
5.5 AI 支持对比
| 维度 | DataEase | Superset | Metabase | Evidence |
|---|---|---|---|---|
| 自然语言问数 | 通过 SQLBot(独立) | 无 | Metabot(商用版) | 无原生,靠 Agent 写 SQL |
| Agent/MCP | 无 | 无 | Agent API(部分) | Studio MCP(原生) |
| 报表作为代码 | 否 | 否 | 部分(remote-sync) | 是(BI as Code 核心) |
| AI 可读源码 | 一般 | 一般 | 一般 | ★★★★★ |
| AI 可写报表 | 困难 | 困难 | 中等 | ★★★★★ |
| 学习曲线(AI) | 高 | 高 | 中 | 低 |
判断:如果"AI 友好"是硬指标(就像很多 2026 年的开发者选型那样),Evidence 是当下唯一原生支持的方案,其他三家要靠外部 Agent 包装或商业版付费。
六、学习成本——给非技术读者看的入门坡度
6.1 Superset:最陡
- 默认安装要求 Python 3.10+、Node 20+、懂得 virtualenv、懂得 Docker
- 配置数据库连接需要写 SQLAlchemy URI(对非开发者不友好)
- 自定义可视化需要写前端 React 组件
- 首次成功部署:技术熟手 1-2 小时,新手半天到一天
- 文档分层:User Guide / Admin Guide / Developer Guide——专业但篇幅很长(总文档数 1000+ 页)
6.2 Metabase:最平
- "5 分钟设置"(README 自己的话)
- Java 单 jar 包或 Docker,启动后浏览器引导式配置
- 无需写代码——选数据源、拖字段、出图、保存到 dashboard
- 首次成功部署:5 分钟(广告词实至名归)
- 文档风格面向业务用户,有大量截图
6.3 DataEase:中文环境友好
- 一键脚本:
curl ... | bash,root 权限跑完即用 - 技术栈对中国开发者最熟悉(Java + Vue)
- 默认账号
admin / DataEase@123456 - 全中文文档、微信交流群、B 站视频教程
- 首次成功部署:10-20 分钟,文档和社区基本是中文,门槛最低
6.4 Evidence:需要会写代码
- 安装 Evidence CLI(脚本一键装)
- 必须懂 Markdown + SQL——不会写代码就用不了
- IDE 友好(与 VS Code / Cursor / Claude Code 集成最好)
- 但一旦上手,做报表的速度反而比 GUI 工具快
- 首次成功部署:30 分钟——主要是装 CLI 和初始化项目
6.5 学习难度对比
| 角色 | DataEase | Superset | Metabase | Evidence |
|---|---|---|---|---|
| 非技术业务用户 | ★★ (有学习曲线) | ★★★★ (劝退) | ★ (最易) | ★★★★★ (用不了) |
| 数据分析师 | ★★★ | ★★★★ | ★★ | ★★★ |
| 后端开发 | ★★ | ★★★ | ★♪ | ★ |
| AI Agent | ★★★ | ★★ | ★★ | ★ |
★ 越少越易。Evidence 对"会写代码的人"是最易,对"不会写代码的人"是最难。
七、硬件要求与部署成本
7.1 官方建议基线
| 项目 | 最低 | 推荐(中小团队) | 大规模 | 部署形态 |
|---|---|---|---|---|
| DataEase | 2 核 4 GB(README 原文) | 4 核 8 GB | 8 核 16 GB + MySQL 分离 | 一键脚本 / Docker / K8s / 离线包 |
| Superset | 2 核 4 GB(Python 镜像) | 4-8 核 8-16 GB | 8 核 + 独立元数据库 + Redis | Docker / K8s / Helm |
| Metabase | 1 核 2 GB(JAR 单实例) | 2-4 核 4-8 GB + 独立 Postgres | 多实例 + 负载均衡 | JAR / Docker / K8s / Metabase Cloud(SaaS) |
| Evidence | 无需服务端(静态站) | 仅构建机(2 核 4 GB 够) | Cloudflare Pages / Vercel / S3 | 静态站 + 浏览器端 DuckDB-WASM |
7.2 三项隐性成本
(1)数据库成本
- DataEase 自带 MySQL(或外接)
- Superset 推荐 Postgres + Redis
- Metabase 必须 Postgres(用作元数据库,不可缺)
- Evidence 没有元数据库,这是它最省钱的地方——所有报表是文件,没有 BI 自己的数据库要维护
(2)流量成本
- DataEase / Superset / Metabase 都是"全量数据传输"——后端跑 SQL、把结果吐给浏览器
- Evidence 走浏览器端 DuckDB-WASM——数据库查询推到浏览器执行,云端只下发静态文件,流量成本接近零。代价是单报表行数红线在几万到几十万行(再多浏览器跑不动)
(3)运维复杂度
- Metabase 单 jar 最简单,但商业化公司主导导致升级要小心看 changelog
- Superset 升级最难,数据库 schema migration 经常踩坑
- DataEase 中文文档最完善,出问题能找到人
- Evidence 升级就是
git pull——静态站没有"迁移"概念
八、License 与商业化
| 项目 | License | 商业版 | 关键合规点 |
|---|---|---|---|
| DataEase | GPL-3.0 | 企业版(飞致云卖服务) | GPL 系——二次分发需开源,但 SaaS 用不触发 |
| Superset | Apache-2.0 | Preset.io(原 Superset 公司被 Starburst 收购后分拆) | 最宽松,可以随便改、商用、闭源分发 |
| Metabase | AGPL(社区版) | Starter / Pro / Enterprise(分三档,云端/自托管都行) | AGPL——修改后对外提供服务也必须开源;商用版避开此约束 |
| Evidence | MIT | Evidence Studio(托管服务,可选) | 最宽松,等于没有约束 |
License 上的坑:
- Metabase AGPL 是企业最常踩的雷:你以为它是"宽松开源",但 AGPL 第 13 条要求"通过网络对外提供服务时也要开源"——SaaS 厂商用 Metabase 实质触发开源义务,必须买商业版。
- DataEase GPL-3.0 与 AGPL 类似但更严:不仅 SaaS,连内部二次分发都有传染性。中国企业用没问题(自用不触发),但不能把 DataEase 改造后卖给第三方。
- Superset / Evidence 都用最宽松的 Apache-2.0 / MIT——没有任何合规风险。这也是 Superset 在企业市场特别受欢迎的原因之一。
九、社区与市场评价
9.1 国际化程度
| 项目 | GitHub 主要 issue 语言 | 文档语言 | 出海可用度 |
|---|---|---|---|
| DataEase | 中文为主 | 中/英/日/繁/葡/阿/德/法/西/韩/印尼/土(README 自带 12 国切换) | 国内稳,出海有限 |
| Superset | 英文为主 | 英(社区有少量翻译) | ★★★★★ |
| Metabase | 英文 | 英(20+ 语言社区翻译,Crowdin 平台) | ★★★★★ |
| Evidence | 英文 | 英 | ★★★★ (新兴,文档英文好但案例少) |
9.2 真实客户与生态
- Superset:Airbnb(孵化方)、Uber、Twitter、Netflix、字节跳动内部都在用。Apache 生态让它进了几乎所有外企/国企的合规清单。
- Metabase:全球 9 万+ 公司使用,YC 持续注资。商用版定价清晰(社区版功能足够 5 人小团队)。Slack 集成做得最好。
- DataEase:在国内中小制造业、零售、教育、政企落地最多。Gitee/GitCode 同步仓库,中文社区活跃,飞致云提供企业级技术支持。
- Evidence:仍偏早期——典型用户是"懂 dbt 的小团队 + 个人开发者"。Stripe、Plaid 等欧美 fintech 有公开案例,但总数还不多。
9.3 第三方榜单与奖项
- DB-Engines BI 排行:Metabase 常年前 5,Superset 紧随其后,DataEase 在中文榜单常年前 3
- GitHub Octoverse(2025):Superset 是 BI 类别提交数最多的项目
- 中国信通院 2024-2025 年开源 BI 评测:DataEase 多次获评"可信开源项目"
十、按角色怎么选——四个真实场景
场景 A:5-20 人创业团队,业务主导,只想看报表
推荐:Metabase 社区版(自托管)或 DataEase
- Metabase 5 分钟上手,业务人员自助做图
- DataEase 中文环境更丝滑,有 SQLBot 智能问数
- 避开:Superset(运维重)/ Evidence(不会写代码用不了)
场景 B:中大型企业,数据中台 + 多数据源 + 严格合规
推荐:Apache Superset
- 60+ 数据源,生态最完整
- Apache-2.0 没有合规雷
- Kubernetes 上跑得很稳,有 Preset.io 提供商业支持
- 配合已有的 Python 数据团队,扩展性最强
场景 C:数据团队主导,要做 dbt 建模 + 让 AI Agent 参与建报表
推荐:Evidence.dev
- BI as Code,dbt 完美集成
- 静态站部署成本最低
- 报表定义在 Git 里,AI 能读能写
- 适合"工程师文化"团队,不适合"业务人员文化"团队
场景 D:国内政企/国企/教育/医疗,有国产化、信创、合规要求
推荐:DataEase
- 中文文档、中文社区、本土厂商技术支持
- 飞致云本身通过了多项国家级合规认证
- 数据源对国内数据库(TiDB、Doris、StarRocks)友好
- 老版本有信创栈适配(麒麟、统信)
十一、2026 年的几个判断
- GUI BI 不会消失,但代码 BI 会分走增长——Evidence 的 6,896 star 不多,但增速最快。AI Coding 大爆发让"会写代码的人"成为 BI 的目标用户。
- Metabase 的 open issue 数(4,446)是隐患——体量大、用户多、迭代快,但社区反馈"修不动"。如果你的业务强依赖 Metabase,建议锁定商业版 SLA。
- DataEase 是中文场景的"事实标准"——不是技术上最强,但本土生态 + 中文文档 + 飞致云商业化做的完整,出问题时有人兜底。
- Superset 在企业级仍是首选——Apache 生态的护城河不是几年代码能追平的。如果你要"一个能用十年"的 BI,选 Apache 系。
十二、速查对比表(一张图带走)
| 维度 | DataEase | Superset | Metabase | Evidence |
|---|---|---|---|---|
| Stars | 24.4k | 74.6k | 49k | 6.9k |
| License | GPL-3.0 | Apache-2.0 | AGPL | MIT |
| 主语言 | Java/Vue | Python/TS | Clojure/TS | Svelte/TS |
| 最近发布 | 2026-08-31 | 2026-05-13 | 2026-08-26 | 2026-02-06 |
| 数据源数量 | ~15 | 60+ | ~25 | ~15 |
| 国内生态 | ★★★★★ | ★★ | ★★ | ★ |
| 云数仓支持 | ★★ | ★★★★★ | ★★★★ | ★★★★ |
| AI 友好度 | ★★★ | ★★ | ★★★ | ★★★★★ |
| 学习难度 | ★★ | ★★★★ | ★ | ★★★ |
| 最小硬件 | 2C4G | 2C4G | 1C2G | 静态站 |
| 运维成本 | 中 | 高 | 低 | 最低 |
| 合规风险 | GPL | 最安全 | AGPL 雷区 | 最安全 |
| 适合场景 | 国内企业 | 中大型 | 业务主导 | AI/数据团队 |
选型是一道没有标准答案的题。如果只能记住一句话:你的报表是要给人看还是要给 AI 看?前者选 Metabase/DataEase,后者选 Evidence,要扛十年选 Superset。