
写给已经在用 Claude Code / Codex / Cursor 写代码,但总觉得「差点意思」的工程师朋友。如果你用 agent 写了一周代码,觉得"它能做,但总得盯着",这篇文章就是写给你的。
一句话总结(一分钟看完)
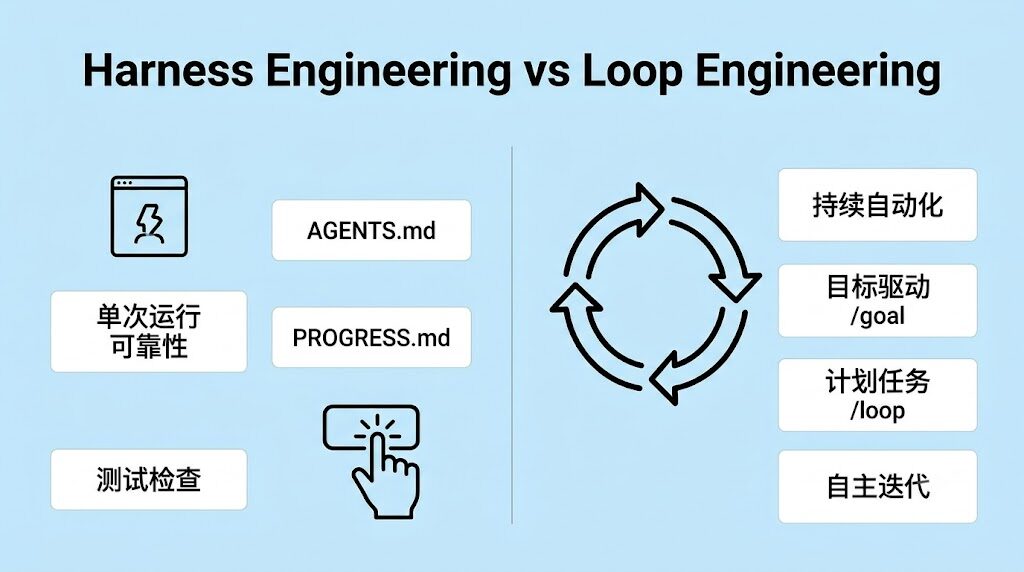
- Harness Engineering:把单次 Agent 运行变可靠。你写
AGENTS.md、建feature_list.json、配init.sh、留PROGRESS.md、给测试命令。核心问题是"这一轮能不能跑好"。 - Loop Engineering:让 Agent 在你不在场时持续运转。你用
/goal给目标而不是 prompt、用/loop做定时巡检、用 cron 做后台任务、用 worktree 隔离并行任务。核心问题是"我能不能把循环的'开始按钮'也交出去"。 - 两者关系:Loop Engineering 不是 Harness 的替代品,是它上面的一层楼。没有 Harness 的 Loop 是失控的发动机;没有 Loop 的 Harness 是停在车库里的好车。
一、为什么写这篇
2026 年 6 月,三个互不认识的人在同一周说了同一句话:
- Peter Steinberger(OpenClaw 作者):「你不应该再给 coding agent 写 prompt 了。你应该设计循环去 prompt 你的 agent。」
- Boris Cherny(Anthropic Claude Code 负责人):「我已经不手动 prompt Claude 了。我有一堆循环在跑。我的工作变成了写循环。」
- Addy Osmani(Google Chrome 工程负责人):把这件事命名成了 Loop Engineering,给了一句话定义——用系统取代你自己去 prompt agent。
这不是巧合。这是 2026 年 AI Agent 工程的「分水岭时刻」:模型够强了,prompt 不再是瓶颈,「谁来驱动 prompt」才是瓶颈。 如果你过去一年学了怎么写好 prompt、怎么拆任务、怎么给上下文,你已经走在 Harness Engineering 的路上了。但要再往前走一步——从「我手动按按钮」升级到「我自己跑循环」——你需要换一种思维方式。 这篇博客用 Claude Code 和 OpenClaw 的真实例子,把这两件事讲清楚。
二、Harness Engineering:让单次运行变可靠
2.1 一个反常识的真相
很多团队用了半年 Agent,觉得效果一般。然后升了模型版本,效果立竿见影。 但 OpenAI 和 Anthropic 的工程师告诉你一个反常识的事实:如果你把 Harness 优化好,用同一代模型,成功率可以从 20% 提到 80%。 一个团队的实测数据:他们做 20,000 行的 TypeScript + React 项目,用 GPT-4o,只调整 Harness(不换模型):
| 阶段 | 改了啥 | 成功率 |
|---|---|---|
| 1 | 只有 README 的项目描述 | 20%(5 次成功 1 次) |
| 2 | 加 AGENTS.md(技术栈、命名约定、架构决策) | 60% |
| 3 | AGENTS.md 里加验证命令(test + lint + build) | 80% |
| 4 | 加进度文件模板(PROGRESS.md) | 80-100% |
四次迭代,模型一个字没改。变的全是 Harness。 结论:模型权重之外的一切工程基础设施,决定了模型能力能被发挥多少。
2.2 Harness 五子系统
Anthropic 把 Harness 拆成五个子系统,缺一不可:
Rules(项目规则 / AGENTS.md / CLAUDE.md) → Agent
State(进度和 git / PROGRESS.md / commits) → Agent
Agent → Tools(shell / 文件 / 测试)
Tools → Env(运行环境 / 依赖 / 服务 / 版本)
Env → Checks(检查结果 / test / lint / build)
Checks → Agent
5 个子系统一句话解读:
- 指令(Rules):
AGENTS.md/CLAUDE.md是「给 agent 的项目说明书」。OpenAI 的建议是 100 行左右,放不下就拆到docs/子目录里。 - 状态(State):
PROGRESS.md+ git commits 是「agent 的外置大脑」。模型在会话之间什么都不记得,记忆必须在磁盘上。 - 工具(Tools):shell、文件读写、test runner。该开 shell 就开,禁了 shell 等于让 agent 闭着眼睛干活。
- 环境(Env):依赖锁定(
pyproject.toml/package.json)、运行时版本(.python-version/.nvmrc)、Docker 让环境可重现。 - 反馈(Checks):在
AGENTS.md里显式列出验证命令:
验证命令:
- 测试:pytest tests/ -x
- 类型检查:mypy src/ --strict
- Lint:ruff check src/
- 完整验证:make check反馈子系统通常是投入最少、回报最高。把「这个改完了吗」的判断从人变成机器,agent 才能独立完成任务。
2.3 Claude Code 的 Harness 实践
Claude Code 是 Harness Engineering 落地最完整的工具之一。它的设计就体现了 Harness 思想:
- 读
CLAUDE.md(指令子系统) - 能用 shell 跑命令(工具子系统)
- 会话历史保留(状态子系统)
- 能跑测试看结果(反馈子系统)
- 但如果你不告诉它怎么跑测试,它就没法验证自己做得对不对
Cursor 类似(.cursorrules 文件),但状态管理弱——关掉 IDE 再打开,上下文就没了。Codex 更进一步,用 git worktree 隔离每个任务的运行环境,配合本地的可观测性栈,让每个变更都在独立的环境中验证。
2.4 Harness 的边界
Harness 解决的是「这一轮跑得好不好」。但它解决不了一个问题:
每跑一轮都得有人按按钮。
你写好了 AGENTS.md、建好了 feature_list.json、init.sh 保证了环境一致、claude-progress.md 记录进度——但每一步仍需你手动发起。做完一个 feature,你要读进度文件,想一下下一个做什么,再输入指令。你是整个工作流的引擎。 Harness 让你成为更好的引擎。但 Loop Engineering 让你不再当引擎。
三、Loop Engineering:让 Agent 自己跑循环
3.1 三个真实故事
故事 1:Karpathy 的 autoresearch Andrej Karpathy 2026 年 3 月发布了一个 630 行的 Python 项目。给它一张 GPU、一份研究方向,它能自己跑一整夜,完成上百个 ML 训练实验,只保留真正有改进的。项目上线几天内获得 66,000+ star。 整个系统只有三个核心文件:
| 文件 | 谁来改 | 作用 |
|---|---|---|
| prepare.py | 没人(只读) | 数据准备、tokenizer、评估函数。固定的基础设施。 |
| train.py(~630 行) | AI Agent | 模型定义、优化器、训练循环。Agent 的实验场。 |
| program.md | 你 | 用自然语言写的研究方法论。 |
program.md 不是代码,是用 Markdown 写的研究指令。它描述了:优化目标、约束条件、探索方向、评估规则、以及一条铁律——「永远不要停。一旦开始循环,就一直跑下去。」 启动 prompt 甚至短到一句话:
看看 program.md,然后开始实验。剩下的全靠 agent 自己读文档、自己做决定。你的工作从写 Python 变成了「写研究组织文化」。 故事 2:Boris Cherny 的 30 天 Cherny(Claude Code 负责人)透露了一个数字:连续 30 天里,Claude Code 的所有代码贡献全部由 AI 自主完成,累计合并 259 个 PR,其中超过 80% 的生产代码由 Claude 编写,开放式软件任务成功率达到 76%。 他的原话:「我已经不手动 prompt Claude 了。我有一堆循环在跑。我的工作变成了写循环。」 故事 3:OpenAI 内部 OpenAI 工程师用类似的模式创建了约一百万行代码的 beta 产品,一行都没有手写。每天早上 9 点的「morning triage」自动跑:自动读昨天没解决的 issue、自动分类、自动 fork 子 agent 处理、自动开 PR、等工程师审阅。
3.2 Loop 的四种类别
按触发方式和停止方式的不同,Loop 可以分成四类:
| 类型 | 触发方式 | 停止方式 | 典型工具 | 适用场景 |
|---|---|---|---|---|
| 回合制 | 你手动输入每一条 prompt | agent 认为做完了,或你打断 | Claude Code 普通对话 | 小任务、探索性工作 |
| 目标驱动 | 你给一个目标 | 独立判断者确认达成,或达到最大回合数 | Claude Code /goal | 有明确完成标准的复杂任务 |
| 时间驱动 | 定时触发(每隔 N 分钟/小时) | 你手动停止,或任务完成后自行退出 | Claude Code /loop | 轮询状态、定期巡检、重复性工作 |
| 事件驱动 | 外部事件触发(PR 提交、CI 失败、新 issue) | 处理完事件就停,或达到重试上限 | Claude Code Routines / Codex Automations | 响应式工作流、CI/CD 集成 |
这四种 Loop 不是互相取代的关系,是工具箱里的不同工具。
3.3 /goal vs /loop:最容易搞混的两个
名字里都带 "loop",但它们解决的是完全不同的问题:
| /goal | /loop | |
|---|---|---|
| 本质 | 一个大任务,跑到完为止 | 同一个小动作,按间隔重复跑 |
| 停止条件 | 目标达成,或预算花完 | 你手动停,或任务做完自己退 |
| 时间特征 | 一次长跑(小时到天) | 周期性短跑(每次几分钟) |
| 状态累积 | 任务越跑越接近终点 | 每次都是独立的,不累积进度 |
| 类比 | 跑马拉松——撞线就停 | 闹钟——每隔一段时间响一次 |
| 典型用法 | "实现整个支付系统,有测试覆盖" | "每 15 分钟看一眼 CI 挂了没" |
判断该用哪个的一句话标准:这件事有终点吗?
- 有终点 →
/goal - 没终点,就是要一直盯着 →
/loop
一个常见错误:把该用 /goal 的事情塞进 /loop 里。比如 /loop 10m "继续实现支付系统"——这是错的,因为 /loop 每次都是独立跑一遍指令,不会记得上次做到哪了。
3.4 一个 Loop 的六大原语
Osmani 把构成 Loop 的零件归纳为六个原语——五组件 + 一个贯穿始终的记忆层:
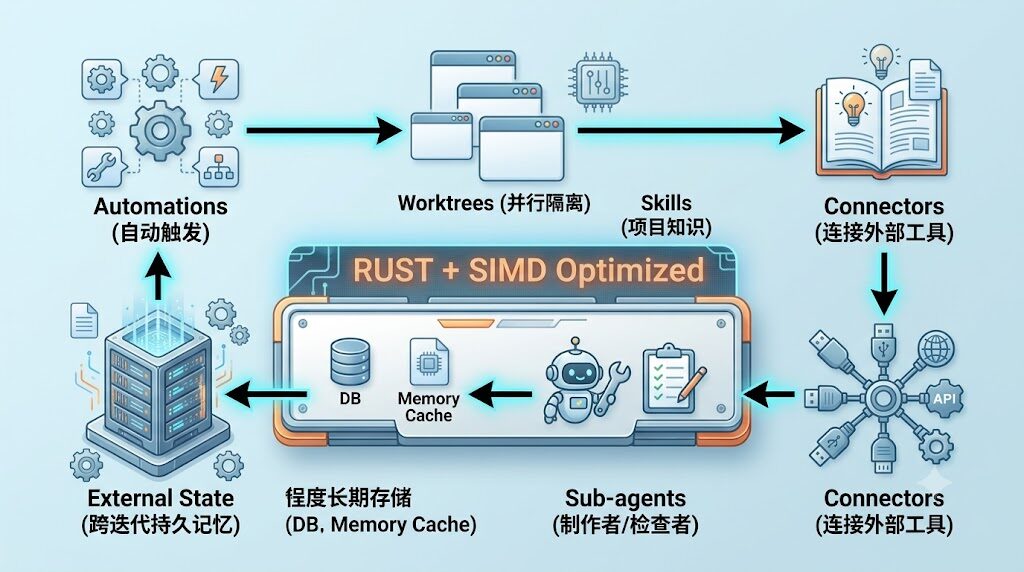
但要记住:External State 不是环上的一站,它是整个环的地基。 一句话解读:
- Automations:没有自动触发,loop 就不是 loop,只是你手动跑了一次。Claude Code 的
/loop、Codex 的 Thread automation 都是心跳。 - Worktrees:每个并行 agent 在自己的独立 git 分支上工作,物理上不可能碰到别人的修改。
- Skills:把项目知识写在
SKILL.md里,每个会话都读,而不是每次重新解释。Skill 是用来还「意图债务」——agent 每次启动都是「冷」的,你上下文里没写的东西,它就用自信的猜测填补。 - Connectors(MCP):让 agent 能读 issue tracker、查数据库、调 staging API。一个只能看到文件系统的 loop 是个小 loop。
- Sub-agents:把「写的人」和「检查的人」分开(Generator/Evaluator 分离)。
- External State:模型在会话之间什么都不记得。记忆必须在磁盘上,不能在上下文窗口里。
3.5 Generator/Evaluator 分离:Loop 可靠性的底线
这是 Loop Engineering 中最硬核的一条教训。 你让你最聪明的 agent 写了一段漂亮的代码。代码逻辑清晰、注释完整、测试全覆盖。你很满意。 但你有没有想过一个问题:如果让那个写了代码的 agent 自己来评判自己做得对不对,它会说什么? 答案已经被实践反复验证:它会给自己打高分。 不是因为它不诚实,而是因为它就是这段代码的作者——它在生成的时候已经说服自己这条路是对的。你让它回头看,它看到的不是错误,而是自己的推理过程。 模型是它自己输出最好的辩护律师。 解决方案就是:永远不用同一个人(同一个模型、同一个 prompt)既干活又检查。
- Claude Code 的
/goal底层的 supervisor 是一个独立的 session,独立判断是否达成目标 - Codex 的 subagent 体系让你定义验证 agent 可以和实现 agent 用不同模型、不同 reasoning effort
- 社区实践里的「adversarial verify」模式:每一个发现用 N 个独立的质疑 agent 来反驳它,多数否决则丢弃
这个原则用一句话总结:你的人里必须有一个不信你的。
四、两者关系:不是替代,是上下层
用一张图看明白:
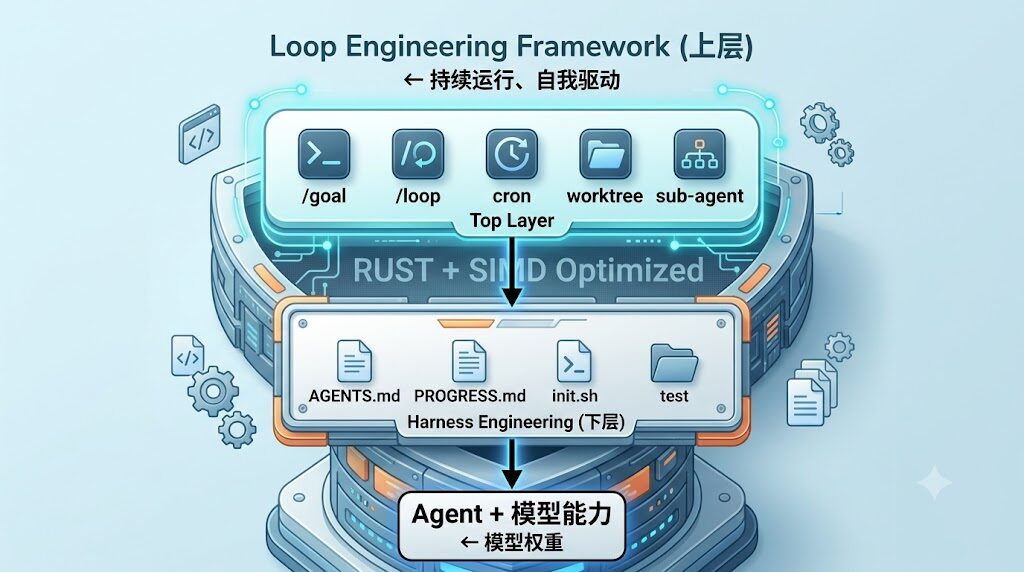
为什么 Loop 必须建在 Harness 之上? 因为 Loop 的核心是「放手让 agent 跑」。
但你放手的前提是它每一轮都跑得对。如果你的 Harness 不完善——没有验证命令、agent 写完代码就宣布完成、状态文件没人更新——那 Loop 跑起来只会更快地撞墙。
反过来说:Harness 完备但没用 Loop,意味着什么? 意味着你每次都在做「按按钮」的事,但按得很稳。你的成功率可能是 80-100%,但你永远无法离开键盘。
Harness 让你成为优秀的「按按钮的人」,但 Loop 让你成为「不按按钮的人」。 两者的协同路径:
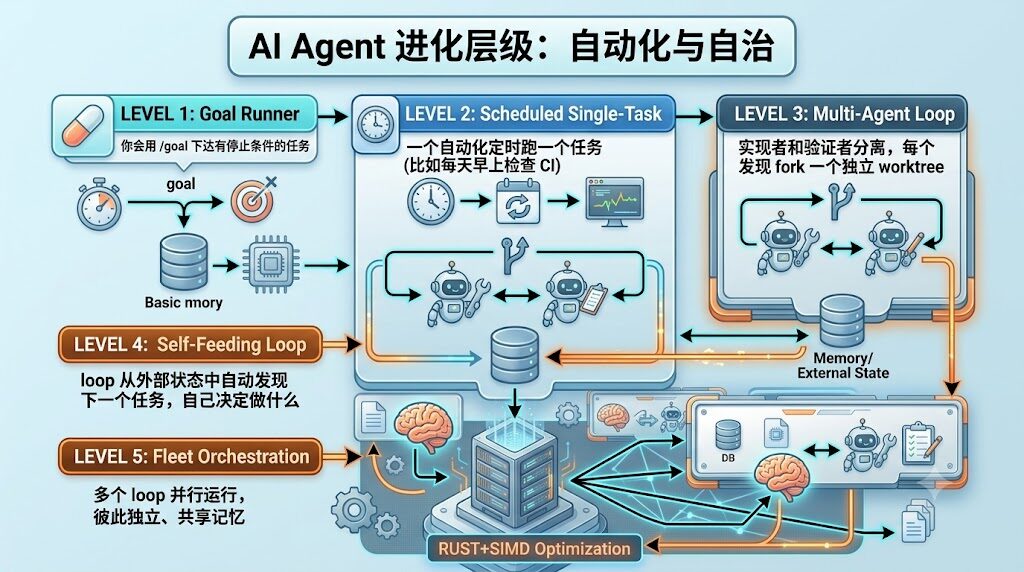
绝大多数团队目前卡在 Level 2 到 Level 3 之间。Level 1 是最快能看到回报的一步——你只需要把一个手动任务改写成 /goal 描述。
五、最佳实践:在 Claude Code / OpenClaw 中协调使用两者
5.1 先把 Harness 搭好(地基)
第一件事:在你最常用的项目根目录创建一个精炼的 AGENTS.md 或 CLAUDE.md,80-120 行。模板如下:
# AGENTS.md

## 项目概览
一段话说清这个项目是什么、做什么。

## 技术栈
- Python 3.12
- FastAPI / SQLAlchemy 2.0 / PostgreSQL 16
- 测试:pytest + httpx
- Lint:ruff + mypy

## 启动命令
- 安装依赖:uv sync
- 起本地 DB:docker compose up -d postgres
- 跑测试:uv run pytest
- 完整验证:make check(test + lint + type)

## 硬约束(不要违反)
- 禁止直接改 migrations/ 下的旧文件,新建 migration
- 所有 API 必须经过 Pydantic schema 校验
- 数据库操作必须走 SQLAlchemy session,不准用 raw SQL

## 进度跟踪
每完成一个 feature,更新 PROGRESS.md 的对应行。

## 项目特定细节
- 看 docs/architecture.md 了解模块边界
- 看 docs/db-schema.md 了解数据库表关系第二件事:建一个 init.sh 让 agent 知道环境怎么起:
#!/bin/bash
set -e
uv sync
docker compose up -d postgres
uv run alembic upgrade head第三件事:建 PROGRESS.md 模板:
# Progress

## 已完成
- [x] 用户登录 API(commit a1b2c3)
- [x] 商品列表分页(commit d4e5f6)

## 进行中
- [ ] 订单创建:写了 60%,待加事务边界

## 阻塞
- [ ] 支付回调:等沙箱 key

## 下一步
- 完善订单创建的事务逻辑
- 加订单创建的集成测试
5.2 再把 Loop 叠上去
第一步:找一件你每周至少做两次的事 比如:
- 早上打开 GitHub 看新 issue,分类和回复
- 每次 PR 审核前跑一遍 lint + test
- 每天结束前更新
PROGRESS.md
第二步:写一个 /goal 描述
/goal "每天早上 9 点扫一遍仓库未处理的 issue。
对于每个 issue:
  - 如果已经有明确标签和负责人,跳过
  - 如果没有标签,根据内容打上 bug/feature/docs 标签
  - 如果是明确的小 bug 且 10 分钟能修,创建 fix 分支并尝试修复
停止条件:所有符合条件的 issue 都已处理,或遇到需要我决策的复杂问题。
完成后把需要我看的 issue 列表写入 NEEDS_REVIEW.md。"
第三步:分离 maker 和 checker 把 loop 拆成两个角色:
- 实现 agent:读 issue、写修复、写测试
- 验证 agent:独立运行测试、审查 diff、给出 PASS/FAIL
第四步:加记忆 用 PROGRESS.md + RESULTS.tsv(类似 autoresearch 的实验记录)记录 loop 每次运行的结果。 第五步:设一个定时器
# Claude Code 会话内(开了会话才跑)
/loop 60m "读 PROGRESS.md,按 /goal 描述处理剩余 issue"

# 真正后台定时(机器开着就跑)
crontab -e
0 9 * * * cd ~/projects/myapp && claude -p "$(cat .loop-prompt.md)"
5.3 OpenClaw 的 Loop 实战
OpenClaw 是 Harness + Loop 实践密度最高的工程化平台之一。它的设计本身就体现了「Agent 不只是聊天,是有状态的工程系统」: OpenClaw 的 harness 设施:
MEMORY.md作为长期记忆memory/YYYY-MM-DD.md作为每日工作日志AGENTS.md定义工作流和委托模式skills/目录存放可复用 skill(每个 SKILL.md 是项目特定知识)IDENTITY.md/SOUL.md定义 agent 人格与红线
OpenClaw 的 loop 设施:
openclaw cron add创建定时任务sessions_spawn启动子 agent 做并行任务sessions_yield等子 agent 完成failureAlert自动告警机制subagents工具查询子 agent 状态
一个真实的 OpenClaw Loop 示例:
# 创建每天中午 12:40 的 GitHub 星标项目分析任务
openclaw cron add \
  --name "GitHub 星标项目每日分析" \
  --cron "40 12 * * *" \
  --tz "Asia/Shanghai" \
  --session isolated \
  --agent it-engineer \
  --message "执行每日 GitHub 星标项目分析:抓 trending → 写 markdown → 生成 docx → 写 Obsidian → 发飞书 → 派张小鸣发博客" \
  --announce \
  --channel feishu \
  --to "段总 open_id" \
  --failure-alert \
--failure-alert-after 1关键设计:
- Harness 层:
SKILL.md详细描述每一步怎么做、有哪些已知陷阱(避免 LLM 每次重新发明轮子) - Loop 层:cron 自动触发,失败自动告警,结果推送到飞书
- Generator/Evaluator 分离:主任务负责实现,张小鸣是独立的 content promotion agent 负责质量校验和发布
- External State:每次执行结果写到 Obsidian + 完成回执
.done文件
5.4 协调使用的「三层检查清单」
每次你搭一个新的 Loop,先问自己三个问题: Layer 1(Harness):单次跑得对吗?
- [ ] agent 能找到完整的项目说明书(
AGENTS.md)吗? - [ ] 验证命令在
AGENTS.md里显式列出了吗? - [ ] 进度文件存在吗?agent 知道每一步该交付什么吗?
- [ ] 环境可重现吗?(依赖锁定、Docker)
Layer 2(Loop):能自己跑起来吗?
- [ ] 触发方式是「自动」吗?(cron /
/loop/ event-driven) - [ ] 停止条件是「机器可验证」的吗?(不是「感觉差不多」)
- [ ] 失败时有人/系统能接到告警吗?
Layer 3(Reliability):跑久了还稳吗?
- [ ] maker 和 checker 分开了吗?(不是同一个 agent 自评)
- [ ] 并行任务用 worktree 隔离了吗?
- [ ] 状态文件定期归档吗?(避免上下文无限增长)
- [ ] token 增长曲线合理吗?(避免「令牌爆炸」)
5.5 四个最容易踩的坑
坑 1:把 /goal 当 /loop 用 /loop 10m "继续实现支付系统"——/loop 每次独立跑,不记进度,每次都从零开始。用错命令类型 = Loop 形同虚设。
坑 2:让一个 agent 既干活又检查 「你写的代码再 review 一下」——这句话在 Loop 里是大忌。Generator 和 Evaluator 必须分离,可以用同一模型的不同 session,但绝不能是同一次运行。
坑 3:停止条件用「感觉」 「看起来差不多就行了」——这是 Loop 失控的起点。停止条件必须是机器可验证的命令,比如 pytest tests/ -x && mypy src/ --strict && ruff check src/。
坑 4:loop 跑得快但人不读结果 Cherny 的团队 80% 代码是 agent 写的——这意味着大部分代码不是人写的。如果不读不用,你对系统的理解会持续衰减(Comprehension Rot)。Loop 加速的不仅是产出,也包括风险。
六、四种沉默成本:跑得越久越尖锐
Loop 跑起来之后,你不会立刻看到问题。以下四种成本会沉默地累积:
6.1 Verification Debt(验证负债)
Loop 跑得快的时候,你很容易跳过验证。「看起来没问题」不等于「确实没问题」。loop 里自动生成的代码越多,验证债务积累越快。
6.2 Comprehension Rot(理解腐烂)
Loop 出代码的速度越快,你对自己代码库的理解就越跟不上。快速跑 Loop 的前提是快速读结果。
6.3 Cognitive Surrender(认知投降)
Loop 跑得顺的时候,最舒服的姿势就是不再有观点。来什么接什么。但这恰恰是危险的开始——你在用 Loop 逃避思考,而不是用 Loop 放大思考。 Osmani 的警告:「两个人可以造完全一样的 loop,得到完全相反的结果。一个用它加深理解后加速,另一个用它代替理解。loop 不知道区别,你知道。」
6.4 Token Blowout(令牌爆炸)
Loop 的每一次迭代都会积累更多上下文。如果不做上下文压缩,prompt size 会随着迭代次数近似平方增长。 Codex 的解决方案是自动 context compaction——用专门的 API 把老的对话轮次压缩成加密的内容摘要,保留关键知识、丢弃冗余细节。这是每个 Loop 设计之初就要考虑的工程问题。
七、给读者的 5 步上手路线
如果你看完这篇有点心动但不知道从哪开始,按下面 5 步走:
第 1 步:先做 Harness 五元组审计(今天就能做)
拿你正在用 AI agent 的项目,按 5 个子系统打分(1-5)。找出最低分的那个子系统,花 30 分钟改进它,然后观察 agent 的表现变化。 最常被忽略的子系统:反馈。把验证命令显式写进 AGENTS.md,比加更多 prompt 提示都管用。
第 2 步:把一个手动任务改写成 /goal(本周)
找一个你每周至少做两次的事。写下它的目标、验证方式和停止条件。用 /goal 跑一次,比较和手动做的时间和结果质量。 这是从 Harness 到 Loop 的第一步,也是回报最快的一步。
第 3 步:分离 maker 和 checker(下周)
挑一个你之前让 agent 执行过的任务。写两份不同的 prompt:一份给实现 agent,一份给验证 agent(可以用不同模型)。验证 agent 必须逐条指出问题并引用证据。 你会发现:在分离之前,40% 的「已经做完了」其实没做完。
第 4 步:加记忆文件(两周内)
为你的 loop 创建一个 markdown 状态文件。在 loop 的每一轮中写入:本轮做了什么、验证结果、状态(通过/失败/阻塞)、下一轮该做什么。 跑三轮,对比有记忆和无记忆的 agent 行为差异。
第 5 步:定时器接入(一个月内)
用 /loop 命令或操作系统的 cron,让你的 Loop 在没有你的时候也能启动。先从每天一次开始,观察一周。 如果一周年后你回头看,会发现这是你职业生涯 ROI 最高的 30 天。
八、写在最后:价值杠杆的转移
2026 年 AI 编程世界发生了两件事:
- Harness Engineering 把「单次运行成功率」从 20% 提到 80%——不用换模型,只改工程基础设施。
- Loop Engineering 把「你手动按按钮」变成「系统自己按按钮」——不用换模型,只改你与模型的协作模式。
两件事加起来,意思是:
你的价值杠杆,已经从「写对 prompt」转移到了「设计对的循环」。
一年前,会写 prompt 的人是香饽饽。半年后,会搭 Harness 的人是中坚。现在到未来 12 个月,会设计 Loop 的人是真正稀缺的。 而 Loop Engineering 的入门门槛,可能比你想象的低:一个 /goal 描述 + 一个 cron 表达式 + 一个 markdown 记忆文件,就是你的第一个 Loop。
附录:参考资料
- Addy Osmani: Loop Engineering(最权威定义)
- Addy Osmani: Agent Harness Engineering
- OpenAI: Harness Engineering
- Anthropic: Effective Harnesses for Long-Running Agents
- Karpathy: autoresearch
- Simon Willison: Designing Agentic Loops
- Claude Code: Dynamic Workflows and Orchestration
- 中文学习库:walkinglabs/learn-harness-engineering