
前段时间,心血来潮,用5个晚上时间,通关了影刀开发者认证,拿到从初级到高级的证书。
没系统学过影刀,但在近5年时间边干边学,为影刀熬了无数夜,这个认证拿的自觉实至名归。
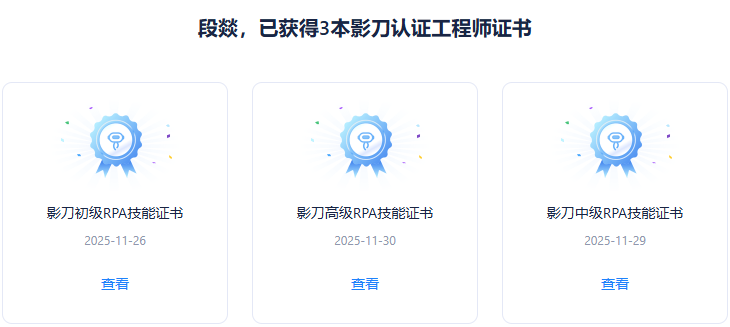
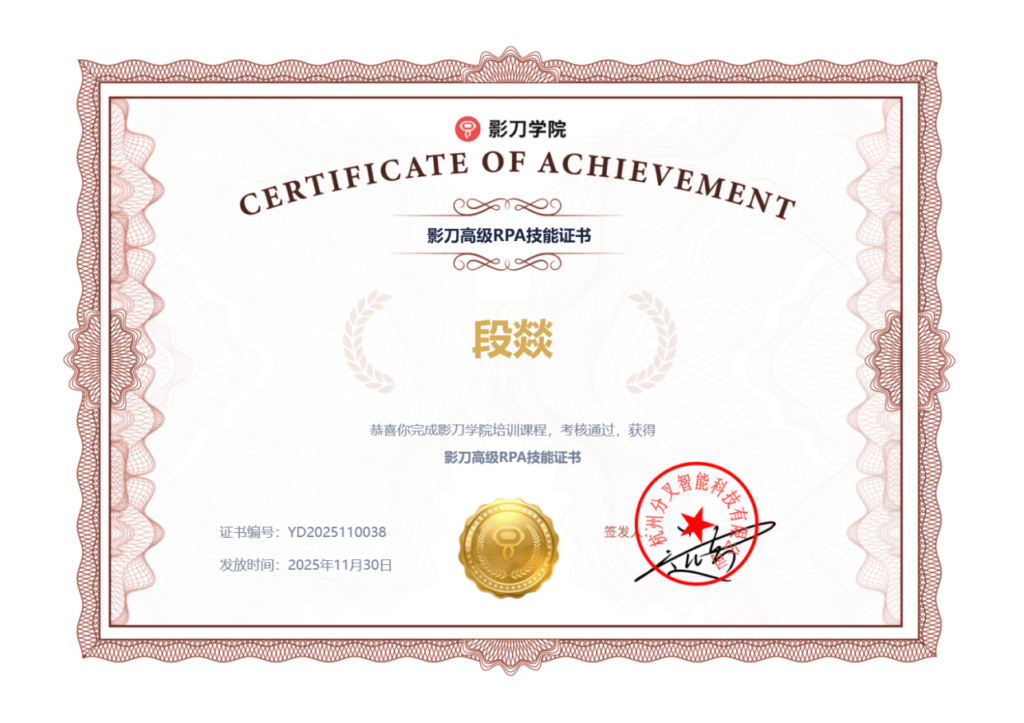
高级认证的难点,主要在操作题。不知道题库中一共有多少。把我自己做到的两道题目分享出来,供有兴趣的影刀学习者参考。
题一:抓取页面电影排行榜数据,并写入数据库。记得是要求抓取元素使用XPath,使用编程版。
1. 主流程
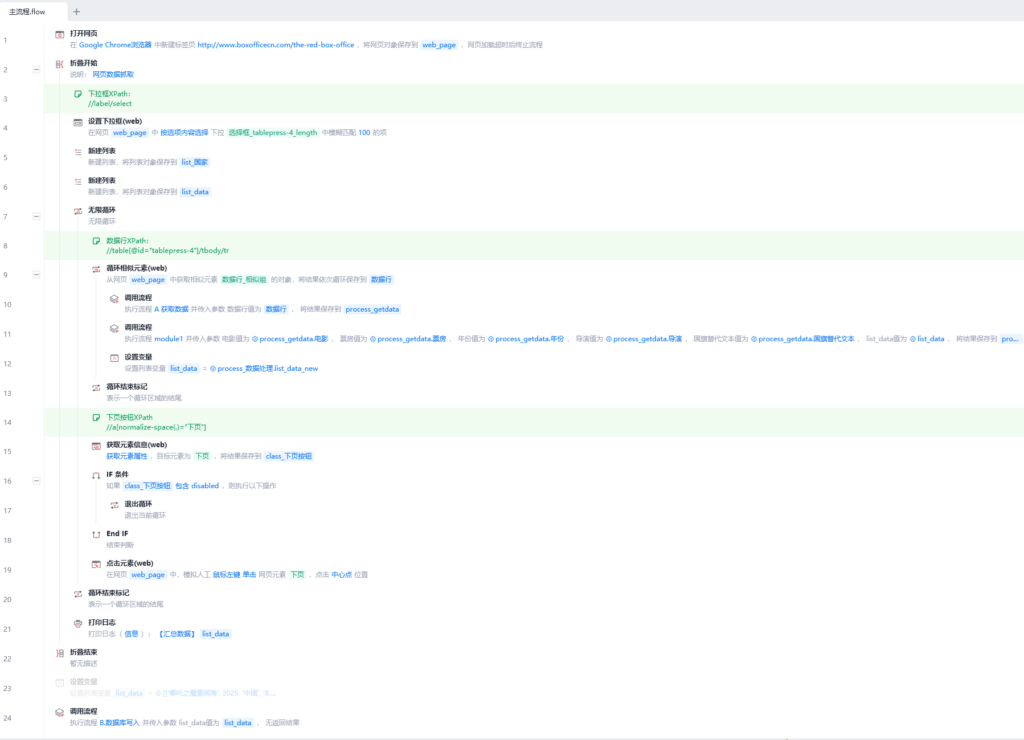
数据页面网址:http://www.boxofficecn.com/the-red-box-office
准备考高级认证的,可以先熟悉一下这个网页,没准也抽到使用这个网页的题目。
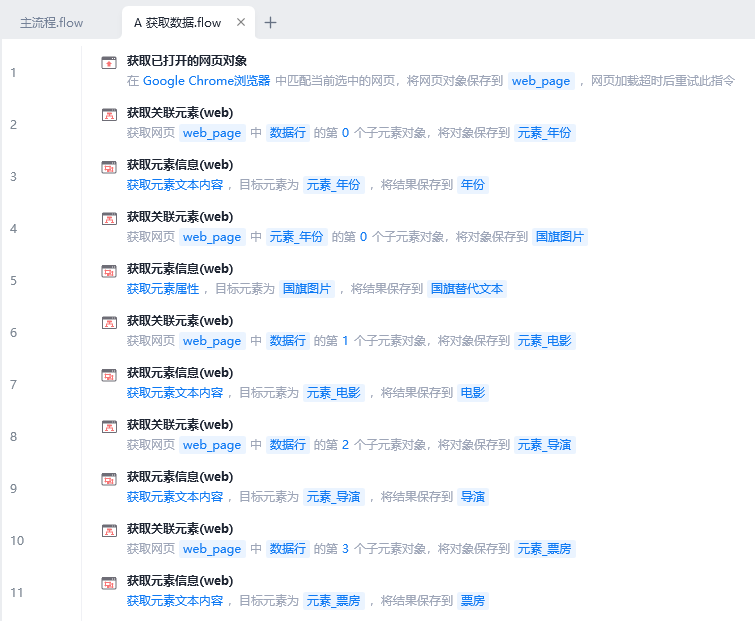
2. 抓取页面数据
3. 写入数据库
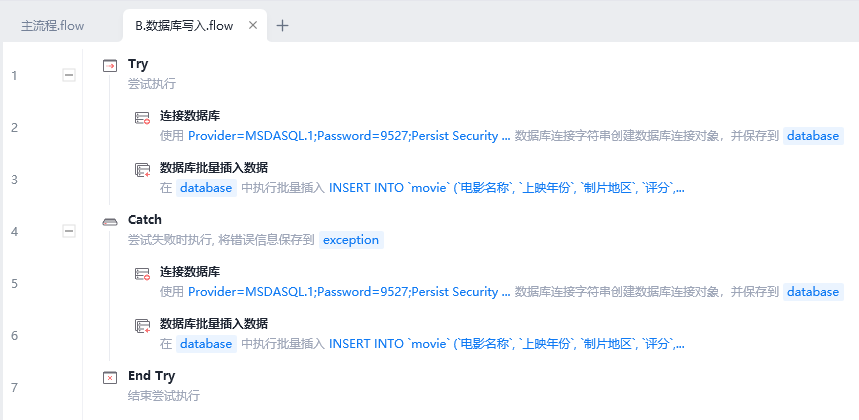
连接数据库代码:
Provider=MSDASQL.1;Password=9527;Persist Security Info=True;User ID=yingdao;Data Source=yingdao_unicode;Initial Catalog=ydtest
重要提醒:
在认证考试前,一定要调试好影刀与数据库的连接。记得以前在连接数据库时,花了很长时间,走了大弯路。如果到考试时才安装必须的环境,时间一定会紧张。
官方教程中,强调安装ODBC连接器,一定要选择32位版本。这个教程的背景,应该还是影刀只有32位版的时期。目前,大部分影刀使用者,安装的影刀版本应该都是64位版的了,所以对应一定要安装64位ODBC版本。否则连接数据库就一定会出错。切记!
4. Python代码
import xbot
from xbot import print, sleep
from .import package
from .package import variables as glv
import re

def main(args):
    电影 = args["电影"]
    票房 = args["票房"]
    年份 = args["年份"]
    导演 = args["导演"]
    国旗替代文本 = args["国旗替代文本"]
    list_data = args["list_data"]

    国家词典 = {'🇨🇳': '中国', '🇺🇸': '美国', '🇮🇳': '印度', '🇯🇵': '日本',
              '🇫🇷': '法国', '🇬🇧': '英国', '🇫🇮': '芬兰', '🇦🇺': '澳大利亚', '🇱🇧': '黎巴嫩'}

    制片地区 = 国家词典.get(国旗替代文本, "未知地区")

    评分匹配 = re.search(r"((.*))", 电影)
    if 评分匹配:
        评分 = 评分匹配.group(1)
    else:
        评分 = None

    电影名匹配 = re.search(r"(.*)(", 电影)
    if 电影名匹配:
        电影名 = 电影名匹配.group(1).strip()
    else:
        电影名 = None

    年份 = int(年份) # if 年份 and str(年份).isdigit() else 0

    票房数字 = re.findall(r"\d+", 票房)
    if 票房数字:
        票房数 = int("".join(票房数字))
    else:
        票房数 = 0

    当前行数据 = [电影名, 年份, 制片地区, 评分, 导演, 票房数, "kizemo"]

    if list_data is None:
        list_data = []
    list_data.append(当前行数据)
    list_data_new = list_data
    args["list_data_new"] = list_data_new

    args["list_data"] = list_data_new
    args["电影名"] = 电影名
    args["评分"] = 评分
    args["票房数"] = 票房数
    args["制片地区"] = 制片地区

    print("提取的电影名:", 电影名)
    print("提取的评分:", 评分)
    print("提取的票房数:", 票房数)
    print("制片地区:", 制片地区)
    print("当前行数据:", 当前行数据)
    print("更新后的list_data:", list_data_new)

    return args
5. 部分元素XPath定位
下拉框XPath://label/select
数据行XPath://table[@id="tablepress-4″]/tbody/tr
下页按钮XPath://a[normalize-space(.)="下页"]
题二:使用API获取数据并上传数据库
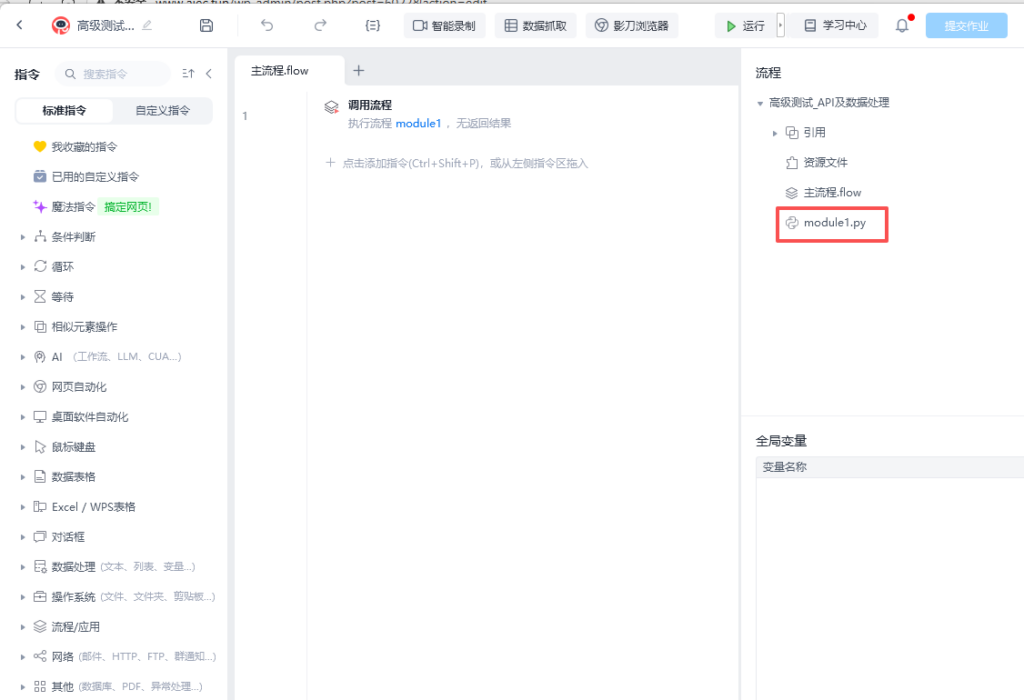
主要用编程版搞定:
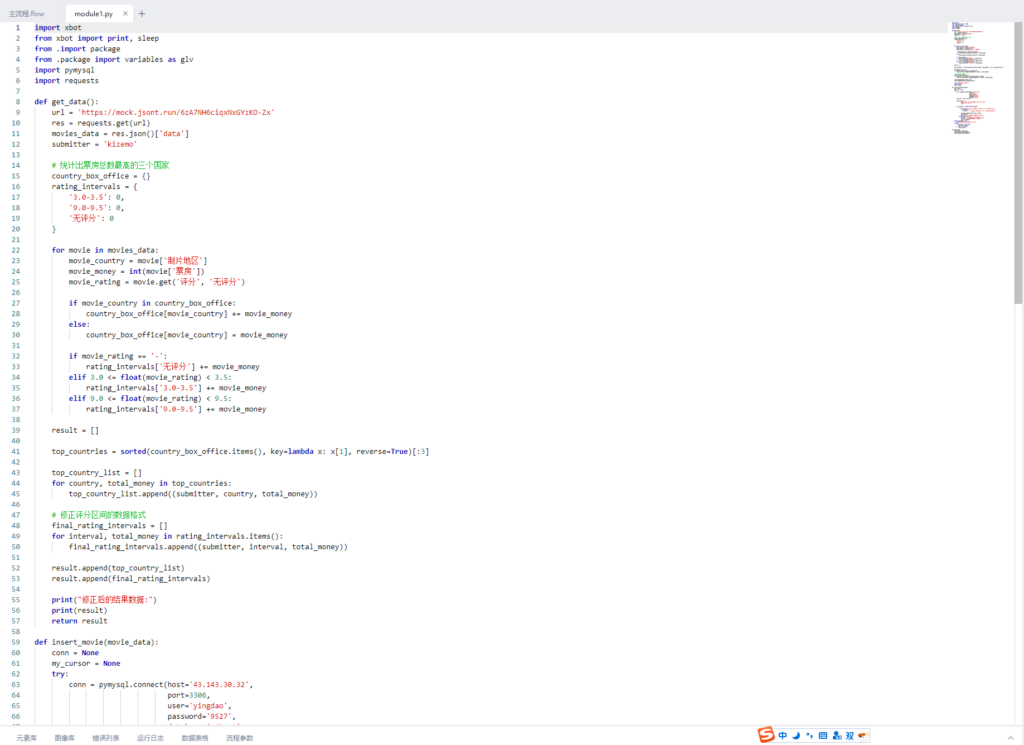
import xbot
from xbot import print, sleep
from .import package
from .package import variables as glv
import pymysql
import requests

def get_data():
    url = 'https://mock.jsont.run/6zA7NH6ciqxNxGYzKO-Zx'
    res = requests.get(url)
    movies_data = res.json()['data']
    submitter = 'kizemo'

    # 统计出票房总数最高的三个国家
    country_box_office = {}
    rating_intervals = {
        '3.0-3.5': 0,
        '9.0-9.5': 0,
        '无评分': 0
    }

    for movie in movies_data:
        movie_country = movie['制片地区']
        movie_money = int(movie['票房'])
        movie_rating = movie.get('评分', '无评分')

        if movie_country in country_box_office:
            country_box_office[movie_country] += movie_money
        else:
            country_box_office[movie_country] = movie_money

        if movie_rating == '-':
            rating_intervals['无评分'] += movie_money
        elif 3.0 <= float(movie_rating) < 3.5:
            rating_intervals['3.0-3.5'] += movie_money
        elif 9.0 <= float(movie_rating) < 9.5:
            rating_intervals['9.0-9.5'] += movie_money

    result = []

    top_countries = sorted(country_box_office.items(), key=lambda x: x[1], reverse=True)[:3]

    top_country_list = []
    for country, total_money in top_countries:
        top_country_list.append((submitter, country, total_money))

    final_rating_intervals = []
    for interval, total_money in rating_intervals.items():
        final_rating_intervals.append((submitter, interval, total_money))

    result.append(top_country_list)
    result.append(final_rating_intervals)

    print("修正后的结果数据:")
    print(result)
    return result

def insert_movie(movie_data):
    conn = None
    my_cursor = None
    try:
        conn = pymysql.connect(host='43.143.30.32',
                               port=3306,
                               user='yingdao',
                               password='9527',
                               database='ydtest',
                               charset='utf8')
        my_cursor = conn.cursor()

        insert_sql = """
                INSERT INTO result (提交人, 信息, 票房总数)
                VALUES (%s, %s, %s)
                """

        for i, movie in enumerate(movie_data):
            try:
                print(f"正在插入第 {i} 条数据: {movie}, 类型: {type(movie)}")
                if len(movie) > 0:
                    print(f"  第一个元素: {movie[0]}, 类型: {type(movie[0])}")

                my_cursor.execute(insert_sql, movie)
                conn.commit()
                print(f"第 {i} 条数据插入成功: {movie}")
            except Exception as e:
                print(f"第 {i} 条数据插入时发生错误: {e}")
                print(f"  错误的数据内容是: {movie}")
                conn.rollback()
    except Exception as e:
        print(f"数据库连接或操作错误: {e}")
    finally:
        if my_cursor is not None:
            my_cursor.close()
        if conn is not None:
            conn.close()

def main(args):
    result_data = get_data()
    insert_movie(result_data[0])
    insert_movie(result_data[1])
阅读量:
801