
jamiepine/voicebox 是开源的 AI 语音工作站,把声音克隆、多引擎 TTS、全局听写、MCP Agent 语音输出整合进一个本地应用。2026-06-23 以 529 颗单日星标冲上 GitHub Trending AI 榜第 3,是 ElevenLabs(输出)和 WisprFlow(输入)的免费开源合二为一替身,MIT 协议,macOS / Windows / Linux / Docker 全平台覆盖。
今天(2026-06-23)GitHub 一个叫 jamiepine/voicebox 的项目在 24 小时内拿到了 529 颗星,它解决的问题很特别:把 ElevenLabs 和 WisprFlow 各自做的事,合并到一个本地应用里。
从产品形态看,它没有选择做单一功能的 TTS 应用——而是把声音克隆、TTS 生成、全局听写、MCP Agent 语音输出四件事打包成一个桌面应用,所有功能都在你的机器上运行。MIT 协议、完全免费、可商用。
如果你是第一次听说这两个对比对象,ElevenLabs 是当前最主流的 AI 配音云服务,按月订阅(起步 5 美元/月);WisprFlow 是 macOS 上的语音输入法,按键说话直接转文字。它们一个负责"机器开口说话",一个负责"人对着机器说话"——Voicebox 想要两边一起做。
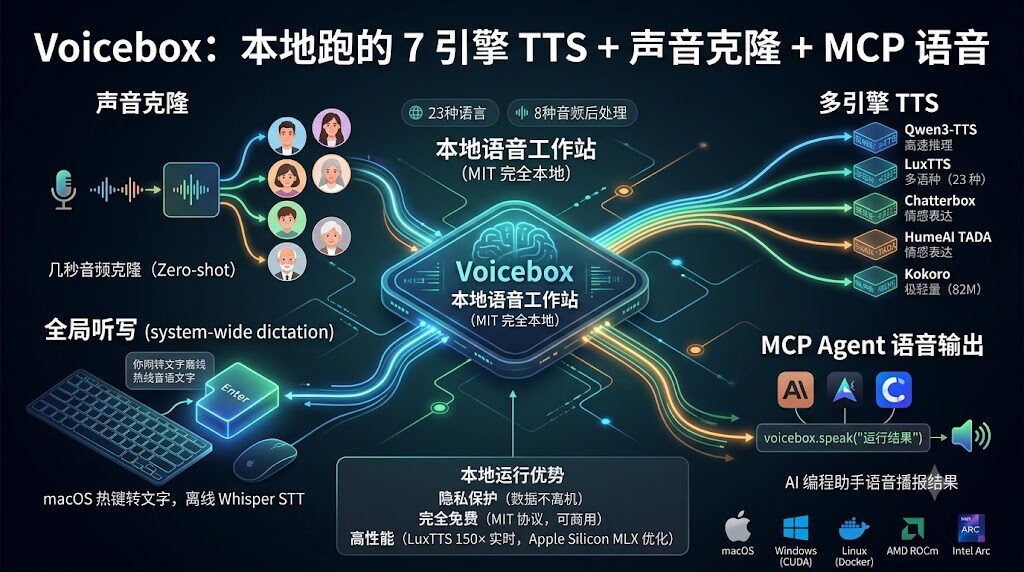
一、Voicebox 到底是什么:四合一本地语音工作站
Voicebox 的核心思路不是"做一款 TTS 应用",而是把语音相关的所有能力整合到一个本地工作流。从产品形态看,它包含四大模块:
- 多引擎 TTS:集成了 7 种不同的文字转语音引擎(后面会展开介绍)
- 零样本声音克隆(zero-shot voice cloning):几秒钟音频就能克隆一个人的声音
- 全局听写(system-wide dictation):类似 WisprFlow 的全局热键转文字,macOS 专用
- MCP Agent 语音输出:让 Claude Code / Cursor / Cline 这类 AI 编程助手能用语音播报结果
几个关键事实:
- License:MIT,完全开源,可商用
- 单日星标:529⭐(2026-06-23,GitHub Trending AI 榜第 3)
- 平台支持:macOS(Apple Silicon MLX/Metal 优化)、Windows(CUDA)、Linux(Docker)、AMD ROCm、Intel Arc
- 安装方式:DMG / MSI 安装包 + Docker 一键启动
二、核心功能详解:7 种 TTS 引擎不是噱头
Voicebox 最大的差异化是多引擎架构——同一段文字,你可以选 7 种不同的 TTS 引擎生成,每种引擎有不同的音色、语言、性能特点。这种"换着用"的体验是 ElevenLabs(单一云端引擎)做不到的:
| TTS 引擎 | 参数规模 | 核心特点 |
|---|---|---|
| Qwen3-TTS 0.6B | 0.6B | 阿里通义千问 3 代,MLX 优化,量化后约 1GB VRAM |
| Qwen3-TTS 1.7B | 1.7B | 大杯版 Qwen3,量化后约 3GB VRAM,MLX 优化 |
| Qwen CustomVoice | — | 通义千问官方音色库,跨语种稳定 |
| LuxTTS | — | 极轻量,约 1GB VRAM,CPU 推理可达 150× 实时(生成 1 分钟音频只需 0.4 秒) |
| Chatterbox Multilingual | — | 支持 23 种语言,含阿拉伯语、日语、印地语、斯瓦希里语等小语种 |
| Chatterbox Turbo | 350M | 快速版,支持情感标签控制语调 |
| HumeAI TADA | 1B / 3B | HumeAI 旗舰模型,专注情感表达 |
| Kokoro | 82M | 轻量之王,CPU 快速推理,内置 50 种预设音色 |
除了多引擎 TTS,Voicebox 还有几个值得单独说的功能:
- 零样本声音克隆(zero-shot voice cloning):只需要几秒钟的目标声音音频,无需专门训练,模型就能"学会"这个声音。多采样可逐步提升克隆质量。
- 23 种语言支持:覆盖英语、阿拉伯语、日语、印地语、斯瓦希里语等。比起 WisprFlow(英文为主)和 ElevenLabs(云端数十种但收费),本地免费的多语种是个差异化亮点。
- 全局听写(system-wide dictation):全系统热键触发,说完自动粘贴到任意文本框——这是 WisprFlow 的核心功能,Voicebox 直接对标做了一遍(目前 macOS 可用)。
- MCP Agent 语音输出:通过 MCP(Model Context Protocol,模型上下文协议)让 Claude Code、Cursor、Cline 这些 AI 编程助手能用语音播报结果。一行代码
voicebox.speak()即可调用。 - 音色人格(voice persona):给 TTS 附加性格描述(如"毒舌编辑"、"温柔姐姐"),由本地 LLM 重写文本后调用 TTS 生成——声音也有了"人设"。
- 故事编辑器(story editor):多轨时间线编辑,可制作对话 / 播客场景。
- 后处理效果:内置 8 种音频后处理——混响(reverb)、延迟(delay)、合唱(chorus)、压缩(compressor)、变调(pitch shift)等。
- Whisper STT:本地语音转文字,支持 Base / Small / Medium / Large / Turbo 五种模型尺寸,无需联网。
- Captures 存档:所有听写和录音自动存档为原音频 + 转录文本配对,方便回溯。
三、性能数据:CPU 跑 150× 实时是真的吗
Voicebox 在性能上做了不少工程优化,核心数据如下:
| 引擎 | 内存/显存占用 | 推理速度 |
|---|---|---|
| LuxTTS | 约 1GB VRAM | CPU 150× 实时(即生成 1 分钟音频只需 0.4 秒) |
| Kokoro | 82M 参数 | CPU 快速推理 |
| Qwen3-TTS 0.6B | 量化后约 1GB | MLX 优化(Apple Silicon 专用加速) |
| Qwen3-TTS 1.7B | 量化后约 3GB | MLX 优化 |
| Chatterbox Turbo | 350M 参数 | 快速推理 |
平台兼容性方面,Voicebox 做了完整的硬件覆盖:
- macOS:Apple Silicon 走 MLX/Metal 加速;Intel Mac 也有 DMG 包但速度较慢
- Windows:NVIDIA CUDA 加速
- Linux:推荐 Docker 一键部署,源码编译路径也已支持
- AMD / Intel 显卡:ROCm 和 Intel Arc 都有适配
四、安装部署:DMG / MSI / Docker 三条路
Voicebox 提供了三种主流安装方式,按用户类型选择:
# macOS (Apple Silicon) — 推荐 MLX 加速
# 下载 DMG: https://voicebox.sh/download/mac-arm

# macOS (Intel) — 速度较慢但可用
# 下载 DMG: https://voicebox.sh/download/mac-intel

# Windows — NVIDIA CUDA 加速
# 下载 MSI: https://voicebox.sh/download/windows

# Linux (源码编译) — 开发者向
# 见 https://voicebox.sh/linux-install

# Docker — 跨平台统一方案
docker compose up从安装命令可以看出:macOS 用户体验最佳(有 Apple Silicon MLX 加速的 DMG),Windows 用户其次(CUDA 依赖 NVIDIA 显卡),Linux 用户最折腾(要么 Docker,要么源码编译)。这也是为什么"全局听写"功能目前只支持 macOS——底层的系统级音频 API 在 macOS 上最容易做。
五、和 ElevenLabs / WisprFlow 怎么比:一张表看懂
这是大家最关心的部分——Voicebox、ElevenLabs、WisprFlow 三者的能力边界:
| 特性 | Voicebox | ElevenLabs | WisprFlow |
|---|---|---|---|
| 声音克隆 | ✅ 零样本,多引擎 | ✅ 付费 | ❌ |
| TTS 引擎数量 | ✅ 7 种 | 单一 | 单一 |
| 语言数量 | 23 种 | 数十种 | 英文为主 |
| 全局听写 | ✅(macOS) | ❌ | ✅ |
| Agent 语音输出 | ✅ MCP 协议 | ❌ | ❌ |
| 本地运行 | ✅ 完全本地 | ❌ 云端 | 部分本地 |
| 价格 | 免费开源 | 付费订阅 | 付费 |
| 后处理效果 | 8 种 | 有限 | 无 |
| 故事编辑器 | ✅ | ❌ | ❌ |
三个差异化亮点值得单独提:
- MCP Agent 语音输出是 Voicebox 独有——ElevenLabs 和 WisprFlow 都不做这件事。Claude Code / Cursor / Cline 这些 AI 编程助手通过一行
voicebox.speak()调用,就能用语音播报结果,对长时间盯屏幕的开发者来说很实用。 - 本地运行意味着数据不离开机器——声音克隆、医疗记录、有声书制作等场景下,隐私和合规要求很重要。Voicebox 完全离线,ElevenLabs 必须把音频传到云端。
- 多引擎可换着用——同一段文字,Qwen3-TTS、Kokoro、Chatterbox 出来的声音调性完全不同,可以根据场景切换。
六、💡 落地案例:什么场景值得本地部署
从技术分析角度,Voicebox 不是"什么场景都该部署"的工具——它有自己的适用边界。以下是基于性能、隐私、成本的部署建议:
适合部署的场景:
- 需要给现有 AI Agent(Claude Code / Cursor)增加语音播报能力
- 需要批量制作有声内容(播客、有声书、营销视频配音)且对数据隐私敏感(如医疗、法律、教育领域)
- 需要在弱网或离线环境使用 TTS(如出差、户外作业、保密项目)
- 需要克隆特定人声(已获得授权的前提下)做内容生产
不建议部署的场景:
- 只是偶尔生成几段配音——直接用 ElevenLabs 或国产云服务更划算
- 需要 24/7 高并发生产——本地 GPU 资源有限,云端的弹性扩展更适合
- 对中文音色要求极高——目前 Qwen3-TTS 的中文表现仍有进步空间
资源评估:7 种 TTS 引擎 + Whisper + 本地 LLM 全开,内存和 GPU 消耗都不小。Apple Silicon Mac(M2/M3/M4)推荐 16GB 统一内存起步,Windows/Linux 推荐 8GB 显存以上 NVIDIA 显卡。你也可以根据场景只启用其中几个引擎——比如只用 LuxTTS 做听写,用 Kokoro 做 TTS,整体资源占用能压到很低。
如果你也在做类似的内容工具链,Voicebox 的"多引擎可切换"架构很值得借鉴:同一功能暴露多个实现给用户选择,让用户根据场景自主权衡速度 / 质量 / 资源占用。这种设计在 AI 产品里越来越常见——比如向量检索有 FAISS / Qdrant / Milvus,代码生成有 GPT / Claude / 本地 QwenCoder,给用户选择权是本地工具区别于云服务的关键差异化。
七、可借鉴之处:Voicebox 给 AI 工具设计的启发
Voicebox 不是没有缺点(多引擎架构带来的资源消耗、macOS-only 的全局听写、对 Apple Silicon 的强依赖),但它在架构设计上有几个值得学习的点:
- MCP 协议设计:Agent 语音输出通过 MCP 协议实现(一种让 AI Agent 调用外部工具的标准协议),解耦良好。Voicebox 暴露一个 MCP server,让任何支持 MCP 的 AI 编程工具(Claude Code、Cursor、Cline 等)都能调用语音能力。如果你想给 Agent 增加新能力,参考它的 MCP server 设计是个不错的起点。
- 多引擎可切换架构:同一功能多个引擎可选,用户体验好。知识库检索、代码生成等场景都可以参考这种"换着用"的设计——给用户多一种选择,往往比"做最好的"更重要。
- 本地优先理念:模型和数据不离开本地,隐私保护是底线。这对做 ToB 工具(医疗、法律、企业内部)尤其重要。
- Captures 存档设计:每次交互自动存档配对(音频 + 转录),方便回溯。AI Agent 的对话历史、命令历史都可以借鉴这种"多模态存档"思路。
落地步骤:如果你想快速体验,最短路径是 macOS Apple Silicon 用户——下载 DMG 安装,第一次启动会按需下载 TTS 模型(可选引擎),就能直接用全局听写 + 多引擎 TTS。其他平台用户建议先用 Docker 跑通基础流程,再考虑源码定制。
结语:开源工具的"组合替代"哲学
Voicebox 给所有想自己搭建 AI 工作台的创业者 / 运营人一个清晰的信号:云端付费工具不是唯一选择。当一个细分场景的需求足够明确(语音输入 + 输出 + Agent 联动),开源社区完全有能力做出"组合替代"——而且数据归你、费用为零、可商用。
当然,开源不等于完美。Voicebox 在生产稳定性、生态丰富度、企业级 SLA 上仍远不及 ElevenLabs 这种成熟云服务。工具选择没有银弹,关键是匹配你的场景:个人创作 / 隐私敏感 / 成本敏感 → 优先考虑 Voicebox;商业生产 / 高并发 / 多语言精品配音 → ElevenLabs 仍是更稳妥的选择。
GitHub Trending 每天都在刷新,但能解决真问题、有清晰差异化(多引擎 + MCP + 本地)、又尊重用户隐私(MIT + 完全本地)的项目,值得多看一眼。Voicebox 是不是下一个 ElevenLabs 杀手?不是,但它是 ElevenLabs 第一个真正可用的开源对手。