
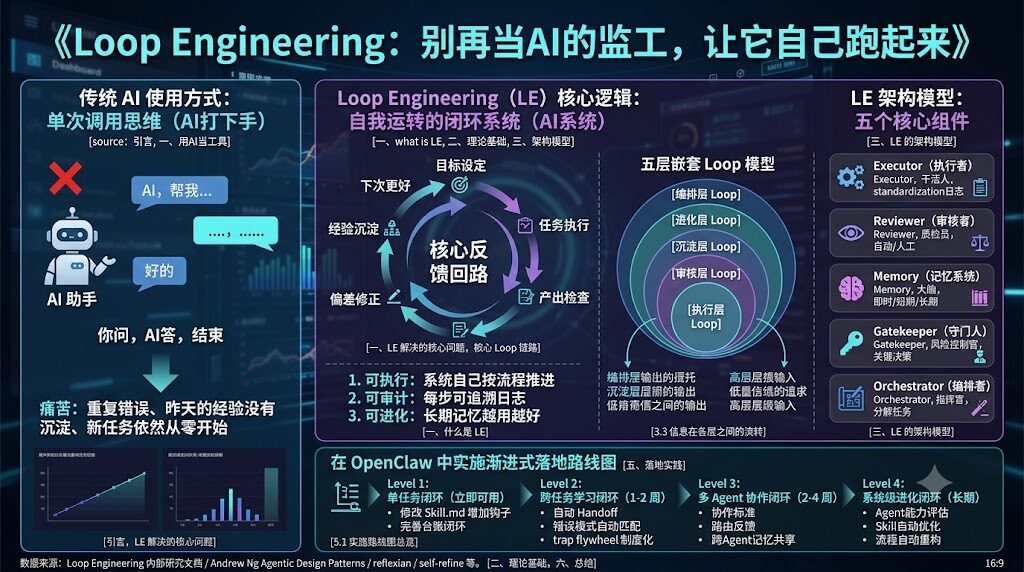
Loop Engineering(LE)是一套把 AI 工作流从"单次问答"升级为"自我驱动、自我检查、自我进化"闭环系统的工程方法。它融合了控制论的反馈回路、PDCA 的质量循环、OODA 的快速响应、Reflexion 的自我反思等经典思想,落到 OpenClaw 上分为"单任务闭环 → 跨任务学习 → 多 Agent 协作 → 系统级进化"四级渐进方案。
如果你用过 AI Agent,大概率经历过这种场景:让它"分析竞品",它确实跑了一遍——抓数据、生成报告、发到飞书群。但你第二天再问类似的问题时,它好像完全没从昨天的工作中学到什么。错误模式会重复犯,昨天的经验没有沉淀,新任务依然从零开始。
这背后的根本原因是:大多数 AI 使用方式还停留在"单次调用"思维——你问,AI 答,结束。Loop Engineering 想做的事情是把这套"问-答"模式改造成"能自我运转的闭环系统"。它不是新工具,也不是新框架,而是一种工程方法论——告诉你怎么把 AI 用成"系统"而不是"工具"。
本文涵盖控制论 / PDCA / OODA / Reflexion 理论渊源、五层 Loop 架构模型、OpenClaw 现状 Gap 分析、四级渐进落地路线图,把 Loop Engineering 从概念到落地一次讲透。
一、什么是 Loop Engineering:把"用 AI"升级为"建 AI 系统"
当我们谈论"用 AI 提效"时,大多数人想到的是:让 AI 写一篇文章、生成一段代码、回答一个问题。这是一种单次调用的思维——你问,AI 答,结束。
但真正复杂的业务场景远不止于此。一个电商运营团队每天要做的事包括:抓取竞品数据、分析销售趋势、生成运营报告、发布到多个渠道、监测效果、调整策略……这需要几十个步骤,跨越多个工具和平台,涉及多个人(和 AI)的协作。
如果你每个步骤都要人去盯——"AI,帮我抓一下数据"、"AI,把数据整理成表格"、"AI,分析一下趋势"——那 AI 只是在帮你打下手,本质上还是你在推动整个流程。
Loop Engineering(LE)的核心思想:把这条链路设计成一个能够自我驱动、自我检查、自我进化的闭环系统。它不只是"自动化",而是让系统具备了三项关键能力:
- 可执行:系统能自己按流程推进,不需要人在每个节点下达指令
- 可审计:每一步都有记录,出问题能追溯到具体环节
- 可进化:好的经验被沉淀,错误被挡住,系统越用越好
核心 Loop 链路
LE 的核心是一条完整的反馈回路:
目标设定 → 任务执行 → 产出检查 → 质量反馈 → 偏差修正 → 经验沉淀 → 下次更好这条链路的关键在于:每一步的输出都是下一步的输入,整个链路形成闭合循环。它不是线性的"做完就结束",而是螺旋上升的"每次都比上次更好"。
用一个具体例子说明。假设你要做一个"每日竞品分析"任务:
传统做法:每天早上你打开电脑 → 让 AI 抓数据 → 人工检查数据质量 → 让 AI 生成报告 → 你审核 → 手动发到飞书群 → 第二天重复(但昨天的错误还是会犯,因为没人记录)。
LE 做法:
- 目标层:系统自动分解为"抓数据→分析→生成报告→分发"四个子任务
- 执行层:每个子任务自动执行,并在完成后自我检查
- 审核层:关键节点(如报告发布前)自动审核或推送人工确认
- 沉淀层:每次成功 / 失败的经验自动记录到长期记忆
- 进化层:重复出现的错误模式被自动识别并生成防护规则
LE 解决的核心问题
LE 不是凭空创造出来的概念,它回应的是 AI 应用落地中真实存在的七个痛点:
| 痛点 | 表现 | LE 如何解决 |
|---|---|---|
| 做过的事没有记录 | 上个月做的分析找不到了 | 每步执行自动写入日志 |
| 错在哪里没人复盘 | 同一个 bug 犯了三次 | 自动记录错误,模式识别,生成规则 |
| 经验没有沉淀 | 新人(新 AI)从零开始 | 长期记忆系统,经验跨任务复用 |
| 每次都像第一次做 | 没有标准流程 | 流程模板化,参数化执行 |
| 人要反复盯着流程 | 你在中间当"人肉胶水" | 编排层自动串联各环节 |
| 多 AI 协作混乱 | A 做的事 B 不知道,产出冲突 | 统一通信协议,任务台账 |
| 出问题后不知哪步出错 | 只能从头排查 | 每步可追溯,审计日志完整 |
二、理论基础:LE 是多个经典方法的融合
LE 并非一个全新的概念,它是多个经典方法论在 AI Agent 时代的融合与升级。理解这些理论渊源,有助于我们把握 LE 的本质。
2.1 控制论:反馈回路
1948 年,Norbert Wiener 在《控制论》(Cybernetics: Or Control and Communication in the Animal and the Machine)中提出了一个革命性的思想:系统通过反馈来调节自身行为。一个恒温器之所以能保持室温恒定,不是因为它"知道"理想温度,而是因为它不断地测量当前温度、与目标比较、调整输出。
这个思想是 Loop Engineering 最底层的哲学基础。在 LE 中,每一个"执行→检查→修正"的循环,本质上就是一个控制论意义上的反馈回路。区别在于,LE 的反馈回路不仅调节当前行为,还学习和进化——它不仅知道"偏差了",还知道"为什么偏差"和"如何防止再次偏差"。
2.2 PDCA 循环:质量管理的 DNA
W. Edwards Deming 和 Walter Shewhart 发展的 PDCA 循环(Plan-Do-Check-Act)是现代质量管理的基石。它的核心思想是:
- Plan(计划):设定目标和达成方法
- Do(执行):按计划实施
- Check(检查):评估结果与目标的差距
- Act(处理):根据差距调整,标准化成功经验,将未解决问题带入下一个循环
PDCA 教会我们:质量的提升不在于一次做对,而在于持续迭代。LE 完全继承了这一思想,并将 PDCA 扩展为多层嵌套循环——不仅整个系统有 PDCA,每个子任务层、审核层、沉淀层也都有自己的小循环。
2.3 OODA 循环:在不确定性中决策
军事战略家 John Boyd 提出的 OODA 循环(Observe-Orient-Decide-Act)为 LE 提供了速度和适应性的维度:
- Observe(观察):感知环境变化
- Orient(定位):理解变化对自己的意义
- Decide(决策):选择应对方案
- Act(行动):执行并回到观察
Boyd 的核心洞察是:谁能更快地完成 OODA 循环,谁就能主导战场。在 AI Agent 场景中,这个道理同样适用——系统对异常的反应速度、对环境变化的适应能力,决定了它能在多大程度上替代人工监控。
LE 吸收了 OODA 的"速度优先"思想:不仅要做闭环,还要快速闭环。self-healing skill 的设计理念正是如此——发现故障后立即诊断、打补丁、验证,而不是等到人工介入。
2.4 AI 领域的自我反思机制
近年来,AI 研究社区独立地发展出了多种"反思-改进"机制,这些工作从算法层面验证了 Loop Engineering 的可行性:
Reflexion(Shinn et al., 2023):提出让 LLM 在执行任务后回顾自己的输出,识别错误并生成改进建议。实验表明,这种"自我反思"能显著提升代码生成和决策任务的准确率。
Self-Refine(Madaan et al., 2023):不需要外部反馈,模型自己对自己的输出进行迭代改进——生成→自我批评→修正→再生成。这证明反思能力内置于模型中,LE 的任务是把它制度化。
RLHF(Reinforcement Learning from Human Feedback):通过人类反馈信号训练模型,本质是外部反馈回路的工程化实现。RLHF 的成功证明了将人类判断纳入训练循环的巨大价值——这正是 LE 中"审核层 Loop"的理论支撑。
2.5 复合 AI 系统:从单体模型到系统架构
UC Berkeley 的 Matei Zaharia 团队在《The Shift from Models to Compound AI Systems》(2024)中指出:AI 的未来不在于单体模型的持续增大,而在于将多个模型、工具、检索系统组合成协同工作的复合系统。
这一观点与 LE 高度共鸣:
- 单体模型 = 一个聪明的员工,能回答问题,但不能独立完成复杂任务
- 复合 AI 系统 = 一个有组织的团队,有分工、有流程、有质量管控
- Loop Engineering = 这个团队的工作制度,确保协作有序、质量可控、经验传承
2.6 Andrew Ng 的 Agentic Design Patterns
Andrew Ng 在 2024 年的演讲中提出了四种 Agentic Design Patterns,为 LE 提供了设计范式:
- Reflection(反思):Agent 审视自己的输出并改进 → LE 的执行层 Loop
- Tool Use(工具使用):Agent 调用外部工具完成任务 → LE 的执行能力基础
- Planning(规划):Agent 将复杂目标分解为子任务 → LE 的编排层 Loop
- Multi-agent Collaboration(多智能体协作):多个 Agent 分工合作 → LE 的跨 Agent 协作闭环
Ng 的四个模式精确对应了 LE 的不同层次,而 LE 的价值在于:它把这四种模式从"设计建议"升级为"工程方法"——不仅告诉你要做反思,还告诉你怎么制度化地做反思;不仅告诉你要多 Agent 协作,还告诉你怎么确保协作持续改进。
2.7 LE 作为这些思想的融合与升华
Loop Engineering 不是要对以上任何一个理论说"我更好",而是要做一件这些理论各自做不到的事:将它们编织成一个完整的、可工程化的系统框架。
| 理论来源 | 给 LE 带来了什么 | LE 做了什么升华 |
|---|---|---|
| 控制论 | 反馈回路的基本概念 | 从单回路到多层嵌套 |
| PDCA | 质量持续改进的方法论 | 从人工驱动到系统自驱动 |
| OODA | 快速响应的战略思维 | 从战场决策到日常运维 |
| Reflexion / Self-Refine | AI 自我反思的算法证明 | 从单次反思到制度化反思 |
| RLHF | 人类反馈的训练价值 | 从训练环节到运行环节 |
| Compound AI Systems | 系统架构优于单体模型 | 补充了"进化机制" |
| Agentic Patterns | Agent 设计范式 | 从设计模式到工程方法 |
LE 的本质一句话:给 AI 一条清晰的轨道——每个节点要知道现在做什么、输入是什么、输出什么、谁检查、出错了怎么办、什么可以沉淀、什么必须等人确认。
三、Loop Engineering 的架构模型
3.1 五个核心组件
一个完整的 LE 系统由五个核心组件构成,它们各司其职,通过标准化的信息流协同工作:
Executor(执行者):执行者是"干活的人",负责按照指令完成具体任务。在 OpenClaw 中,执行者可以是主 Agent 直接执行,也可以是通过 sessions_spawn 创建的子代理。
关键能力:
- 接收结构化任务描述(目标、输入、预期输出、超时、重试策略)
- 执行完成后进行自我检查(第一层质量保障)
- 将执行过程和结果写入标准化日志
Reviewer(审核者):审核者是"质检员",负责评估执行者的产出是否符合预期。审核可以是自动的(规则检查、格式验证),也可以是人工的(推送关键决策给人类确认)。
关键能力:
- 定义审核标准(格式、内容完整性、数据一致性)
- 轻量审核自动通过,关键决策推送人工
- 审核结论写入反馈记录
Memory(记忆系统):记忆系统是"组织的大脑",负责存储和管理系统运行中产生的所有知识。它分为三个层级:
| 层级 | 存储内容 | 生命周期 | 查询方式 |
|---|---|---|---|
| 即时记忆 | 当前任务上下文 | 单次任务 | 直接读取 |
| 短期记忆 | 近期日志、经验 | 数天到数周 | 语义搜索 |
| 长期记忆 | 规则、知识、模式 | 永久 | 结构化检索 |
在 OpenClaw 中:即时记忆 = 会话上下文 + memory/YYYY-MM-DD.md;短期记忆 = memory_search + GBrain 语义搜索;长期记忆 = MEMORY.md + Skills 定义。
Gatekeeper(守门人):守门人是"风险控制官",负责在关键节点设置检查点。它的核心职责不是替人做决策,而是标记出哪些决策必须等人来做。
关键规则:
- 生产环境变更 → 必须人工确认
- 内容对外发布 → 必须人工审核
- 系统级配置修改 → 必须人工批准
- 数据删除操作 → 必须双重确认
守门人不是阻碍自动化,而是让自动化在安全的边界内运行。
Orchestrator(编排者):编排者是"指挥官",负责将复杂目标拆解为子任务、分配给合适的执行者、汇总结果。它是整个 LE 系统的大脑皮层。
关键能力:
- 目标分解:将"做一份竞品分析"拆解为 10+ 个子任务
- 资源分配:根据任务类型选择合适的 Agent
- 依赖管理:确保任务按正确顺序执行
- 结果汇总:将多个子任务的产出合成为最终报告
3.2 五层 Loop 模型
LE 系统的灵魂在于它的五层嵌套循环。每一层都是一个独立运行的反馈回路,但它们又不是孤立的——低层的产出是高层的输入,高层的指令是低层的约束。
            ┌──────────────────────────────────────┐
            │          Layer 5: 编排层 Loop         │
            │    目标拆解 → 分配 → 汇总 → 调整      │
            │    ┌────────────────────────────┐     │
            │    │   Layer 4: 进化层 Loop      │     │
            │    │ 错误模式 → 根因 → 规则更新   │     │
            │    │  ┌──────────────────────┐   │     │
            │    │  │ Layer 3: 沉淀层 Loop │   │     │
            │    │  │ 经验 → 筛选 → 入库   │   │     │
            │    │  │ ┌────────────────┐  │   │     │
            │    │  │ │Layer 2: 审核层  │  │   │     │
            │    │  │ │ 产出→检查→反馈  │  │   │     │
            │    │  │ │ ┌────────────┐ │  │   │     │
            │    │  │ │ │Layer 1:    │ │  │   │     │
            │    │  │ │ │执行层 Loop │ │  │   │     │
            │    │  │ │ │执行→自检→  │ │  │   │     │
            │    │  │ │ │修正         │ │  │   │     │
            │    │  │ │ └────────────┘ │  │   │     │
            │    │  │ └────────────────┘  │   │     │
            │    │  └──────────────────────┘   │     │
            │    └────────────────────────────┘     │
            └──────────────────────────────────────┘
让我们从内向外,逐层剖析。
Layer 1:执行层 Loop(任务执行-自我检查-修正)。这是最内层、最频繁运转的循环。每一个子任务执行时都在运转。
- 触发条件:每次任务执行
- 持续时间:秒到分钟级
- 产出物:执行日志、初步验证结果、修正记录
循环流程:
接收任务指令 → 解析参数 → 执行操作
    ↓                            ↑
写入执行日志                   修正重试
    ↓                            ↑
自我检查(格式/完整性)  →  发现问题?→是→ 自动修正
    ↓                            ↓否
标记完成 → 将结果提交审核层
示例:GitHub 每日分析任务中,"抓取 Trending 数据"这个子任务:
- 调用
web_fetch获取 GitHub Trending 页面 - 自我检查:返回内容是否包含项目列表?数据是否完整(名称、描述、星标数)?
- 如发现数据为空 → 重试一次 → 仍失败则标记为"需要人工介入"
- 如数据正常 → 写入执行日志 → 提交给审核层
Layer 2:审核层 Loop(产出-审核-反馈)。审核层负责在每一批产出完成后进行质量把关。它不一定每次都触发人工审核,但保证每个产出都有"谁审的、审了什么、结论是什么"的记录。
- 触发条件:执行层产出提交 / 关键里程碑节点
- 持续时间:分钟到小时级(如有等待人工审核)
- 产出物:审核记录、反馈意见、通过 / 驳回标记
循环流程:
接收执行层产出
    ↓
自动审核(规则检查)
    ↓
  通过?→是→ 标记审核通过
    ↓否
  需要人工决策?→否→ 自动驳回+反馈修改
    ↓是
  推送人工审核 → 等待人工反馈
    ↓
  收到反馈 → 记录审核结论
    ↓
  是否需要修改?→是→ 反馈到执行层重做
    ↓否
  标记审核通过 → 产出进入沉淀层
示例:GitHub 分析报告生成后:
- 自动审核:报告是否包含所有必需章节?图表是否正确?数据是否有明显矛盾?
- 轻量问题(如格式不规范)→ 自动标注,通知执行者修正
- 关键决策(如发布到公开博客)→ 推送段总确认
- 审核通过 → 报告进入分发流程
Layer 3:沉淀层 Loop(经验-筛选-入库)。这是 LE 区别于普通自动化的关键层。大多数自动化系统做完就完了,LE 要求从每一次执行中提取可复用的经验。
- 触发条件:每个任务完成后 / 发现新的经验模式
- 持续时间:分钟级(自动)+ 持续积累
- 产出物:经验条目、更新后的记忆文件
循环流程:
接收已完成任务的完整上下文
    ↓
自动提取关键信息:
  - 任务类型、耗时、成功率
  - 遇到的问题及解决方案
  - 新发现的最佳实践
    ↓
按 L0/L1/L2 分层组织信息
    ↓
判断经验等级:
  - 单次有效 → 写入日志 memory/YYYY-MM-DD.md
  - 模式级 → 写入 .learnings/ 目录
  - 团队级 → 晋升到 MEMORY.md / Skills
    ↓
更新知识库索引
在 OpenClaw 中,这一层的实现非常具体。以 self-improving agent 的运作方式为例:
任务完成 → 自动提取关键经验
    ↓
按场景分类:
  - 用户纠正 → LEARNINGS.md (category: correction)
  - 发现最佳实践 → LEARNINGS.md (category: best_practice)
  - 命令失败 → ERRORS.md(含完整错误上下文)
  - 新功能需求 → FEATURE_REQUESTS.md
    ↓
重复模式检测(grep .learnings/ 搜索相似条目)
    ↓
满足晋升条件(跨任务适用 / 能防重复错误)
    ↓
晋升到 SOUL.md / AGENTS.md / TOOLS.md
Layer 4:进化层 Loop(错误模式-根因分析-规则更新)。进化层是沉淀层的"升级版"。沉淀层负责记录,进化层负责系统性地改进——它不只是说"这里犯了个错",而是说"这个类型的错误以后不会再犯了"。
- 触发条件:重复错误出现 / 每周复盘 / 系统升级
- 持续时间:分钟到小时级
- 产出物:新规则、Skill 更新、陷阱条目、行为变更
循环流程:
扫描 .learnings/ 中的错误模式
    ↓
识别重复模式(Recurrence-Count ≥ 2)
    ↓
根因分析:为什么反复出现?
  - 缺少规则约束?
  - 流程设计缺陷?
  - 工具能力不足?
    ↓
生成改进方案:
  - 更新 Skill:添加已知陷阱
  - 更新规则:添加红线约束
  - 更新流程:增加检查点
    ↓
部署改进 → 监控效果 → 进入下一个进化循环
最典型的例子——OpenClaw 的陷阱飞轮机制:
Agent犯错
    ↓
判断:这个错误在某个Skill的覆盖范围内?
    ↓是
写入该Skill的"已知陷阱"章节:
  - 现象:Agent犯了什么错
  - 原因:为什么会犯错
  - 正确做法:应该怎么做
  - 验证:怎么确认不会重犯
    ↓
通知用户已更新
    ↓
下次该Skill被加载时,Agent会看到陷阱条目
    ↓
同类错误不再重犯
Layer 5:编排层 Loop(目标拆解-任务分配-结果汇总)。这是最外层的"大循环",负责整个任务的端到端协调。编排层不关心具体怎么做,它关心的是"做完了吗、做对了吗、需要调整吗"。
- 触发条件:接收新任务 / 子任务出现异常 / 外部条件变化
- 持续时间:贯穿整个任务生命周期
- 产出物:任务执行报告、任务状态更新、资源调整记录
循环流程:
接收顶层目标
    ↓
目标分解:
  "做一份竞品分析" →
  [抓数据, 清洗, 分析趋势, 生成报告, 审核, 分发]
    ↓
评估资源:
  - 哪些可以并行执行?
  - 哪些有依赖关系?
  - 需要什么 Skill/Agent?
    ↓
创建子任务 + 分配执行者
    ↓
监控执行进度:
  - 每15分钟收集一次状态
  - 异常立即上报
    ↓
收集子任务产出 → 拼装最终结果
    ↓
质量检查(整份产出)
    ↓
分发 → 关闭任务 → 触发沉淀层回顾
3.3 信息在各层之间的流转
理解 LE 系统的关键在于理解信息如何在五层之间流转:
顶层目标                    [编排层]
    ↓ 分解为子任务
具体执行指令                [执行层]
    ↓ 执行+自检
初步产出                    [审核层]
    ↓ 审核+反馈
通过审核的产出              [沉淀层]
    ↓ 提取+组织
结构化经验                  [进化层]
    ↓ 分析+提炼
规则和流程改进 [编排层] → 影响下一次编排这个流转形成了一个完整的信息闭环:执行的经验回流到编排层,改进下一次的任务分解和分配。这就是 LE 说的"每次都比上次好"。
关键设计原则:
- 信息不外泄:每一层只处理自己层级的信息,不过度消费下层细节
- 向上聚合:从具体(执行记录)到抽象(规则改进),信息逐层提炼
- 向下约束:从宽泛(目标)到精确(执行指令),指令逐层具体化
- 横向上报:任何一层发现异常,不仅要自己处理,还要上报到上层做系统性改进
四、Loop Engineering 对 OpenClaw 的价值分析
4.1 OpenClaw 已有的 LE 基因
当我们用 LE 的视角审视 OpenClaw 时,会发现一个惊人的事实:OpenClaw 已经拥有了 LE 所需的大部分基础设施。这不是巧合——OpenClaw 的设计哲学天然倾向于"让 Agent 能自己运行和改进"。
Skills 系统:可进化的能力单元。OpenClaw 的 Skills 系统是 LE 思想最直接的体现。每个 Skill 不仅是"一个功能模块",更是一个自带进化机制的知识包。
self-improving skill:这是 OpenClaw 中 LE 基因最明显的组件。它实现了完整的沉淀层 Loop:
- 错误发生后自动记录到
.learnings/ERRORS.md - 用户纠正自动记录到
LEARNINGS.md(category: correction) - 发现最佳实践自动记录(category: best_practice)
- 重复模式自动检测(通过 See Also 链接关联)
- 跨任务适用的学习自动晋升到 SOUL.md / AGENTS.md / TOOLS.md
self-healing skill:实现了执行层的进阶版——故障自愈循环:
- 发现故障 → 诊断根因 → 打补丁 → 验证 → 记录到 HEALS.md
- 与其他自动化工具的关键区别:必须验证(不是"我觉得修好了",而是"重新跑一遍通过了")
- 复发检测:Pattern-Key 相同的修复自动增加 Recurrence-Count
- 连续 3 次复发 → 生成 Handoff 块触发永久记忆晋升
陷阱飞轮(Trap Flywheel):这是进化层 Loop 的具体实现:
- Agent 犯错 → 判断是否在 Skill 覆盖范围 → 写入该 Skill 的"已知陷阱"章节
- 每个陷阱条目包含:现象、原因、正确做法、验证方法
- HEARTBEAT.md 有每日陷阱飞轮检查项
记忆系统:分层持久化知识库。OpenClaw 的记忆系统天然支持 LE 中 Memory 组件的三层架构:
| LE 层级 | OpenClaw 实现 | 内容 |
|---|---|---|
| 即时记忆 | memory/YYYY-MM-DD.md + 会话上下文 |
当天工作日志、当前任务状态 |
| 短期记忆 | memory_search + GBrain 语义搜索 |
近期决策、经验、知识链接 |
| 长期记忆 | MEMORY.md + Skills 定义 |
长期约定、技术沉淀、团队知识 |
特别值得一提的是L0/L1/L2 分层沉淀规范,它与 LE 中沉淀层 Loop 的设计理念高度一致:
- L0 = 一句话结论(≤50 字),必须项
- L1 = 核心要点(1-3 条)
- L2 = 完整上下文 + 来源 + 时间戳
这套分层方式解决了知识沉淀中最常见的问题:要么记得太粗略(事后看不懂),要么记得太详细(根本懒得记)。
Cron 定时任务体系:自动化执行的骨架。OpenClaw 的 Cron 系统提供了 LE 中 Executor 组件的调度能力:
- 支持 cron 表达式定时触发
- 支持 isolated session(每次执行全新上下文,避免历史污染)
openclaw cron add/list/run完整的生命周期管理- failureAlert 机制覆盖进程级故障
虽然目前 Cron 的监控主要覆盖"进程是否崩溃"(LE 三层验证中的第一层),但这个骨架已经搭建好了,补上后两层(产出级+送达级)正是 LE 要做的事。
Sub-agent 编排机制:多 Agent 协作基础。OpenClaw 的 Sub-agent 系统为 LE 的编排层提供了基础设施:
sessions_spawn:创建子代理执行特定任务sessions_send:向其他 Agent 发送消息 / 任务sessions_yield:等待子代理完成router skill:自动识别任务类型并路由到对应 Skill
这些机制使得"一个主 Agent 分解任务→分配给多个子 Agent→汇总结果"的编排成为可能。
4.2 LE 视角下的 Gap 分析
尽管 OpenClaw 已经拥有大量 LE 基础设施,但从"有组件"到"组件协同形成完整闭环",仍存在关键的缺口:
| 环节 | 当前状态 | 缺失 |
|---|---|---|
| 执行→自我检查 | ⚠️ 部分存在 | self-healing 有诊断-验证,但不是每个 Skill 都内建自检 |
| 检查→反馈→修正 | ⚠️ 部分存在 | 反馈集中于错误场景,缺少"做对了也要总结"的正向反馈 |
| 审核→人工确认 | ❌ 弱 | 守门人机制不完整,关键决策的分级推送未制度化 |
| 经验→筛选→入库 | ⚠️ 存在但不完整 | self-improving 有记录,但筛选标准、入库时机依赖 Agent 判断 |
| 错误模式→根因→规则更新 | ⚠️ 部分存在 | 陷阱飞轮是手动触发,缺少自动模式识别 |
| 编排→分配→汇总 | ⚠️ 部分存在 | taskflow + sub-agent 有基础,但缺少质量评估和动态调整 |
经验沉淀链路的断裂点。目前 OpenClaw 的经验沉淀链路存在几个断裂点:
- 临时经验到永久规则的晋升是手动且低频的。self-improving 虽然定义了晋升条件(跨任务适用、防重复错误),但实际晋升动作依赖于 Agent 在特定时刻的判断,而不是系统级的自动触发。
- 正向经验的沉淀弱于错误经验的记录。
.learnings/ERRORS.md是强制的,但"这件事做得很好,以后应该保持"这类正向经验往往被忽略。 - 跨 Agent 经验共享缺位。self-improving 的记录写入的是调用者 Agent 的
.learnings/目录,不同 Agent 之间不共享学习记录。如果 Agent A 发现了一个最佳实践,Agent B 无法自动受益。
检查-反馈-修正的自动化程度。当前的自动化程度存在明显的层次差异:
- L1(执行层自检):self-healing 是最成熟的,有完整的诊断→打补丁→验证→记录循环
- L2(审核层反馈):几乎空白。产出是否合格、"向谁确认"的判断严重依赖 Agent 的经验
- L3(沉淀层筛选):有框架但执行不完整。Agent 可以判断"要不要记录",但缺乏系统级的自动筛选标准
多 Agent 协作的闭环。目前的多 Agent 协作更像消息传递,而非协作闭环:
- Agent A 通过
sessions_send给 Agent B 发任务 → B 执行 → 但 A 不一定会检查 B 的产出质量 - 如果 B 做错了,A 可能不会知道
- 没有"协作质量评估→反馈→B 改进"的循环
4.3 引入 LE 后能获得的提升
引入完整的 LE 框架后,OpenClaw 将经历三个质的飞跃:
从"半自动化"到"全自动闭环"。当前你告诉 Agent 做什么,Agent 做,做完告诉你结果。中间你可能需要追问"做完了吗?"、"做得对吗?"。LE 后 Agent 不仅执行,还自我检查、记录日志、更新记忆。你只需要在关键节点做决策。系统自己知道"该做什么、做完了吗、做得对吗、下次怎么做得更好"。
具体来说:
- Cron 任务不再只报"跑完了",而是报"跑完了,产出文件 XX,已验证完整,已送达"
- 子代理任务不再只返回结果,而是返回"结果 + 自检报告 + 置信度评估"
- 记忆更新不再依赖 Agent "想起来",而是任务完成后系统自动触发沉淀
从"单次任务"到"持续进化系统"。当前每个任务都是独立的一次性执行。第二次做同一类型任务时,Agent 的上下文是全新的(isolated session),不会从上次执行中获益。LE 后每次执行都是系统进化的一步。错误模式被自动识别并转化为规则,成功经验被提取为模板。系统在真正变聪明——不是模型变聪明了,而是系统通过经验积累变得更强。
具体来说:
- 同样的 GitHub 分析任务,第 100 次执行比第 1 次执行更稳定、更准确、更快
- 不是因为 Agent 变得更聪明,而是因为 Skills 中的陷阱条目变多了、规则变完善了、模板变精确了
- 新人(新 AI)加入系统,不是从零开始,而是继承了所有历史经验
从"人工盯流程"到"只做关键裁决"。当前你在中间当"人肉胶水",串联各个 Agent 和工具。LE 后你是"关键决策者"。编排层自动推进流程,审核层自动过滤 90% 的问题,只有真正需要人类判断的 10% 才会推送到你面前。
这意味着人的精力从"盯着流程别出错"释放到"做只有人能做的判断"——判断战略方向、确认关键产出、设定新的目标。
五、OpenClaw 环境中的 Loop Engineering 落地实践
以下方案完全基于 OpenClaw 现有的功能和基础设施,不虚构任何新功能。每一个 Level 都是在现有能力上的增量改造,而非推倒重来。
Level 1:单任务闭环(立即可用)
目标:让每个任务从"执行→结束"变成"执行→自检→沉淀→更新台账"
适用场景:所有通过 OpenClaw 执行的单次任务
改造方案:
当前流程(以 GitHub 每日分析为例):
Cron触发 → Agent执行分析 → 生成报告 → 发送给用户
问题:执行完就结束,不做自检,不沉淀经验,不更新记忆
LE 改造后:
Cron触发 → Agent执行分析 → 自我检查(数据完整性、格式正确性)
    ↓
写入执行日志(memory/YYYY-MM-DD.md)
    ↓
生成报告 → 发送前自动审核(关键节点推送人工确认)
    ↓
发送 → 验证送达(确认messageId)
    ↓
触发沉淀:提取本次经验 → 写入 .learnings/ + 更新 MEMORY.md
    ↓
闭环:任务状态从"进行中"移出,写入闭环记录利用的现有基础设施:
| 环节 | 使用的 OpenClaw 能力 |
|---|---|
| 自我检查 | self-healing 的验证机制(验证产出文件存在且非空) |
| 执行日志 | memory/YYYY-MM-DD.md 自动写入 |
| 关键审核 | 守门人逻辑:feishu_ask_user_question 推送决策 |
| 沉淀 | self-improving 自动记录到 .learnings/ |
| 台账更新 | MEMORY.md「进行中的任务」区块更新 |
需要新增的部分:
- 任务模板标准化:为常见任务创建标准模板,明确每个步骤的检查点和沉淀要求
- 执行后钩子(Execution Post-hook):在 Skill 定义中增加"完成后必须执行的步骤"章节——自检、沉淀、闭环
具体实施示例:GitHub 每日分析的完整 Loop 改造。改造点在 github-daily-analysis/SKILL.md 中增加:
## Step N: Loop 闭环(每次执行必须)

### N.1 执行后自我检查
- [ ] 数据源是否完整(Top 10项目全部获取)
- [ ] 分析报告是否包含所有必需章节
- [ ] 产出文件是否存在且非空(Word文档 > 1KB)

### N.2 执行日志写入
- [ ] 写入 memory/YYYY-MM-DD.md:
  - 执行时间、耗时
  - 数据质量(如"3个项目描述缺失")
  - 异常情况(如"web_fetch第2次重试才成功")

### N.3 沉淀触发
- [ ] 有无新发现 → self-improving 记录
- [ ] 有无错误 → ERRORS.md
- [ ] 有无可复用经验 → LEARNINGS.md

### N.4 台账闭环
- [ ] 更新 MEMORY.md「进行中的任务」:标记完成
- [ ] 更新 index.md:新分析项目已记录
优先级和 ROI:
- 优先级:⭐⭐⭐⭐⭐ 最高
- 实施成本:< 1 天(主要是修改现有 SKILL.md 和 HEARTBEAT.md)
- ROI:立即见效——每个任务的质量和可追溯性显著提升
Level 2:跨任务学习闭环(1-2 周实施)
目标:让系统从多个任务的执行中自动识别模式、积累经验、进化规则
核心机制一:错误模式自动识别。当前 .learnings/ 中的错误记录是"人触发"的——Agent 发现错误后手动记录。Level 2 要升级为"系统自动识别":
每次任务执行 → 自动提取异常信号
    ↓
与 .learnings/ 中的历史模式匹配
    ↓
发现重复模式?
    ↓是
自动增加 Recurrence-Count
    ↓
Recurrence-Count ≥ 3?
    ↓是
自动生成 Handoff 块
    ↓
触发 self-improvement 晋升流程
    ↓
更新到 MEMORY.md / AGENTS.md / 对应Skill的陷阱章节核心机制二:陷阱飞轮制度化。当前陷阱飞轮依赖 Agent 在犯错后的"主动记录"。Level 2 要让它成为自动触发机制:
执行层自检发现错误 → 自动判断
    ↓
错误类型在某个Skill覆盖范围?
    ↓是
自动生成陷阱条目草稿
    ↓
Agent确认/修正后自动写入对应Skill
    ↓
通知用户陷阱已更新核心机制三:正向经验提取。除错误外,系统还要学会总结"做对了什么":
任务执行完成后 → 自动对比与历史同类任务的表现
    ↓
本次效率更高/质量更好?
    ↓是
提取关键差异 → 生成最佳实践条目
    ↓
写入 LEARNINGS.md (category: best_practice)利用的现有基础设施:
| 机制 | 使用的 OpenClaw 能力 |
|---|---|
| 错误模式匹配 | self-healing 的 Pattern-Key 机制 |
| 复发计数 | HEALS.md 的 Recurrence-Count 升级逻辑 |
| Handoff 晋升 | self-healing → self-improvement 联动 |
| 陷阱飞轮 | Skills 的"已知陷阱"章节模板 |
| 正向经验 | self-improving 的 best_practice 分类 |
需要新增的部分:
- 跨任务对比脚本:一个能在任务结束后自动运行的小脚本,比较本次执行与历史同类任务的指标
- 自动化 Handoff 触发器:当 Recurrence-Count ≥ 3 时不再依赖 Agent 判断,而是系统级触发
- 每周自动复盘:在 HEARTBEAT.md 的每周小复盘基础上,增加自动模式分析(不依赖 Agent 记得执行)
优先级和 ROI:
- 优先级:⭐⭐⭐⭐ 高
- 实施成本:1-2 周
- ROI:中长期回报巨大——错误重复率预计下降 60%+,系统稳定性持续提升
Level 3:多 Agent 协作闭环(2-4 周实施)
目标:让多个 Agent 之间的协作形成完整的"分配→执行→审核→反馈→改进"闭环
当前协作模式的问题:
Agent A (sessions_send/ sessions_spawn) → Agent B 执行任务 → B返回结果 → A接受
问题:A不检查B的产出质量,B不知道自己的产出是否被采纳
LE 改造后的协作闭环:
主Agent创建子任务
    ↓
分配子Agent + 传递完整的任务约束(含质量标准、检查清单)
    ↓
子Agent执行 → 自检 → 返回结果(含自检报告)
    ↓
主Agent审核子Agent产出:
  - 自动规则检查通过 → 接受
  - 发现问题 → 生成反馈 → 子Agent修正 → 重新提交
    ↓
记录协作质量:
  - 子Agent的产出被接受率
  - 平均迭代次数
  - 常见问题类型
    ↓
反馈到路由系统:
  - 该类型任务优先分配给成功率和质量更高的子Agent
  - 子Agent的Skill根据反馈持续优化
跨 Agent 经验共享机制:
Agent A 的 .learnings/ 产生高价值学习
    ↓
晋升条件满足(可泛化、非Agent特定)
    ↓
自动晋升到共享位置:
  - 规则类 → 写入 MEMORY.md(所有Agent在 session startup 时加载)
  - 方法类 → 写入对应 Skill SKILL.md(所有调用该Skill的Agent受益)
- 流程类 → 写入 AGENTS.md(所有Agent的行为规范)利用的现有基础设施:
| 机制 | 使用的 OpenClaw 能力 |
|---|---|
| 任务分配 | sessions_spawn + sessions_send |
| 子任务协调 | taskflow skill 的多步骤编排 |
| 任务路由 | router skill 的自动分类 |
| 子 Agent 产出 | sessions_yield 等待结果 |
| 经验晋升 | self-improving 的晋升机制 |
| 共享记忆 | MEMORY.md(session startup 时加载) |
实施要点:
- 制定子 Agent 产出质量标准:为
sessions_spawn的子任务定义标准化质量检查清单 - 建立协作日志:记录每次
sessions_send后子 Agent 的产出被采纳 / 打回的次数 - 路由反馈:将协作质量数据反馈到 router skill,优化任务分配
- 跨 Agent 记忆共享目录:在
.learnings/中增加shared/子目录,存放跨 Agent 适用的学习
优先级和 ROI:
- 优先级:⭐⭐⭐ 中高
- 实施成本:2-4 周
- ROI:多 Agent 场景下的核心价值——协作效率提升,减少"A 做了但 B 不认"的情况
Level 4:系统级进化闭环(长期)
目标:让整个 Agent 系统具备自我优化的能力——不是某个 Skill 变好,而是整个架构越用越强
方向一:Agent 能力自动评估
定期对每个Agent执行标准化测试任务
    ↓
评估维度:准确性、效率、自主性、错误率
    ↓
生成能力雷达图 → 识别薄弱环节
    ↓
自动建议改进:增加Skill、更新规则、调整流程
方向二:Skill 自动优化。在现有的 Darwin Skill Optimization 基础上增强:
- 不仅优化单个 Skill,还要检测 Skill 之间的依赖和冲突
- 基于使用数据自动建议 Skill 的加载优先级
- 检测长期未使用的 Skill → 建议归档
方向三:流程自动重构
分析历史任务执行数据
    ↓
识别瓶颈环节(如"审核层等待人工超过X小时")
    ↓
自动建议流程优化:
  - "该环节可以通过规则自动化,建议移除人工等待"
  - "这两个子任务可以并行执行"
    ↓
生成优化方案 → 人工确认 → 自动部署
优先级和 ROI:
- 优先级:⭐⭐ 中(取决于前三个 Level 的实施效果)
- 实施成本:持续迭代
- ROI:长期战略价值——系统从"被管理的工具"进化到"自管理的平台"
5.1 实施路线图总览
Week 1-2          Week 3-4          Week 5-8          长期

Level 1           Level 2           Level 3            Level 4
单任务闭环        跨任务学习闭环     多Agent协作闭环     系统级进化闭环

修改SKILL.md     开发自动Handoff   制定协作标准        Agent能力评估
增加执行后钩子    错误模式自动匹配   建立协作日志         Skill自动优化
完善台账闭环      trap flywheel    路由反馈机制        流程自动重构
                制度化            跨Agent记忆共享
5.2 关键成功因素
- 从小处着手,渐进验证:不要试图一次性实现所有 Level。从 Level 1 的一个具体任务改造开始,验证效果后再推广。
- 标准化先行:在开始自动化之前,先定义清楚"什么是好的产出"、"什么是需要人工介入的"、"经验该怎么记录"。标准模糊,自动化就是盲目的。
- 人机协作,而非完全替代:LE 的目标不是消除人的参与,而是把人的参与从"推动流程"升级为"关键决策"。守门人机制的设计要确保人始终在关键环节。
- 度量驱动:每个 Level 改造后,必须设定度量指标——错误重复率、任务完成率、人均介入次数——用数据证明 LE 的价值。
六、总结与展望
6.1 Loop Engineering 的本质
Loop Engineering 不是一套新的工具,也不是一个新的框架,它是一种思维方式的转变。
当我们说"用 AI"时,大多数人想的是"调用"。调用一次,得到一个回答。而 Loop Engineering 说的是"建造":建造一个能自我运转、自我检查、自我进化的系统。
从"用 AI"到"建 AI 系统",这个转变有三个层次:
| 层次 | 思维模式 | 你和 AI 的关系 |
|---|---|---|
| 第一层:AI 当工具 | 你问 AI 问题,AI 回答 | 主从关系 |
| 第二层:AI 当助手 | 你分配任务给 AI,AI 执行 | 协作关系 |
| 第三层:AI 当系统 | 你设定目标,AI 系统自主推进、检查、改进 | 系统关系 |
Loop Engineering 就是帮你从第二层走向第三层的工程方法。
它的本质不是"让 AI 更聪明",而是给 AI 一条清晰的轨道。这条轨道告诉 AI:
- 现在做什么
- 输入是什么、输出什么
- 谁检查、怎么查
- 出错了怎么办
- 什么可以自己决定、什么必须等人确认
- 做完后怎么从中学习
6.2 OpenClaw 的独特优势
在现有的 AI Agent 平台中,OpenClaw 在 Loop Engineering 方面有着独特的先发优势:
1. 基础设施已就位。大多数 Agent 平台还停留在"调用-返回"模式时,OpenClaw 已经内置了:
- 完整的记忆系统(
MEMORY.md+memory/日志 +.learnings/) - 自愈能力(self-healing 的诊断→打补丁→验证→记录循环)
- 自我改进(self-improving 的沉淀→晋升机制)
- 陷阱飞轮(Skills 的已知陷阱积累)
- Cron 定时任务体系
- Sub-agent 编排机制
这意味着在 OpenClaw 中实施 LE,不是"从零建造",而是"连点成线"。
2. Skills 系统天然支持进化。每个 Skill 的 SKILL.md 文件既是能力定义,也是知识积累的载体。"已知陷阱"章节的设计让 Skill 成为一个活的文档——它不仅描述"这个 Skill 能做什么",还持续积累"使用这个 Skill 时要注意什么"。
这个设计在其他 Agent 平台中极为罕见。
3. 记忆系统的深度。OpenClaw 的三层记忆架构(即时 / 短期 / 长期)+ 分层沉淀规范(L0/L1/L2)为 LE 的沉淀层提供了坚实的底座。大多数 Agent 系统的"记忆"只是一段 prompt,而 OpenClaw 的记忆是结构化的、可查询的、会自动进化的。
6.3 下一步行动建议
基于上述分析,建议按以下顺序推进:
立即开始(本周):
- 选择一个高频任务(如 GitHub 每日分析),按 Level 1 方案做完整 Loop 改造
- 在改造后运行 3 天,比较改造前后的任务质量和可追溯性
- 根据效果决定是否推广到所有 Cron 任务
短期(2 周内):
- 开发跨任务错误模式自动检测脚本
- 将陷阱飞轮从"Agent 主动记录"升级为"系统自动触发"
- 为
.learnings/建立定期自动复盘机制
中期(1 个月内):
- 制定子 Agent 协作的质量标准
- 建立协作质量跟踪机制
- 试点跨 Agent 经验共享(选择 2-3 个协作最频繁的 Agent)
长期(持续):
- 建立 Agent 能力评估体系
- 探索基于数据的 Skill 自动优化
- 持续迭代 LE 框架本身——把 LE 也纳入 LE 循环
6.4 最后的话
Loop Engineering 不是一个终点,而是一个起点。
它代表的是一种谦逊的态度:承认 AI 会犯错,承认我们对 AI 的使用方式可以更好,承认真正的价值不在单次调用,而在持续进化。
它也代表一种工程师的信仰:好的系统不是设计出来的,是迭代出来的。而迭代需要反馈,反馈需要记录,记录需要结构,结构需要制度。
这就是 Loop Engineering。
给 AI 一条轨道,它会跑得比你想象的更远。