
如果你是电商运营、创业者、或者每天和 AI 打交道的开发者,可能听过 Ollama 这个名字——GitHub 上 17 万星、3.6 万 fork、每天仍在持续更新。在本地跑大语言模型这件事上,它是目前最成熟、最省心的开源工具之一。
这篇文章讲一件事:Ollama 到底是什么、能解决什么问题、怎么上手。无论你是想把 AI 部署在企业内部(数据合规),还是想搭一个属于自己的私人 AI 助手,看完都会有清晰的路径。
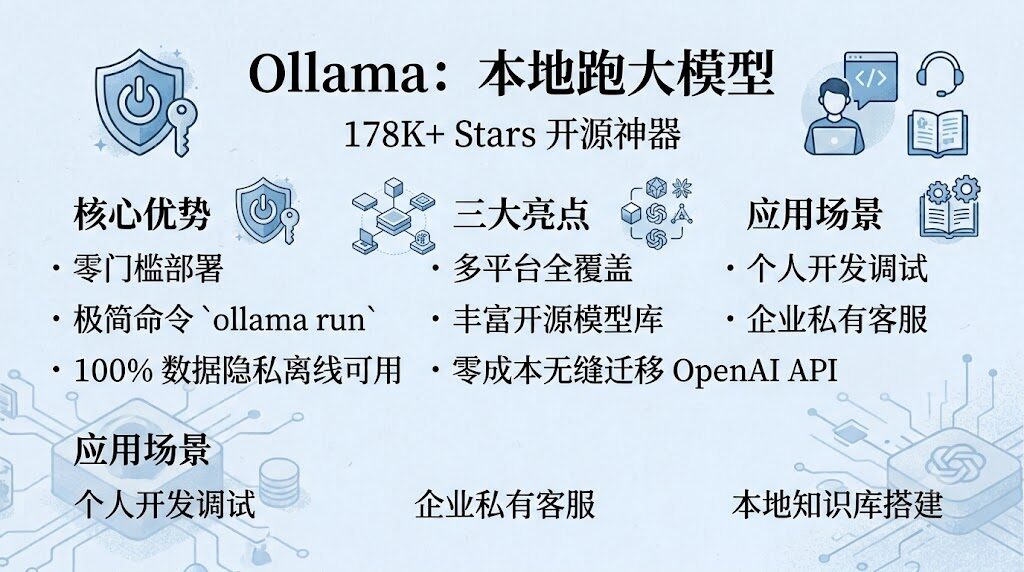
为什么是 Ollama?
过去几年,跑大模型有三条路:
- 云 API:便宜,但数据要上传,敏感业务用不了
- 自己部署开源模型:自由度高,但要懂 llama.cpp、Python 环境、GPU 驱动……门槛极高
- Ollama:介于两者之间,把上面那些复杂步骤封装成一个
ollama run命令
Ollama 的核心思路是:用 Go 写一个统一的本地推理 CLI,背后用 llama.cpp 做推理内核,把"装环境、配参数、加载模型"全部自动化。你只需要装一个二进制文件,就能跑 Kimi-K2.6、GLM-5.2、Qwen、DeepSeek、Llama 3、Gemma 等几十种主流模型。
数据完全在你自己的机器上,不联网也能用。对很多电商团队和中小企业来说,这是性价比最高的私有化 AI 方案。
基本信息
| 指标 | 数值 |
|---|---|
| 总星标 | 178,090★ |
| Fork 数 | 17,317 |
| 推送时间 | 2026-08-09(今日仍在活跃迭代) |
| 编程语言 | Go |
| 许可证 | MIT(商用友好) |
| 官网 | https://ollama.com |
| Open Issues | 3,651(社区活跃,问题反馈快) |
五分钟上手 Ollama
安装:一条命令搞定
# macOS / Linux
curl -fsSL https://ollama.com/install.sh | sh

# Windows
# 直接下载安装包 https://ollama.com/download

# Docker 部署
docker run -d -v ollama:/root/.ollama -p 11434:11434 ollama/ollama
安装完成后,Ollama 会自动拉起一个本地服务(默认监听 http://localhost:11434),不需要任何额外配置。
跑一个模型:一句命令
# 拉取并运行 Qwen2.5(首次会下载模型,约 4-10GB)
ollama run qwen2.5

# 国内模型推荐
ollama run deepseek-r1
ollama run qwen2.5
ollama run kimi-k2.6
ollama run glm-5.2

# 国际模型
ollama run llama3
ollama run gemma4
跑起来后直接在终端对话,模型完全在你机器上跑。
调 API:本地化的 OpenAI 兼容接口
Ollama 提供了一个非常标准的 REST API,可以无缝接入任何现有应用:
curl http://localhost:11434/api/chat -d '{
  "model": "qwen2.5",
  "messages": [{"role": "user", "content": "为什么天空是蓝色的?"}],
  "stream": false
}'
Python、JavaScript、Go 都有官方 SDK。如果你之前调过 OpenAI 的 API,几乎可以无缝迁移过来——只是 endpoint 从 api.openai.com 换成本地的 localhost:11434。
Ollama 的五大核心能力
1. 极简安装,多端覆盖
macOS、Windows、Linux、Docker 全平台原生支持,没有 Python 环境依赖,没有 CUDA 编译痛苦。一个二进制文件搞定一切。
2. 丰富的模型库
内置支持主流开源模型,按需拉取:
- 国产主力:Kimi-K2.6、GLM-5.2、MiniMax、DeepSeek、Qwen(通义千问)
- 国际劲旅:Gemma 4、Llama 3、GPT-OSS
- 垂直场景:代码专用、数学专用、多模态版本都有预置模型
模型仓库地址:https://ollama.com/library
3. OpenClaw 官方集成(电商从业者重点关注 🏆)
Ollama 与 OpenClaw 深度集成,可以用一行命令把 Ollama 变身为跨平台 AI 助手:
# 一键启动 OpenClaw 集成
ollama launch openclaw
支持的 Agent 生态:
- OpenClaw — 跨 WhatsApp/Telegram/Slack/Discord 个人 AI 助手(你客户在哪,AI 助手就在哪)
- Claude Code — Anthropic 官方编码 Agent
- OpenCode — 开源编码 Agent
- Codex — OpenAI 官方编码 Agent
- Copilot CLI — GitHub Copilot 命令行版
对电商团队来说,Ollama + OpenClaw = 私有化部署的 AI 客服。客户咨询数据完全在自己服务器上,不用担心泄露给第三方。
4. Modelfile:自定义模型
如果你想基于开源模型定制 System Prompt、调整 temperature、或者导入公司自己的 GGUF 格式模型,Ollama 提供了一个声明式的 Modelfile:
# my-company-bot.modelfile
FROM qwen2.5
SYSTEM "你是一家女装品牌的智能客服,语气亲切,主要回答尺码、面料、洗护相关问题。"
PARAMETER temperature 0.7
PARAMETER top_p 0.9
ollama create my-company-bot -f my-company-bot.modelfile
ollama run my-company-bot这比直接改模型代码友好得多。
5. 流式输出 + 多语言 SDK
Ollama 的 API 原生支持流式输出(streaming),实时返回 token,前端体验和 ChatGPT 一样顺滑。Python、JavaScript、Go、Rust 等语言都有官方 SDK,二次开发门槛极低。
技术架构亮点
- 后端基于 llama.cpp:ggml-org/llama.cpp 提供高效的 CPU/GPU 推理内核
- Go 语言实现:性能与跨平台兼得,单二进制分发
- 无外部依赖:不需要 Python 环境、CUDA 编译,运维友好
- 流式输出:实时返回 token,降低交互延迟
- 内存优化:支持模型量化(Q4/Q5/Q8),4GB 显存就能跑 7B 模型
适合谁用?
| 场景 | 怎么用 Ollama |
|---|---|
| 个人开发者本地调试 | 跑 Qwen2.5、DeepSeek 做代码补全、文档问答 |
| 电商团队私有化部署 | 搭本地 AI 客服,所有客户数据不出公司服务器 |
| 中小企业内部知识库 | Ollama + RAG 框架,做私有文档问答系统 |
| 创业者 MVP 阶段 | 替代云 API,月省几千块 API 费用 |
| 数据合规行业(医疗/金融/法律) | 模型本地推理,满足数据不出域要求 |
| 离线/弱网环境 | 完全离线可用,野外作业、工厂车间都能跑 |
| AI Agent 开发者 | Ollama 作为本地推理引擎,搭 Agent 工作流 |
怎么开始?
最省事的上手路径:
- 先装:官网 https://ollama.com 下载对应平台的安装包
- 跑通第一个模型:
ollama run qwen2.5,试着聊两句 - 接 API:用 Python 或 JavaScript SDK 写个 10 行 demo
- 深入集成:需要私有化部署就看 OpenClaw 集成文档;需要定制模型就用 Modelfile
如果你是企业团队,建议先在单台机器上跑通 demo,再考虑:
- 多用户并发 → 加 Ollama 服务层(Ollama 本身支持多客户端连接)
- GPU 推理 → 加 NVIDIA 显卡,Ampere 架构以上效果最佳
- 模型微调 → 用 Unsloth / LLaMA-Factory,Ollama 加载微调后的 GGUF 模型
一些值得关注的能力边界
- 模型大小 vs 显存:7B 模型 Q4 量化约 4-5GB 显存,13B 约 8-10GB,70B 约 40GB+。消费级显卡(4090 24GB)能流畅跑 30B 左右
- CPU 也能跑:纯 CPU 推理慢但能用(适合 demo 演示),生产环境建议上 GPU
- 多模态支持:Ollama 已支持部分视觉模型(如 LLaVA),但纯文本仍是主力
- 联网搜索:默认离线,需要自己加 RAG / 联网层
参考链接
- Ollama 官网:https://ollama.com
- 模型库:https://ollama.com/library
- OpenClaw 集成文档:https://docs.ollama.com/integrations/openclaw
- Ollama API 文档:https://docs.ollama.com/api
- 底层推理引擎:https://github.com/ggml-org/llama.cpp
一句话总结:如果你想让 AI 模型跑在本地、不被云 API 收费和数据隐私困扰,Ollama 是目前门槛最低、生态最完整的开源方案。从个人开发者到企业部署,一条命令起步,按需扩展。