
痛点:你以为漏写了规则,其实是规则太多了
不知道你有没有这种感觉:给 Claude 写项目规则的时候,总怕漏了什么,于是一条一条往上加。到最后 CLAUDE.md 写了一百多行,各种约束、规范、注意事项塞得满满当当,结果 Claude 该犯的错还是犯,不该忽略的照样忽略。
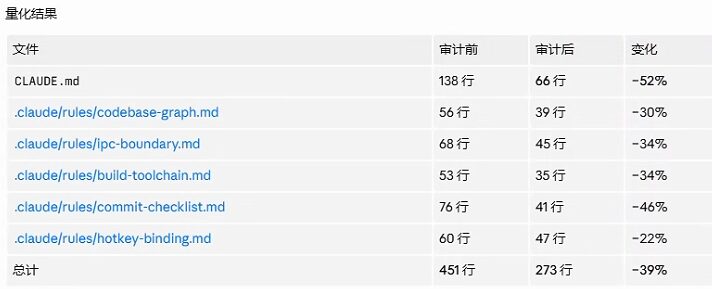
最近我在自己的项目里做了一次"大扫除",用一条极其简单的检验标准,把 CLAUDE.md 从 138 行砍到了 66 行,少了一半多。连带整个 rules 目录下的六个文件,从 451 行精简到 273 行,整体少了 39%。删完之后,Claude 的表现不但没变差,反而更稳定了。
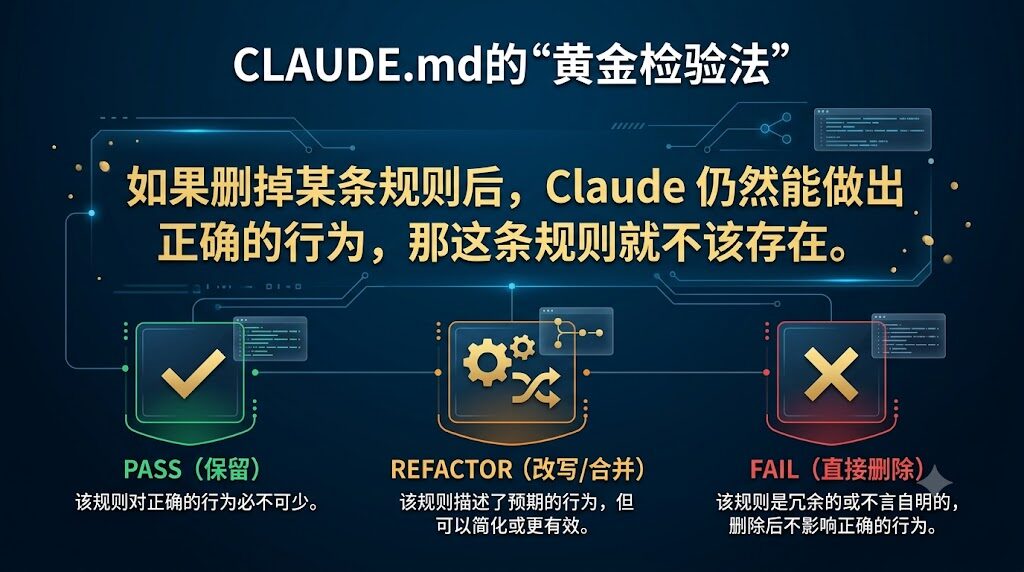
这条黄金标准只有一句话
检验规则很粗暴:如果删掉某条规则后,Claude 仍然能做出正确的行为,那这条规则就不该存在。
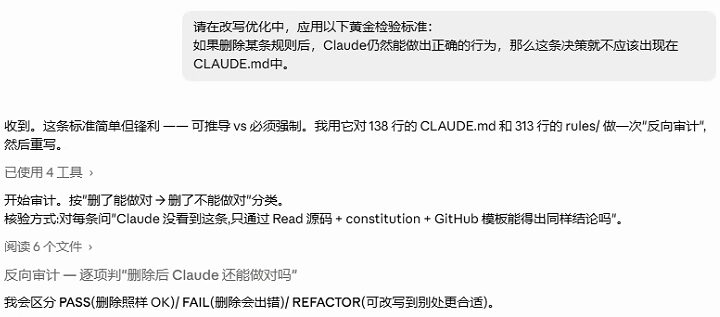
听起来像废话?但真的一条条去验证的时候,你会发现大部分规则都是"正确的废话"。
为什么会这样?原因有三个。
第一,Claude 本身就有常识和推理能力。很多我们觉得必须写清楚的"规范",比如代码要写注释、提交信息要清晰、函数命名要有意义——这些东西你不写,它大概率也会这么做。写了,只是在消耗它的注意力,没有改变行为。
第二,规则越多,信噪比越低。上下文窗口就那么大,一百条规则里混着十条真正关键的,关键的那十条反而容易被淹没。人的注意力有限,AI 也一样——规则堆得越满,真正重要的约束越容易被"平均掉"。
第三,很多规则是"结果描述",不是"行为约束"。比如写"代码要高质量"——删掉它,Claude 也不会故意写低质量代码。这种话写了等于没写,只是给自己一个心理安慰。
怎么用:逐条反向测试
具体操作起来其实很简单,就是反向思维:假设这条规则不存在,Claude 会不会做错?
如果答案是"不会",直接删。
如果答案是"可能会,但大部分时候不会",考虑合并或降级。
如果答案是"肯定会做错",这才是真正需要保留的核心规则。
我在审计的时候给每条规则打了三档:PASS(保留)、REFACTOR(需要改写/合并)、FAIL(直接删掉)。下面挑几个有意思的说说。
被判定 FAIL 的"假规则"
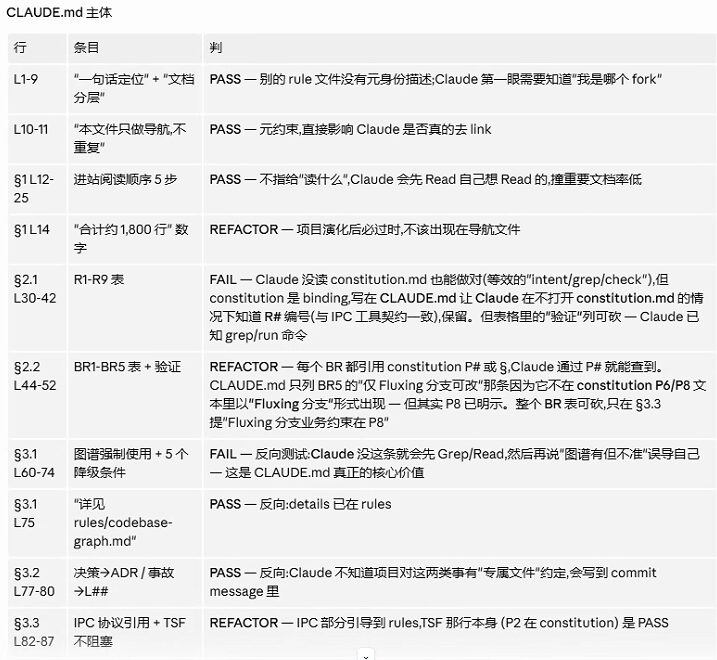
最典型的是我那张 R1-R9 表,占了十几行,列了九条编码规范。审计的时候发现:这些规则对应的行为,Claude 就算不读 constitution.md 也能做对——它本来就会做 intent 识别、grep 检查、文件跳转。那我写这张表的意义是什么?说白了就是"把 Claude 本来就会的事又说了一遍"。直接砍掉。
还有一个更反直觉的:"进站阅读顺序 5 步"这条反而通过了。因为不给它指定读什么,它会先 Read 自己想读的文件,撞对重要文档的概率很低。这条规则是真的能改变它的行为路径——删掉就乱读,留着就按顺序来,所以必须留。
真正的核心规则长什么样
审计下来,真正站得住脚的核心规则其实没几条。比如"图谱强制使用 + 5 个降级条件"这条,反向测试非常明显:没这条规则的时候,Claude 读完图谱会说"图谱有但不准",然后就自己瞎猜去了;有了这条,它才会老老实实地先查图谱、查不到再降级。
这种"删掉就跑偏、留着就纠正"的规则,才配待在 CLAUDE.md 里。
REFACTOR:不是删,是别重复
还有一类是 REFACTOR,意思是信息本身有用,但放错了地方或者重复了。比如 BR1-BR5 那张表,每个分支规则都引用 constitution 里的 P# 编号——但 Claude 通过 P# 就能直接查到原文,BR 表里只写"Fluxing 分支可改"反而制造了歧义,因为 P8 里其实已经明示了。这种不是删掉,而是合并到真正该放的位置去。
精简之后的变化
整个审计做完,数字挺惊人的:
- CLAUDE.md 本身:138 行 → 66 行,砍掉 52%
- 六个规则文件加起来:451 行 → 273 行,整体减少 39%
体感上的变化更明显。之前 Claude 经常"选择性忽略"某些规则,我总以为是它理解能力不行,现在回头看,其实是规则太杂了,它抓不住重点。精简之后,剩下的二三十条都是真正能改变行为的硬约束,命中率明显高了很多。
最后说两句
很多人写提示词的思路是"宁可多写,不可漏写",我以前也这样。但这次审计之后我的看法彻底变了:给 AI 写规则和给人写手册不一样。人会忽略废话,但废话不伤人;AI 的注意力是线性分配的,废话会直接挤占有效规则的权重。
好的 CLAUDE.md 不是写得有多全,而是每一条都不可替代。下次你觉得 Claude 不听话的时候,别急着加新规则——先看看现有的规则里,有多少删掉了也不影响。
大概率,删一删就好了。