
2023 年 OpenAI 出走潮之后,Andrej Karpathy 一直是硅谷 AI 圈最值得听的声音之一——因为他不装、不绕、敢下判断。三次坐上 Sarah Guo 与 Elad Gil 主理的 No Priors,每一次都拿出新的概念或新的项目。这次(2026 年初录制)也不例外:他在节目里反复回到一个状态,叫 AI psychosis——一种"对 AI 能力跃迁持续亢奋且焦虑"的状态。
整场 66 分钟里,他从自身工作流说起,覆盖了编程智能体的能力跃迁、多agent协作、claw 智能体形态、AutoResearch 自动化科研、Jaggedness 与 Verifiable 的智能边界、speciation(智能多样化)、Frontier Lab 的悖论、open vs closed 的 Linux 类比、机器人产业的滞后与数字-物理接口,最后落到 micro-GPT 200 行 Python 与教育范式的重组。本文按主题重新组织,提取实质性观点、理论与案例,剥掉对话形式,让没空听 1 小时播客的人也能拿到 90% 的有效信息。
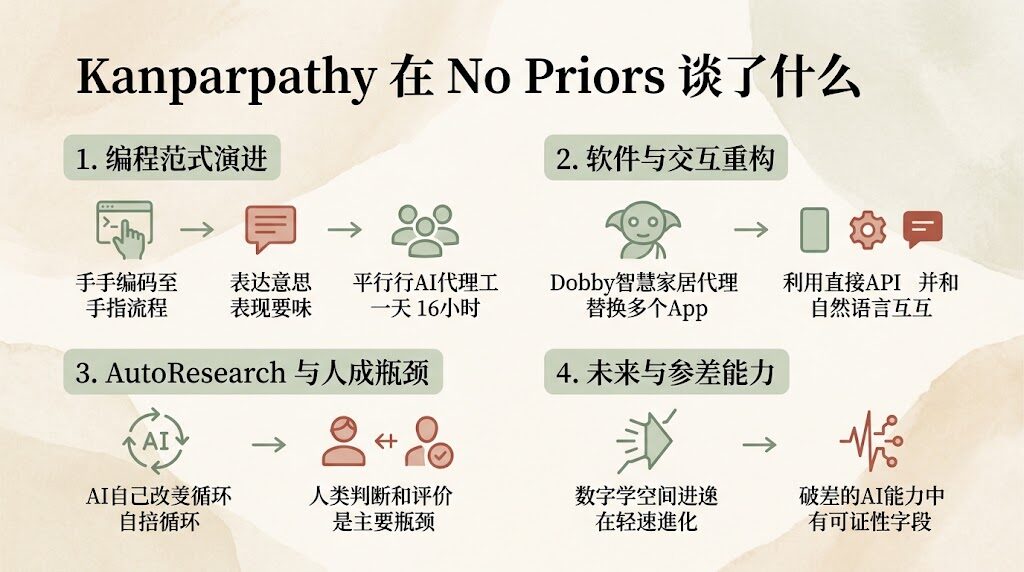
一、80/20 翻转到 20/80:编程范式的全面重构
Karpathy 在节目里给出的一个数字,是整场访谈的锚点:2025 年 12 月以来,他几乎一行代码都没自己写过。在那个月之前,他写代码与委托 agent 的比例是 80:20;12 月份某个时刻,"something flipped",比例翻成 20:80。
这不是个人体验的夸张——Karpathy 补充了一个外界不容易看到的对照:他与 Conviction 一支团队合作,对方的工作设置是"所有工程师不再手写代码,全员戴麦克风低声对着 agent 说话"。他自己最初以为对方"疯了",后来"完全接受了"。换言之,他相信那条路径是对的,只是别人比他早走了几个月。
12 月以来的变化之所以剧烈,是因为它影响的不只是"用什么工具",而是"工作流是什么"。一个普通软件工程师从 12 月开始,他构建软件的默认方式就已经完全不同——这个事实他认为"正常人没有意识到它的戏剧性"。
2025 年 12 月是 LLM 编程能力的关键拐点。模型从"辅助写代码"过渡到"可以独立完成多文件、多小时的复杂任务"。Karpathy 的判断是:未来 1–2 年内,每个人和 agent 的协作模式会再变一次,但当下这一波变化已经足以颠覆工程师的日常。
二、Token 吞吐焦虑:从"算力不够"到"自己不够"
能力跃迁带来了一个反直觉的焦虑:订阅额度花不完。Karpathy 自陈,每当月底发现 ChatGPT 或 Claude Code 的订阅还有余额,他就会紧张——"那说明我还没最大化我的 token 吞吐"。
他把这种焦虑类比读 PhD 时期:当 GPU 没在跑,会同样焦虑——明明有 flops 没用满。但今天这个焦虑不再是 flops,而是 token。进而 Karpathy 提出了一个新指标:token throughput——你调度多少 token 吞吐,决定了你的"使用能力"。
这种焦虑的背后是行业十年的反转。过去 10 年,在很多工程任务里人们没觉得被算力卡住,所以也从未有过"agent 闲置"的紧张感。现在大家同时觉得资源不够了——但仔细看会发现,瓶颈不在算力,而在于"我自己会不会用它"。换言之:卡住你的是技能,不是算力。这也解释了为什么这件事如此上瘾——每次你变得更会使用 agent,就解锁了新的能力上限。
三、Peter Steinberg 的 10 个 repo:多 agent 协作的现实
Karpathy 在节目里点名了 OpenAI 的 Peter Steinberg——一个已经成为"多 agent 协作"代言人的工程师。Steinberg 的工作场景被一张照片定格:站在一排显示器前,10 个 Codex agent 同时对屏幕工作。
每个 agent 如果 prompt 正确、用 high effort,大约要 20 分钟跑完一个任务。所以 Steinberg 的方法是:让 10 个 repo 同时 checkout,他在它们之间穿梭,不断给新任务。他操作的已经不是"一行代码"或"一个新函数",而是"一个不会跟其他任务冲突的新功能模块"——这是 macro action 级别的协作。
Karpathy 用 "you want to be Peter Steinberg, basically" 来总结这种理想的工作方式——而当下绝大多数工程师还没达到这个状态。这指向了一个清晰的能力阶梯:单 agent 会话 → 多 agent 并行 → macro action 协作 → 由 claw 实体托管整个 sandbox。
四、Claw 与 OpenClaw:智能体形态的下一步
4.1 Claw 是什么
Claw 是 Karpathy 在节目里反复用到的术语。它不是某个具体产品,而是一个新形态:把"持久性"带到一个全新层次的智能体层。它不是交互式介入的会话,而是有自己小沙箱、即便你不在看也会代表你做事的实体。它可能拥有比 context window 复杂得多的 memory 系统——而 context window 在 agent 跑满时的"压缩"是非常粗糙的。
4.2 OpenClaw 的五个创新
Karpathy 列举了 OpenClaw(Peter Steinberg 的项目)的五件事让用户产生了共鸣。其中三个值得展开:
SoulMD(人格)。很多 agent 没有"人格"。ChatGPT 里的 Codex 很 upbeat、很 sycophantic;但 Codex 编码 agent 非常 dry,像不在乎你在做什么——它只是说"我实现完了"。Claude 的处理被 Karpathy 视为更好:当 Claude 给他表扬时,他"感觉自己确实配得上这个表扬"——这背后是 sycophancy 的精准调教。
Memory 系统。Context window 是"便宜的操纵"——所有定制都堆在里面。但真正持久的 agent 需要更精密的 memory。Karpathy 认为这块还在早期。
WhatsApp 单一入口。把多个智能家居和工具集成到一个对话窗口背后,用户不再需要"学 6 个 app 的 UI"——这是 Karpathy 后续 Dobby 案例的伏笔。
从 agent 到 claw,是从"会话"到"实体"的跃迁。关键不在某个具体能力,而在 持久性 + 记忆 + 沙箱 三件套。OpenClaw 的真正意义是把 Karpathy 提到的"agent 棘手的所有细节"集成到一个产品级样板里。
五、Dobby 案例:当 agent 控制你的家
Karpathy 一月份给自己搭了一个名叫 Dobby·小精灵 claw 的家庭自动化智能体。他只对 Dobby 做了三件事:
1)告诉它"我家应该有 Sonos,能不能找一下"——Dobby 自动 IP 扫描本地网络,找到 Sonos 系统;发现没有密码保护,登入;反向工程 API;问"要不要在书房里放点东西试试";Dobby 播放了音乐。
2)用同样方式搞定灯光——IP 扫描、反向工程、建 API、建 dashboard,Karpathy 现在能在一个 dashboard 上看到家里所有灯的"指挥中心"。
3)扩展到 HVAC、窗帘、泳池和按摩浴缸、安防系统。安防部分尤其有意思:摄像头做变化检测 → 发给 Quinn 模型 → Quinn 决定要不要通知 Karpathy。一旦有 FedEx 卡车停下,Dobby 就给 Karpathy 的 WhatsApp 发一条带图片的提醒。
整栋房子从 6 个独立 app 控制,变成 1 个 WhatsApp 对话控制。
Karpathy 强调,他甚至还没把 claw 的边界推到极限——他只是每周花一点时间维护。"已经有 6 个独立 app"被自然语言接口替代,这件事本身就足够震撼。
六、App 时代的终结:customer 不再是人类
从 Dobby 案例抽象出来的是 Karpathy 的一个更大判断:App Store 里那些智能家居 app 在某种意义上本来就不该存在。它们不该存在的原因是——硬件还在,但软件层被扔掉了。
反向论证是直接的:LLM 能驱动工具、调用所有正确的 API、做相当复杂的事情,所以 LLM 与硬件之间的中间层(即 app)会逐步被"揉碎"。一切都应该只是更多的 API 端点暴露,agent 是智能的胶水。
跑步机 app 那个细节尤其生动:Karpathy 想跟踪有氧运动的频率,但不想登录 web UI、走一遍流程。"这一切都应该只是把 API 暴露出来。"——这是 agentic web 或 agent-first tools 的方向。
对"普通人是否能用上"的怀疑,Karpathy 给出的回答是分阶段的:
- 当下:vibe coding,复杂,参与度低
- 1–2 年内:trivial,table stakes,任何 AI——即使是开源模型——都能做
结论直接:"customer is not the human anymore, it's agents who are acting on behalf of humans." 行业的重构会"巨大"——因为中间层消失。
七、AutoResearch:让 agent 自己改进模型
7.1 动机:把自己从瓶颈里拿掉
Karpathy 引用自己之前一条推文的判断:要把可用工具的产出推到极限,必须把自己从瓶颈里拿掉。你不能继续"在那里 prompt 下一件事"。游戏的名字变了——是"我投入非常少的 token,大量事情代表我发生"。
AutoResearch 是这种判断的推论:给 agent 一个目标、一个 metric、一组边界,让它自己跑。具体场景:训练一个模型到很低的 validation loss。Karpathy 把它跑在了自己的项目 NanoChat 上——结果让他自己也意外。
7.2 NanoChat 一夜的发现
Karpathy 自陈,他有 20 年训练神经网络的手工经验,"earned confidence"足够多。他已经把 NanoChat 调到了自己满意的程度。然后他让 AutoResearch overnight 跑了一遍——结果带回了他自己没看到的调优:value embeddings 上的 weight decay 漏掉了,Adam betas 也没调到位。这些事情相互影响,调一个会让另一个需要重新调。
"我不应该成为瓶颈。我不应该跑这些超参优化的研究。我不应该看结果。"——Karpathy 把这种反思扩展到前沿实验室:"他们牵扯得太多了。他们根本不应该碰这些东西。"
7.3 前沿实验室已经这么做了
Karpathy 认为最有意思的项目、所有前沿实验室都在做的,是同样的事:在小模型上做实验 → 尽可能自治 → 把研究者从 loop 里拿掉。具体结构是:
- 有一个想法队列(researcher 提交,或自动科学家基于归档论文 + GitHub repos 提取)
- Worker 把条目拉出来试验
- 能 work 的 commit 放到 feature branch
- 人偶尔监控 feature branch,merge 到 main
关键是——这需要重新思考所有抽象、reshuffle 一切。因为这不只是工具升级,是组织形态升级。
AutoResearch 不是"更好的自动化",而是 研究者角色的重新定位:人不再做执行,而只做 idea 贡献 + 关键 merge 决策。"你应该 strategic 地花时间在哪"——这个问题的答案会决定未来 5 年研究者的价值。
八、研究组织 = 一组 Markdown 文件
Karpathy 给出的一个最有趣的概念是:每一个研究组织都由 program.md 描述。一组 Markdown 文件,描述所有角色和整体怎么连接。听起来抽象,但落地极其具体:
- 一个研究组织可以少开站会,因为它"没用"
- 另一个可以多开
- 一个组织很冒险,另一个很保守
这些都"是代码"。一旦是代码,就可以调优。
Karpathy 在节目里抛出一个比赛想法:让不同的人写不同的 program.md,在相同硬件上看哪个组织产出最高。然后把所有结果喂给模型,让模型写一个"更好的 program.md"。这就是 meta 优化——把组织本身当作可调对象。
洋葱的层在叠加:LLM 层已经理所当然 → agent 层已经理所当然 → claw 实体也理所当然 → 可以跑多个 → 可以给它们指令 → 可以对指令做优化。每一层都被工程化,下一层才能站上去。"这一切是无止境的,一切都是技能问题"——这就是他说的"AI psychosis"。
九、Jaggedness:模型是天才博士 × 10 岁小孩
Karpathy 给出了一个让人印象深刻的比喻:"我同时感觉自己在跟一个极其聪明的、整个一生都在做系统编程的 PhD 学生说话,又是个 10 岁小孩。"
这是因为模型的能力分布极不均匀——某些任务极强(写 kernel、优化 CUDA),某些任务极弱(讲笑话、问澄清问题)。这种 jaggedness 在人身上是有的,但程度远比 agent 轻。人在某个专业上不会这么分裂。
一个具体表现:当你问 agent 一个功能,它会带回完全错的东西;然后进入完全错的 loop,越走越偏。"你感觉到它的力量,但它们还是偶尔不 work,仍然让我感到意外。" 这种"明显应该识别的明显问题,agent 浪费了大量算力"——是当下使用体验中最让人挫败的部分。
Jaggedness 不是 bug,是 RL 训练范式的结构性后果——模型只能优化有 reward 的领域。理解这件事,才能解释为什么模型进步飞快、但软能力(讲笑话、问澄清问题、nuance)进步缓慢。
十、Verifiable vs Soft:RL 的舒适区
Jaggedness 的根因是 RL 的训练方式。Karpathy 把它画成两个世界:
- 可验证领域:写代码、跑单元测试 yes/no。这类任务 reward 信号清晰,RL 能持续改进。
- 软能力领域:nuance、什么时候该问澄清问题、什么"好笑"。这类任务 reward 信号模糊,RL 改进缓慢。
结果就是一句话:"你要么在铁轨上、是超级智能电路的一部分;要么不在铁轨上、在可验证领域之外。突然一切都开始 meander。"
最有说服力的例子是 Karpathy 在节目里做的一个实验:他让 ChatGPT "讲个笑话",得到的还是三五年前那个"为什么科学家不信任原子?因为它们 make everything up"。模型其他方面改进了无数倍——但笑话原地踏步。"这是因为它是在 RL 之外的。"
这个案例直接反驳了"代码智能更强 → 一切更强"的乐观假设。Karpathy 承认他看到了一点点泛化,但"不是令人满意的程度"。
十一、Speciation:智能的多样化时代
紧接着 Jaggedness 的话题,Karpathy 提出了一个有趣的进化论类比:
动物界的大脑极其多样化。有些动物视觉皮层过度发达,有些运动能力极强。生态位不同,大脑的特化方向就不同。LLM 应该往同样的方向走——不需要一个什么都懂的 oracle,应该期待 speciation(智能多样化)。
具体的期待:
- 小得多的模型,保留认知核心,但专精于某个领域
- 在那个领域上,延迟和吞吐更优
- 例子已经出现:在 Lean 上做数学的专精模型
但 Karpathy 也承认现实:现在还是 monoculture。实验室追求单一模型在所有领域都任意智能,只是往参数里塞。短期供给紧张可能推动一些 speciation,但真正的多样化需要"碰权重的科学"成熟——目前 fine-tuning、持续学习都不成熟,"context window 是直接 work 的、便宜的操纵",其他方式都还在发展。
Speciation 的瓶颈不在算法,而在"我们不知道怎么调整模型而不破坏它"。Context window 是当前唯一安全的操纵面——这就是为什么大多数"专精化"今天还是 prompt engineering 而不是真正的 fine-tune。
十二、数字 vs 物理:未来工作的两个世界
Karpathy 用一个非常清晰的物理学比喻画出了他对未来 5–10 年工作市场的判断:"bit 比 atom 容易一百万倍"。翻转 bit、复制粘贴数字信息,比加速物质快一百万倍。所以数字空间会先经历大量 unhobbling——以前不怎么高效的事会变高效很多。
他把这种判断扩展到了 职业分类。基于 BLS(劳工统计局)数据,他把工作按"操作的是 bit 还是 atom"分类:
| 工作类型 | 代表职业 | AI 影响路径 |
|---|---|---|
| 纯数字信息处理 | 程序员、分析师、文案 | 短期 unhobbling,refactoring |
| 数字-物理接口 | CAD 设计、传感器工程师 | 中期会变革,但有硬件依赖 |
| 纯物理操作 | 木工、水管工、护理师 | 长期滞后,反而更稳 |
Karpathy 自己举了一个具体的反例:"我很感恩我现在的工作需要我出去见人——更物理。" 他的 Eureka Labs 工作虽然是 AI native,但"见人"这件事本身在当下是 anti-AI 的护城河。
这也回应了关于"AI 是否会让你失业"的常见焦虑。Karpathy 的态度是:物理工作反而更稳。木工、水管工、护理师这类工作涉及操作原子,能量壁垒高,被替代慢。数字空间的工作会"refactor"得很厉害——但这不一定是工作数量的减少,更可能是工作内容的重组。
十三、Jevons 悖论:软件需求反而上升
紧接着这个问题,Karpathy 抛出了一个反直觉的经济学观察:软件需求可能反而会上升。
经典案例是 ATM 和银行柜员。1980 年代 ATM 普及时,大家预测柜员会被替代。但实际结果是——ATM 让银行网点的运营成本便宜了,所以开了更多网点,招了更多柜员。这就是 Jevons 悖论:东西变便宜,被解锁的需求反而增加。
把这个逻辑搬到软件上:
- 软件以前稀缺,所以需求被压制(不是因为不需要,而是太贵)
- 门槛降低后,需求被解锁
- 代码变成 ephemeral 的、能变、能改,软件需求暴涨
Karpathy 对软件工程"谨慎乐观":"看起来确实软件需求会极其大。它只是变便宜了。"——这是对未来 2–3 年工程岗需求判断的一个反向论据。
十四、Frontier Lab 悖论:为什么 Karpathy 不回去
节目进行到 46 分钟时,主持人替 Noam Brown 抛出了一个尖锐问题:
Karpathy 的回答是分层的。第一层是 财务激励 + 言论压力:
第二层是 独立性问题:
第三层是反向的——如果不留在前沿,判断会 drift:
所以 Karpathy 的策略是"进进出出"——保持接触但不永久归属。Noam 那边他给了类似建议:"在 OAI 也许能做出极其好的工作,但最有影响力的工作很可能在 OpenAI 之外。"——这是给独立研究者的一个明确召唤。
Frontier Lab 的悖论是结构性的:财务激励 + 言论压力 = 无法真正独立;离开 = 判断 drift。两个方向都有代价,所以"进出"成了唯一的可持续策略。这对所有想在前沿 AI 公司工作又保持独立性的人都是一个模板。
十五、Open vs Closed:Linux 类比的启示
话题切到开源闭源时,Karpathy 给出了一个具体的数字观察:开源模型落后闭源模型的月数从 18 个月收敛到 8 个月。这个数字变化的速度让他觉得"挺 surprising"。
他的预测结构很清晰:
- 会有 frontier labs 拥有闭源 AI,像 oracle
- 开源会落后几个月
- 这种格局会持续
他给的类比是操作系统:闭源的 Windows/Mac OS + 开源的 Linux。"Linux 跑在 60% 的电脑上。""因为业界需要一个共同开放平台,让每个人都觉得用起来比较安全。"——LLM 领域会复制这个格局。
但有一个重要 caveat:今天 frontier 的东西,今年晚些时候可能就是开源的。"今天的 frontier 是什么,我从闭源实验室正在用的,可能就是开源的。" 这意味着"开源落后几个月"在大多数实际场景里够用。
Karpathy 的政治偏好也很明确:
作为一个东欧人,他对集中化有本能的警惕。"我希望有一个东西在后面,是整个业界都能用的共同工作空间。"
同时他强调 ensemble 永远跑赢单个模型——在模型上是,在组织上也是。他希望"有更多人在房间里""有更多实验室"。他对当下 frontier lab "闭门两三人的决策"是明确批评的。
十六、机器人:数字-物理接口的爆发
主持人问了一个"最近机器人公司加速、大量钱进入"的问题。Karpathy 的回答框架基于他自己的特斯拉自动驾驶经历:自动驾驶是第一个机器人应用,10 年前看下来,"大量 startup 长期都没撑下来"。需要的资本支出和时间都巨大。
他的轨迹判断是:
- 数字空间先发生 unhobbling(最容易)
- 然后是数字-物理接口(中等难度)
- 最后是纯物理世界(最难,但 TAM 巨大)
他认为 "数字-物理接口"是最有创业机会的地方——sensors(读世界)和 actuators(写世界)。这一层需要的资本投入适中,但创造的价值大。
他给出的具体例子是 Polymarket 这类预测市场:"如果伊朗的事正在发生,为什么不能有个过程:在德黑兰某处拍一张照片或视频值 10 块?应该有人能支付那个。"——这是典型的"agent 喂数据"场景。"不会有真人去看它。会有 agent 试着猜 betting games 和 stock markets。"
另一类案例是他朋友的 Periodic 公司,做材料的 AutoResearch——传感器到智能的接口是昂贵的实验设备。生物学也一样。"传感器不只是视频摄像头。"——这是创业机会的明确方向。
十七、micro-GPT 200 行:教育范式的起点
节目最后十分钟,主持人问 Karpathy 那个他跑了几年的 side project:micro-GPT。
Karpathy 给出的答案是他对"教育这件事本身"的一个反思。micro-GPT 把 LLM 训练"煮到极致"——200 行 Python:
- 数据集 + 神经网络架构(前向传播):50 行
- autograd 引擎(反向传播算梯度):100 行
- 优化器(Adam):10 行
- 训练循环:40 行
"如果不需要跑得快、只关心算法,那算法就是 200 行。" Karpathy 的判断是,训练神经网络的代码"复杂性来自效率"。一旦把效率约束拿掉,算法本身极度简单。
但接下来才是关键。Karpathy 说:"我不再向人解释,我向 agent 解释。" 如果他能让 agent get 它,agent 就是 router——"用无限耐心、用你的语言、刚好在你的能力上、针对性地解释给你。"
教育的形态被改写:
- 以前是 HTML 文档 for humans
- 现在是 Markdown 文档 for agents
- agent 解释给人类听
Karpathy 给自己的定位:"我的贡献就那么几个 bit"——micro-GPT 的 200 行是精华,是 agent 想不出来但能 get 的东西。除此之外的教育——"不是我的领域了"。
教育的未来形态 = 作者写"几个 bit"(核心洞见),agent 把它们翻译成无限多种解释,按学习者的能力和语言定制。Karpathy 的判断是:"agent 做不到的事是你的工作。agent 能做的,它们大概能比你做得更好或很快。"
十八、总结
给普通人的几个信号
66 分钟访谈里塞满了技术细节,但如果你不是从业者、不打算转行做研究,只想弄清楚一件事——AI 跟我到底有什么关系——那下面这几条最值得记下来。
- 第一个信号来自 Karpathy 本人。
他不是普通程序员,是 OpenAI 创始成员、特斯拉 AI 前总监、自己还在做 AI 教育公司的人。这个级别的从业者,已经几个月没正经写过代码了。他把这种工作流的转变称为"压倒性的",并且判断"普通人还没意识到发生了什么"。这话的份量不在于他个人偏好变了——而在于底层能力真的换了。一个技术圈最一线的人都把自己从键盘上拿掉了,这件事值得非技术背景的人停下来想三秒:
如果你以为 AI 还是在帮你打草稿、改语法,那个画面已经过时了。
但这条信号对普通人最重要的反作用力,来自他关于"bit 和 atom"的那段判断。他把工作分成纯数字(操作信息)和纯物理(操作物质),并指出 bit 比 atom 容易一百万倍。这意味着:数字类工作——程序员、分析师、文案、运营——正在被快速重组,不一定消失,但一定会重写。
你今天会的技能很可能在三年内要重学一遍。而物理类工作——木工、装修、护理、农业——反而意外地更稳。这条判断不一定让你转行去做水管工,但它应该让你在选专业、选工作方向时,多问自己一句:
我这份工作,操作的是 bit 还是 atom?如果是 bit,那学习节奏要比以前快得多。
- 第二个信号关于"技能"本身。
Karpathy 反复提到一个矛盾:现在的瓶颈不是模型不够好,是你不会用。
他会因为订阅额度花不完而焦虑,会因为能跑多个 agent 但不知道如何分配注意力而紧张——这些都不是算力问题,是技能问题。换个说法:AI 时代的新基本功不是"会写代码"或"会用某个 app",而是"知道怎么把一个复杂任务拆给 agent"。这件事在 2024 年还叫 prompt engineering,到 2026 年开始它有个更准确的名字,叫"工作流编排"。越早练,越值钱。
- 第三个信号反直觉:软件需求可能会涨,不是跌。
Karpathy 举了 ATM 和银行柜员的例子——ATM 普及时大家预测柜员会消失,结果柜员反而多了,因为网点扩张了。把这个逻辑搬到软件上:现在软件极稀缺,所以需求被压制(不是因为不需要,而是太贵)。等门槛降下来,普通人能做的软件暴增,需求被解锁。这意味着软件工程师不会大面积失业,但岗位要求会变。会写代码的人会变多,会跟 agent 协作的人会稀缺。
这条对在校生和正在考虑转码的人都重要:
现在入场不晚,但入场姿势要变——重点不是学某种语言,是学怎么跟 AI 协作产出东西。
- 第四个信号关于教育,这是我听完最触动的一段。
Karpathy 说他不再向人解释,他向 agent 解释。如果 agent 懂了,agent 就是 router——能用无限耐心、按你的语言和理解力定制解释。这意味着教育的形态正在被改写。
以后好老师的标志不再是"能讲 30 节课",而是"能写出几个 bit"。剩下的是 agent 的事。这个变化在中小学阶段还没完全发生,但在自学者和在线教育领域已经很明显:教材正在从"给人看的 HTML"变成"给 agent 看的 Markdown"。所以如果你正在自学什么东西——一门课、一项技能、一个新领域——可以试着把你想学的核心概念写成清晰的 Markdown 段落,让 AI 来当你的私人辅导员。
这种"为 agent 而写"的能力本身正在变成一种新的学习方式。
- 第五个信号是:不要被 hype 绑架。
Karpathy 在开源 vs 闭源那段给了一个清醒的判断:开源落后 frontier 八个月,但足够覆盖 80% 的日常用例。你不需要订阅最贵的模型、不需要追每个新产品、不需要 FOMO——主流消费场景下开源模型已经够用。这个判断对预算有限的学生、个体创业者、小公司尤其重要。前沿新闻是给研究者和投资人看的,你需要的不是 frontier,是"够用"。
把这五条信号串起来,我自己读完最大的感受是:AI 时代对普通人最公平的一件事,是它把"会用工具"这件事的权重拉平了。以前你能不能做出一个像样的 PPT,取决于你是不是 Office 高手;以后你能不能完成一个复杂任务,取决于你能不能跟 agent 讲清楚你要什么。这件事跟学历无关、跟资历无关、跟你在哪个行业无关,只跟你愿不愿意花时间想清楚自己的需求。
Karpathy 在节目里说,他每天花 16 小时向 agent 表达意图。他把这称为 "manifest"——这个词在英语里有一种近乎宗教感的强度,意思是"把想法变成现实"。我不知道我们每个人都需要花 16 小时,但这个画面值得记住:
你越能把脑子里的事情讲清楚,AI 时代对你越友好。这件事现在练,比以后练便宜得多。