
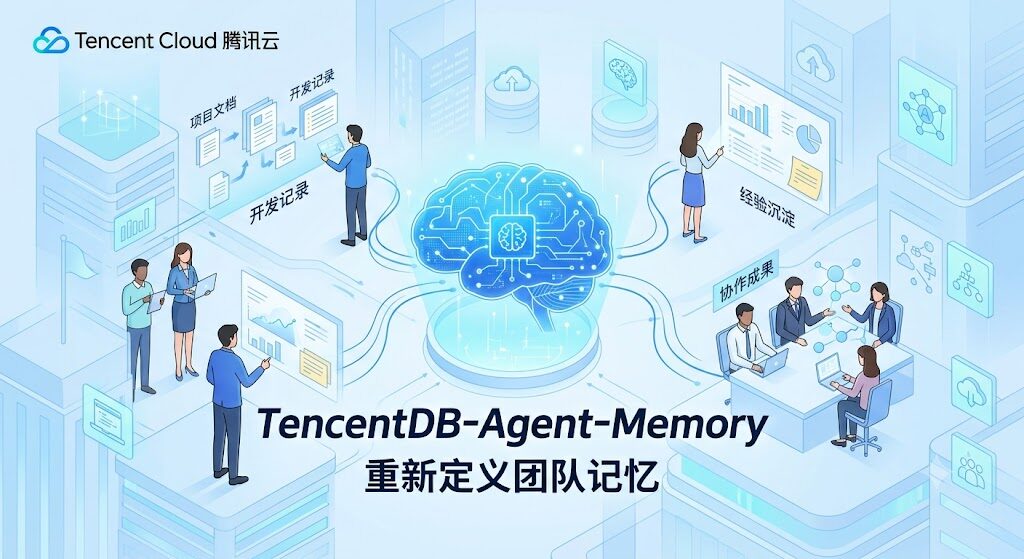
如果你是开发者、团队 leader,或者一个想搭建 AI 工作台的创业者,这个项目值得你花 7 分钟。它解决的是一个你大概率正在被折磨的问题:每一次新开对话都要重新解释一遍背景,每换一个 Agent 都从零开始。腾讯云的 TencentDB-Agent-Memory 给出了一个团队级解法——把 Agent 学过的东西变成可复用的记忆资产。
一、它到底在解决什么问题
每个用过 AI Agent 的人都熟悉这个场景:
- 你昨天调教好了一个"懂你项目"的 Agent,今天新开会话,它又什么都不记得了
- 你换了一个更聪明的模型,结果发现之前积累的偏好、约束、踩过的坑全没了
- 团队里 A 同事花了三天摸清的项目背景,B 同事重新开始问同样的问题
- 客服 Agent 在工单里答过的思路,下一个工单又要重新想
腾讯云团队把这些问题归结成一句话:每个 Agent 的第一件事是"重新学习项目"。
TencentCloud/TencentDB-Agent-Memory 这个项目的野心就是:把每一次对话、每一份文档、每一行代码里"已付过的学习成本",变成可以传给下一个 Agent、下一位同事的 Save File。
二、四类记忆资产:Agent 的"攒家底"清单
项目的核心是把所有能复用的知识整理成四类资产。
1. Chat Memory(对话记忆)
把原始对话层层蒸馏成四级结构:
- L0 Conversation:原始对话全文,能精确还原上下文
- L1 Atom:从中提取的事实、偏好、约束
- L2 Scenario:按项目或场景组织的知识块
- L3 Persona:长期画像和高层认知模式
举个例子,"不要重构旧 auth 模块——移动端还在用"这种高价值上下文,就属于 L1 级别的 Atom。它不应该靠人类每次重复,应该自动沉淀。
四层结构的好处是不同场景用不同粒度——快速启动用 L2/L3,精确召回用 L1/L0,既能压住上下文窗口,又能随时深度回顾。
2. Skill(技能库)
Skill 不是提示词片段,而是带完整元数据的可执行资产:版本号、关联资源文件、触发条件、执行步骤、验证规则。
这相当于把"故障排查流程""代码审查清单""发布前必备事项"这类团队 SOP 沉淀成结构化资产——学会一次,全团队复用。
3. LLM-Wiki(知识库)
产品文档、设计规范、运维手册自动结构化成 Wiki 页面,支持链接图谱(link graph)钻取式导航。灵感来自 Karpathy 的 LLM Wiki 概念——文档之间不再孤立,Agent 能顺着链接挖到底。
4. CodeGraph(代码知识图谱)
索引代码符号、文件、调用关系、影响路径。Agent 可以搜索、读取、查询调用者和被调用者;改一行代码之前,先看影响哪些文件——这相当于 Agent 版的"代码地图"。
三、对比一下,它和标准 RAG 有什么本质不同
很多人第一反应是:这不就是企业 RAG(Retrieval-Augmented Generation)嘛?其实差得远。
| 维度 | 标准 RAG | TencentDB Agent Memory |
|---|---|---|
| 对话历史理解 | △ 能做但浅 | ✅ Chat Memory 四级蒸馏 |
| 可执行经验沉淀 | — 做不到 | ✅ Skill 含版本/触发/验证 |
| 文档结构与关系 | △ 容易碎片化 | ✅ LLM-Wiki + Link Graph |
| 代码调用图谱 | △ 靠文本匹配 | ✅ CodeGraph 符号级索引 |
| 所有权 / 版本 / 状态 | — 没设计 | ✅ 全套元数据 |
| 团队共享与 Agent 装备 | — | ✅ |
| 私有 / 团队 / ACL 访问控制 | △ 文档级 | ✅ 多级权限 |
一句话总结:标准 RAG 是"塞文档给 AI 用",Agent Memory 是"教 AI 把学会的东西整理成可传承的资产"。
四、团队记忆 Hub:三级访问控制
项目自带一个团队记忆面板(Memory Hub),权限模型分三层:
- private:仅 Owner 可读,团队管理员也不行
- team:所有团队成员可读
- restricted:通过用户/角色/Agent ACL 精确控制
角色体系也分三层:
- System Admin:管用户、管团队
- Team Admin:管资产协作与权限
- Member:普通成员
文档里给了一个"一人公司 AI 团队"的示例:
Tiny but Serious Inc.
├── 你(定方向 / 做决策)
├── Scout(调研 / 找机会)
├── Builder(写代码 / 出产品)
├── Reviewer(测试 / 找问题)
└── Agent Memory(团队经验的载体)

Scout   → 用户访谈 Chat Memory + 市场 Wiki + 竞品 Skill
Builder → 产品 Wiki + 项目 CodeGraph + 功能交付 Skill
Reviewer→ 历史故障 Chat Memory + CodeGraph + 发布检查清单 Skill
每个角色都有自己的记忆资产池,互相之间通过 ACL 决定是否可见。这套架构对 5-50 人的 AI 团队尤其友好。
五、和 OpenClaw 的深度集成
项目的 topics 明确标注了 openclaw-plugin,badge 写着支持 OpenClaw ≥ 2026.3.13——这是个"官方盖章"的集成路径。
使用方式很简单:
- 跑
./start-all.sh,一键启动 memory-core + memory-hub + proxy - 启动后会输出一个可直接粘贴到 Claude 的 one-liner
- 打开本地面板 http://localhost:8125 管理团队记忆
对 OpenClaw 用户来说,这意味着你已有的 Agent 工作流可以直接挂上这套记忆系统——Chat Memory 让会话延续、Skill 让 SOP 可复用、CodeGraph 让代码改动更安全、Wiki 让文档不再消失。
六、值得你借鉴的 4 个设计
即使你不打算直接用这个项目,它的几个设计思路也值得抄:
1. 四层对话蒸馏架构
L0→L1→L2→L3 的分层让不同粒度的记忆服务于不同场景——快速启动用 L2/L3,精确召回用 L1/L0,同时通过结果数量、字符预算、超时限制防止上下文撑爆。这种"分层记忆"思路完全可以用到你自己的 Agent 系统里。
2. 冷启动导入
项目支持直接导入已有代码库、文档、对话记录——新 Agent 第一天就能继承团队积累,不用从零开始。这点对任何正在做"会话压缩→新会话"的团队都很有启发:与其只压缩,不如主动提取关键事实注入新会话。
3. Skill 的完整元数据模型
Skill 不只是 prompt snippet,而是含版本、资源文件、触发条件、执行步骤、验证规则。这比单纯的提示词管理精细得多——下次你设计自己的"技能库"时,强烈建议把这些字段一起加进去。
4. 二维权限体系
private / team / restricted + System Admin / Team Admin / Member 的二维权限设计,是团队级 Agent 协作的基础设施。不管理权限,再聪明的 Agent 也会变成信息泄露的源头。
七、什么时候你用不上它
也要说几个反面场景,免得你白折腾:
- 只用 ChatGPT 网页版聊聊家常——单用户、轻量场景直接用自带 Memory 功能就行
- 完全没有代码资产——CodeGraph 这部分对你没用,可以等以后再上
- 团队就 2-3 个人且都在做同一件事——Memory Hub 的权限模型成了过度设计
- 私有数据合规要求本地部署——项目支持自托管,但需要你懂 Docker / Linux 基本操作
八、一个开放生态的位置
TencentDB-Agent-Memory 不是孤岛——OpenClaw(≥ 2026.3.13)、Hermes、Claude Code、CodeBuddy 都在官方支持列表里。这意味着你不用"All in"某一个平台,可以在自己的工作流里选用最合适的组合。
更重要的是,这个项目背后用的 CodeGraph 引擎来自 colbymchenry/codegraph,是 GitHub 上另一个独立项目(5K+ stars,专做代码图谱)。这种"站在巨人肩膀上"的整合方式,正是当前 AI Agent 工具生态的典型状态。
💡 写在最后
如果你也在被"AI Agent 总失忆"这件事困扰,腾讯云这套 TencentCloud/TencentDB-Agent-Memory 的设计思路值得认真参考。