
想象这样一个场景:你在网上读到一篇关于电商运营的好文章,读的时候觉得很有道理,但一周后再问AI"上周那篇讲什么的",AI一脸茫然——因为那篇文章早已石沉大海,你的记忆和AI的记忆之间,隔着一道无法跨越的鸿沟。
这几乎是所有人使用AI知识管理工具时的痛点:AI可以帮你回答问题,但无法帮你"记住"你曾经学过什么、思考过什么、得出过什么结论。每一次提问,都是从零开始。
obsidian-wiki-maintainer技能,正是为了解决这个问题而生的。
一、它解决什么问题
在介绍这个技能之前,我们需要先理解一个核心问题:为什么AI总是"记不住"东西?
原因很简单:大多数人的知识管理方式本质上是一次性的。
具体来说,流程是这样的:
- 读一篇文章
- 问AI几个问题
- AI给出一个回答
- 对话结束,知识消散
下一次再问类似问题,AI需要重新理解上下文、重新检索资料、重新推理——它根本不知道你上周已经研究过这个话题,并得出了某个结论。
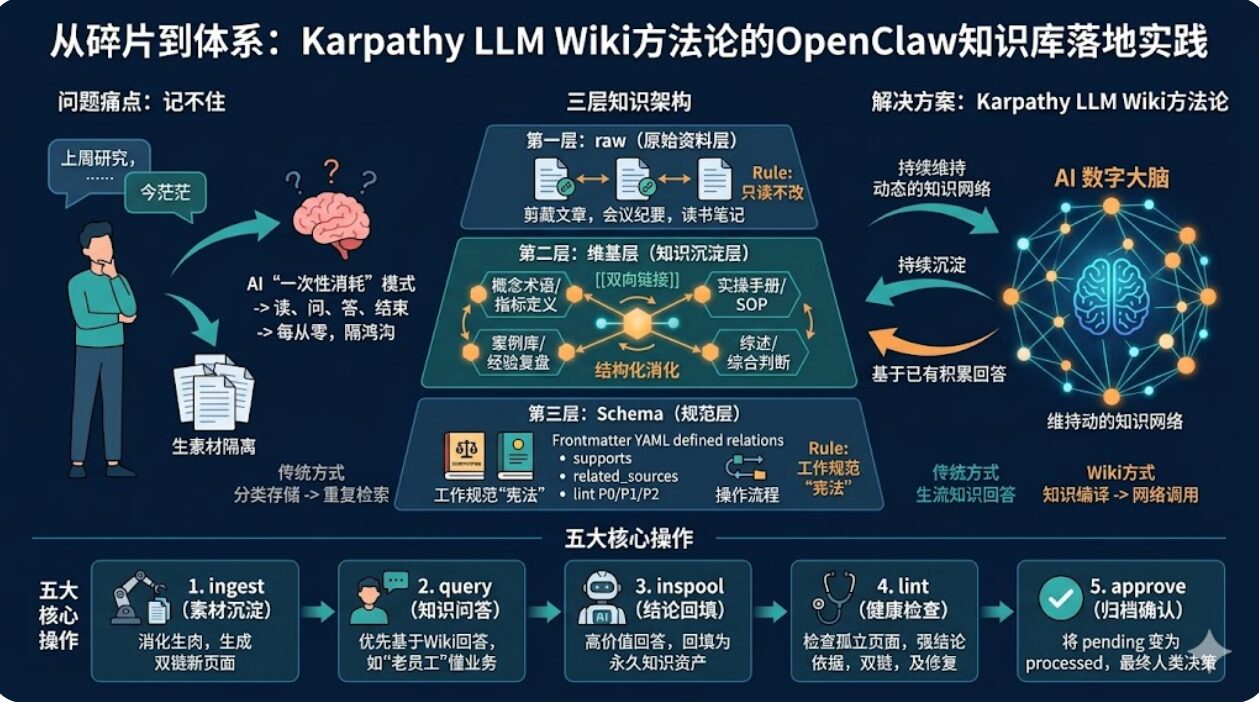
Karpathy提出的LLM Wiki方法论,正是为了打破这个循环。它的核心思想是:不要让AI每次都从原始资料重新理解,而是让AI持续维护一个介于你和原始资料之间的、可累计演化的"第二大脑"。
obsidian-wiki-maintainer技能,就是这套方法论的OpenClaw实现。
二、它是怎么工作的
这个技能构建了三层知识架构:
第一层:raw(原始资料层)
你读过的文章、剪藏的网页、会议纪要、读书笔记——所有原始内容都存放在这里。这一层的原则是只读不改,保持资料的原始面貌。
第二层:维基层(知识沉淀层)
这是整个系统的核心。AI会把raw层的内容"消化"成结构化的知识页面,包括:
- 概念术语/:平台术语、指标定义、理论基础
- 实操手册/:SOP、运营流程、话术模板
- 案例库/:实战复盘、经验总结
- 综述/:跨来源综合判断、主题分析
- 工具素材/:模板、Prompt、工具配置
关键的是,这些页面之间用双链([[双向链接]])相互连接,形成一张知识网络,而非孤立的文档孤岛。
第三层:Schema(规范层)
定义了知识库的工作规范,包括页面格式(YAML frontmatter)、关系字段(supports、contradicts、related_sources等)、操作流程等。这是维持整个系统长期健康运行的"宪法"。
三、五大核心操作
obsidian-wiki-maintainer技能提供了五个核心操作,覆盖了知识管理的完整生命周期:
1. ingest(素材沉淀)——把新知识"吃进去"
当你有新素材需要处理时(比如用Obsidian Web Clipper剪藏了一篇文章),调用ingest操作。AI会自动:
- 读取原始素材
- 提炼核心概念和关键结论
- 判断应该沉淀到哪个目录
- 创建或更新对应的知识页面
- 补充双向链接和关系字段
- 更新索引和日志
简单来说,就是把"生肉"变成"熟肉"的过程。
2. query(知识问答)——优先从"第二大脑"回答
当你有业务问题时,调用query操作。AI会优先从已经沉淀好的wiki页面中寻找答案,而不是去搜索引擎或者原始资料中重新检索。
这带来的改变是革命性的:AI不再是"百晓生"式的杂学专家,而是真正懂得你业务、熟悉你积累的"老员工"。
3. inspool(结论回填)——让好答案变成永久知识
有时候AI给出的回答本身就很有价值——一个综合判断、一个实战经验、一个跨来源的对比分析。这时候调用inspool操作,把这些有价值的结论回填到wiki中,让它们成为知识库的永久资产。
4. lint(健康检查)——定期体检,及早发现问题
知识库运行一段时间后,可能会出现:
- 孤立页面(创建了但没有链接出去)
- 缺少证据支撑的"强结论"
- 路径引用失效
- 双链缺失
lint操作就是知识库的"体检医生",它会扫描整个知识库,识别P0/P1/P2三个级别的问题,并给出修复建议。
5. approve(归档确认)——正式告别"生素材"
当一批素材经过ingest处理、进入pending_review状态后,需要用户确认才能正式归档。approve操作会:
- 将raw素材标记为processed
- 迁移文件位置
- 修复wiki中对该素材的旧路径引用
- 确认为用户确认归档
这一步骤的设计遵循了一个重要原则:AI可以建议,但最终决策权在人类。
四、与传统知识管理的本质区别
有人可能会问:这不就是给文档加标签、建文件夹吗?
不是。传统知识管理的本质是"分类存储",而这个技能实现的是"知识编译"。
两者的核心区别在于:
传统方式:文档→文件夹→检索→回答(每次重新理解)
wiki方式:原始资料→知识沉淀→网络化索引→回答(基于已有积累)
举个例子:你读了一篇关于"京东店铺评分规则"的文章,用传统方式,你可能把它丢进"京东运营"文件夹;下次问AI"京东评分怎么算的",AI还是需要从文章中重新提取信息。
但用wiki方式,AI会:
- 从"概念术语/京东店铺评分体系.md"中直接告诉你评分构成
- 这个页面已经链接了相关的"案例库/低评分店铺优化复盘.md"
- 这些页面又链接了"实操手册/DSR提升三步法.md"
- 形成了一个完整的知识网络
你问的每一个问题,都在为这个网络添砖加瓦;每一次回答,都建立在你已有的积累之上。
五、安装方法
环境要求
- OpenClaw运行环境
- Obsidian Vault
- 支持 macOS 或 Linux
安装步骤
方法一:从源码安装
- 下载skill包(obsidian-wiki-maintainer-v1.0.0.zip)
- 解压到 OpenClaw 的 skills 目录:
unzip obsidian-wiki-maintainer-v1.0.0.zip -d ~/.openclaw/skills/- 重启 OpenClaw gateway
- 验证安装:
openclaw skills list | grep obsidian-wiki-maintainer方法二:通过OpenClaw CLI安装
openclaw skills install obsidian-wiki-maintainer配置Obsidian Vault
在你的Obsidian Vault中创建以下目录结构:
vault/
├── index.md           # 知识库导航索引
├── log.md             # 活动日志
├── raw/
│   ├── index.md       # 素材索引
│   ├── unprocessed/   # 待处理素材
│   ├── processed/     # 已归档素材
│   └── assets/        # 附件
├── 概念术语/
├── 实操手册/
├── 案例库/
├── 综述/
└── 工具素材/
初始化配置文件
在vault根目录创建index.md和log.md:
index.md:
---
title: 知识库索引
type: index
created: YYYY-MM-DD
---

# 知识库索引

最后更新:YYYY-MM-DD

## 目录结构
- [[raw/]] — 原始资料
- [[概念术语/]] — 术语定义
- [[实操手册/]] — 操作流程
- [[案例库/]] — 实战案例
- [[综述/]] — 综合分析
- [[工具素材/]] — 模板工具log.md:
---
title: 活动日志
type: log
created: YYYY-MM-DD
---

# 活动日志

> 按时间倒序记录所有知识库操作
六、调用方法
obsidian-wiki-maintainer技能通过自然语言触发,无需记忆复杂命令。
基本语法
在OpenClaw对话中,直接使用触发词:
| 操作 | 触发词示例 |
|---|---|
| 素材沉淀 | "帮我消化这批新素材"、"ingest" |
| 知识问答 | "查询一下…"、"query" |
| 结论回填 | "把这个结论回填到wiki" |
| 健康检查 | "lint一下知识库"、"做个体检" |
| 归档确认 | "approve这些素材" |
完整对话示例
用户:帮我消化一下raw/unprocessed/下的三篇文章

AI:(执行ingest操作)
## ingest报告
- 处理批次:raw/unprocessed/电商运营文章×3
- 新增页面:概念术语/转化率漏斗模型.md、综述/2026电商运营趋势分析.md
- 更新页面:实操手册/详情页优化SOP.md
- 状态变更:3个文件进入pending_review

用户:好,确认归档
AI:(执行approve操作)
## approve完成
- 归档批次:电商运营文章×3
- 文件已迁移至raw/processed/
- wiki路径引用已修复
七、使用场景举例
场景一:每日文章学习
每天读3篇行业文章,调用ingest操作让AI帮你提炼要点、自动分类到对应目录。一个月后,你的知识库里已经有了几十篇沉淀的知识,网络效应开始显现。
场景二:项目复盘
一个项目结束后,把会议纪要、文档、数据报告丢进raw/unprocessed/,调用ingest生成案例库页面。下一个类似项目开始时,问AI"之前类似项目是怎么做的",AI会从你的案例库中给你答案。
场景三:专题研究
研究一个课题(比如"医疗器械电商的合规边界"),把收集到的资料批量消化,让AI生成综述页面。随着研究深入,页面不断更新迭代,最终形成一个完整的知识体系。
场景四:定期体检
每隔一段时间(比如每月末),调用lint操作检查知识库健康度——有没有孤立页面、有没有缺证据的结论、有没有过时内容。保持知识库的长期健康。
八、实际效果
使用这个技能一段时间后,你会感受到几个明显的变化:
从"临时问答"到"知识积累":以前问AI一个问题,得到一个答案,结束;现在每个有价值的答案都可能成为知识库的永久资产。
从"重复检索"到"直接调用":以前需要反复检索同一主题的内容,现在直接问AI,AI从你已经沉淀好的wiki中给出答案。
从"个人记忆"到"组织资产":知识不再只存在于个人的大脑或笔记中,而是变成了团队共享的知识网络,新人加入可以直接查询。
从"信息孤岛"到"知识网络":通过双链和关系字段,不同知识点相互连接,形成网络效应——你发现一个概念时,会自然关联到其他相关概念。
九、适合谁用
这个技能特别适合以下场景:
- 知识工作者:需要持续积累行业知识、研究方法论
- 运营团队:需要沉淀运营经验、复用最佳实践
- 产品经理:需要建立产品知识库、沉淀用户研究结论
- 技术团队:需要维护技术文档、沉淀开发经验
- AI爱好者:希望实践Karpathy倡导的LLM Wiki方法论
如果你已经在用Obsidian管理笔记,并且希望AI能真正成为你的"第二大脑"而非"一次性问答机器",这个技能值得一试。
十、总结
obsidian-wiki-maintainer技能的核心价值,可以用一句话概括:让AI从"回答问题"升级为"维护知识"。
它不是另一个"更智能的笔记工具",而是一套让知识持续沉淀、不断演化、长效积累的工作流。通过ingest、query、inspool、lint、approve五个核心操作,覆盖了知识管理的完整生命周期。
在AI能力飞速发展的今天,我们不缺"聪明的AI",缺的是"懂你的AI"。而"懂你"的前提,是你愿意花时间去"教它"——这个技能,就是那个让"教学"变得系统化、自动化、持续化的工具。
让知识不再是一次性的消耗品,而是可以不断复利的资产。这是Karpathy LLM Wiki方法论的核心思想,也是obsidian-wiki-maintainer技能希望帮你实现的目标。