
SkillSpector 是 NVIDIA 开源的 AI Agent 技能安全扫描器,通过静态分析 + LLM 语义评估,可检测 64 种漏洞模式(覆盖 16 个类别)。研究显示 26.1% 的 AI 技能存在漏洞,5.2% 显示恶意意图。本文深度解析其能力边界与落地路径。
为什么这件事值得你关注
如果你正在搭建一套 AI Agent 工作台——无论是 Claude、Cursor、还是类似 OpenClaw 这样的 Skill 驱动架构——那你大概率已经安装过几十甚至上百个第三方 Skill(SKILL.md)。这些 Skill 在你的系统里通常享有隐式信任:它们能读你的文件、能跑你的命令、能调你的 API。
问题来了:这些 Skill 安全吗?
NVIDIA 给出的答案是:不安全。他们的扫描数据显示:
- 26.1% 的 AI 技能存在漏洞
- 5.2% 直接表现出恶意意图
- 可执行脚本的漏洞率是非可执行脚本的 2.12 倍
也就是说:你每装 4 个 Skill,就大约有 1 个是有问题的。
SkillSpector(GitHub: NVIDIA/SkillSpector)就是 NVIDIA 为这个问题专门打造的扫描器。发布首日即拿下 GitHub Trending,今日星数已达 804。下面我们把它拆开看。
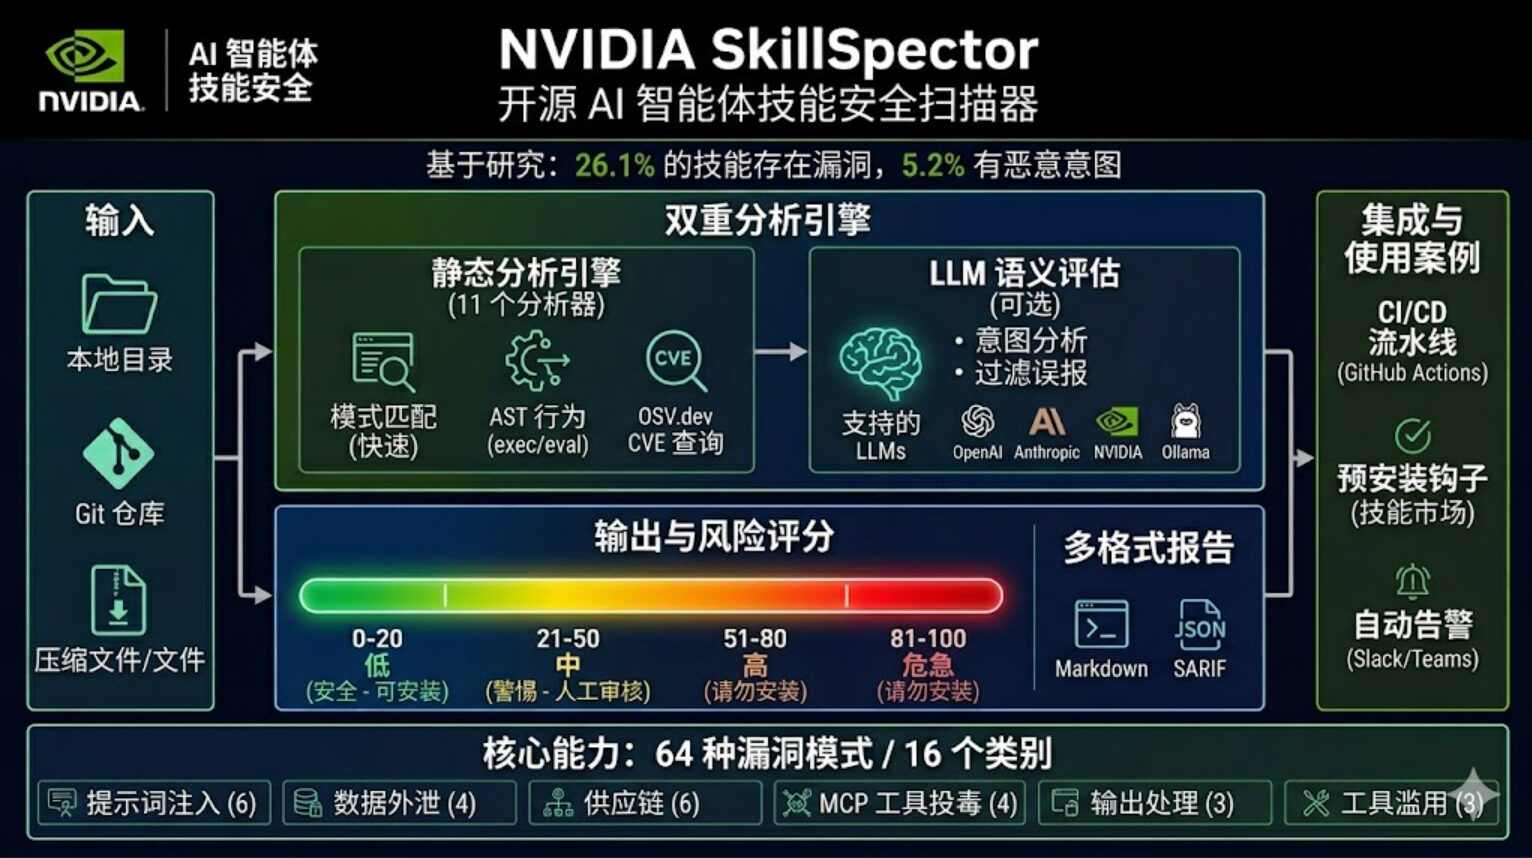
SkillSpector 是什么
简单来说,SkillSpector 是一款专门针对 AI Agent 技能(Skill)的安全审计工具。它能扫描一个 Skill 目录或 Git 仓库,给出 0-100 的风险评分,并告诉你漏洞在哪、为什么危险、该如何修复。
它和普通的代码扫描器(比如 Snyk、Semgrep)不一样的地方在于:SkillSpector 的规则库是围绕 AI Agent 场景专门设计的,覆盖了传统工具根本检测不到的 AI 特有风险——比如提示词注入、记忆污染、MCP 工具投毒。
核心能力:64 种漏洞模式 + 16 个类别
SkillSpector 的规则库是目前公开工具里最完整的 AI Skill 安全规则集,覆盖以下 16 个类别:
| 类别 | 模式数 | 代表性漏洞 |
|---|---|---|
| 提示词注入 (Prompt Injection) | 6 | 指令覆盖、隐藏指令、行为操纵 |
| 数据外泄 (Exfiltration) | 4 | 环境变量收割、上下文外传 |
| 权限提升 (Privilege Escalation) | 3 | 过度权限、sudo/root 执行 |
| 供应链安全 (Supply Chain) | 6 | 未固定依赖、远程代码执行 |
| 过度代理 (Excessive Agency) | 4 | 无限制工具访问、自主决策 |
| 输出处理 (Output Handling) | 3 | 未验证输出注入、跨上下文输出 |
| 系统提示泄露 (System Prompt Leakage) | 3 | 直接泄露、间接提取 |
| 内存污染 (Memory Poisoning) | 3 | 持久化上下文注入、内存操纵 |
| 工具滥用 (Tool Misuse) | 3 | 参数滥用、链式滥用 |
| 危险代码 AST (Dangerous Code AST) | 8 | exec/eval/subprocess 调用 |
| 污点追踪 (Taint Tracking) | 5 | 直接污点流、凭证外泄链 |
| YARA 签名 (YARA Signatures) | 4 | 恶意软件匹配、加密货币挖矿 |
| MCP 最小权限 (MCP Least Privilege) | 4 | 能力未声明、通配符权限 |
| MCP 工具投毒 (MCP Tool Poisoning) | 4 | 隐藏指令、Unicode 欺骗 |
最后两个 MCP 相关类别尤其值得关注——MCP(Model Context Protocol)是 Anthropic 推出的 Agent 工具协议,正在被 Claude Desktop、各类 Agent 框架广泛采用。SkillSpector 是目前唯一把 MCP 投毒这类 AI 特有风险纳入规则库的公开工具。
两大分析引擎:静态扫描 + LLM 语义
SkillSpector 的分析流程分两阶段,可以单独使用,也可以组合:
1. 静态分析引擎(11 个静态分析器)
- 正则模式匹配:快速识别已知漏洞签名
- AST 行为分析:解析 Python 抽象语法树,检测
exec、eval、subprocess等危险调用 - OSV.dev CVE 实时查询:检查依赖项是否有公开漏洞,离线时自动降级到本地缓存
优点:速度快,召回率高,几乎不漏报。
2. LLM 语义评估(可选)
- 上下文理解和意图分析:判断 Skill 是否在"假装无害"
- 误报过滤:精度提升至约 87%
- 支持多种后端:OpenAI、Anthropic、NVIDIA、Ollama(本地模型)
两阶段组合的好处很明显:先用静态扫描过一遍所有候选(快),再用 LLM 重点复审高风险项(准)。
风险评分体系:0-100 分直接告诉你能不能装
扫描完一个 Skill,SkillSpector 会给出一个 0-100 的风险分,对应四种严重性等级:
| 分数区间 | 严重性 | 建议操作 |
|---|---|---|
| 0-20 | LOW | ✅ SAFE — 可正常安装 |
| 21-50 | MEDIUM | ⚠️ CAUTION — 需要人工复核 |
| 51-80 | HIGH | 🔴 DO NOT INSTALL — 拒绝安装 |
| 81-100 | CRITICAL | 🔴 DO NOT INSTALL — 立即告警 |
这个评分可以直接接到 CI/CD 流水线或者 Skill 安装流程里,作为「能不能装」的硬性判断条件。
支持多种输入输出
输入支持几乎覆盖了所有常见来源:
- 本地目录(直接
scan ./my-skill/) - Git 仓库 URL(
scan https://github.com/user/my-skill) - 压缩包(zip)
- 单个文件
输出格式也考虑到了不同使用场景:
- Terminal:直接打印风险点和修复建议
- JSON:给程序解析
- Markdown:生成可读的扫描报告
- SARIF:直接集成到 GitHub Actions、GitLab CI 等流水线
实测性能数据
| 指标 | 数据 |
|---|---|
| 漏洞覆盖率 | 64 patterns × 16 categories |
| LLM 语义精度 | 约 87% |
| 静态分析召回率 | 高(大多数已知问题) |
| 静态分析精度 | 中等(少量误报,需要 LLM 二次复核) |
| CVE 查询 | OSV.dev 实时查询 + 1 小时内存缓存 |
| 可执行脚本漏洞率 | 非可执行脚本的 2.12 倍 |
最后一条特别值得注意:任何含有可执行脚本的 Skill,风险都明显更高。如果你的 Skill 体系允许用户上传 .sh / .py 脚本,这个数据应该成为你安全策略的硬性约束。
两种部署方式
方式一:源码安装(推荐)
git clone https://github.com/NVIDIA/SkillSpector.git
cd SkillSpector
uv venv .venv && source .venv/bin/activate
make install
方式二:Docker 一键启动
如果你不想折腾 Python 环境,Docker 镜像一行命令就能跑:
docker build -t skillspector .

# 静态扫描(快,无 LLM 调用)
docker run --rm -v "$PWD:/scan" skillspector scan ./my-skill/ --no-llm

# 完整扫描(静态 + LLM 语义)
docker run --rm -v "$PWD:/scan" --env-file .env skillspector scan ./my-skill/
配置 LLM 后端
SkillSpector 支持多种 LLM 后端,本地有 Ollama 的话直接对接:
# OpenAI
export SKILLSPECTOR_PROVIDER=openai
export OPENAI_API_KEY=sk-...

# Anthropic
export SKILLSPECTOR_PROVIDER=anthropic
export ANTHROPIC_API_KEY=sk-ant-...

# Ollama(本地模型,无云端费用)
export SKILLSPECTOR_PROVIDER=openai
export OPENAI_BASE_URL=http://localhost:11434/v1
export SKILLSPECTOR_MODEL=llama3.1:8b
常用扫描命令速查
skillspector scan ./my-skill/                          # 完整扫描
skillspector scan ./my-skill/ --no-llm                 # 仅静态扫描(秒级返回)
skillspector scan ./my-skill/ --format json --output report.json
skillspector scan https://github.com/user/my-skill     # 直接扫 Git 仓库
横向对比:SkillSpector 强在哪
| 项目 | 多输入 | 风险评分 | LLM 语义 | CVE 实时 | 适用场景 |
|---|---|---|---|---|---|
| NVIDIA SkillSpector | ✅ | ✅ 0-100 | ✅ | ✅ OSV.dev | AI Agent 技能审计 |
| toolsio audit | ✅ | ❌ | ❌ | ❌ | 通用代码审计 |
| Snyk | ✅ | ✅ | ❌ | ✅ | 依赖漏洞扫描 |
| Semgrep | ✅ | 部分 | ❌ | ❌ | 静态代码分析 |
| GuardDog | ❌ | ❌ | ❌ | ✅ | PyPI 包扫描 |
SkillSpector 的独特优势在于:它是目前唯一同时具备「64 个 AI 场景 pattern + LLM 语义评估 + 实时 CVE 查询」的工具。其他工具要么没有 AI 特有规则,要么没有 LLM 语义层,要么没有评分体系——SkillSpector 是把这些都整合起来的第一款。
对 AI Agent 团队的实战建议
如果你正在运营一套 AI Agent 工作台(无论是面向内部团队还是对外开放 Skill 市场),建议按以下四步落地:
Phase 1:基线扫描
先用 SkillSpector 对所有已安装的 Skill 执行一次全量扫描,建立风险基线数据。按评分分级管理:
- LOW(0-20):白名单,自动放行
- MEDIUM(21-50):灰名单,需人工复核
- HIGH/CRITICAL(51+):黑名单,立即下架
Phase 2:自动化封装
写一个 Shell 封装脚本,把 SkillSpector + Ollama 本地模型串起来,让扫描变成 scan.sh ./new-skill/ 一行命令。配合 --no-llm 静态模式做 pre-commit 钩子,把高风险 Skill 在合并阶段就拦掉。
Phase 3:安装流程集成
把扫描步骤嵌入 Skill 安装流程(pre-install hook):
- 用户请求安装某个 Skill
- 系统自动调用 SkillSpector 扫描
- 评分 ≤ 50 → 正常安装并写入审计日志
- 评分 > 50 → 阻断安装,弹窗提示风险点和修复建议
Phase 4:告警闭环
对 SARIF 输出格式进行解析,在 IM 工具(如飞书/Slack)中自动告警高风险 Skill,形成「检测 → 阻断 → 告警 → 修复」的完整闭环。
对你自己的业务有什么用
上面这套思路不只适用于 AI Agent 平台。任何接收第三方代码/脚本/插件的业务系统——WordPress 插件市场、Figma 插件生态、VS Code 扩展商店——都面临类似的"隐式信任"风险。
SkillSpector 的两阶段分析架构(快速静态 + 慢速 LLM 语义)是非常值得借鉴的模式:
- 用静态扫描覆盖 90% 已知问题(成本低、速度快)
- 用 LLM 语义复核可疑项(精度高、可解释)
- 用 0-100 分评分体系统一输出(可直接接入业务规则)
- 用 SARIF 格式对接 CI/CD(无需重新实现集成层)
无论你是创业者、运营人还是开发者,在你决定"是否允许某个第三方代码进入你的系统"之前,先问一句:"我们有没有自己的 SkillSpector?"
快速参考
- GitHub 仓库:
NVIDIA/SkillSpector - 今日星数:804(GitHub Trending Top 3)
- 规则库规模:64 种漏洞模式 × 16 个类别
- LLM 精度:约 87%
- 部署门槛:Docker 一行命令,或
make install - 本地 LLM 兼容:✅ Ollama(qwen2.5、llama3.1 等)
- CI/CD 集成:✅ SARIF 输出
对于依赖大量第三方 Skill 的 AI 工作台来说,部署 SkillSpector 的 ROI 极高——一次扫描就能找出潜在的高风险 Skill,比事后补救的成本低得多。