
快速落地方法:
本文及本站大部分openclaw相关文章,都可以让Openclaw agent阅读,然后进行应用,参考Prompt如下:
请阅读这篇文章:
https://www.aiec.fun/openclaw%e5%bf%85%e5%a4%87%e5%b7%a5%e5%85%b7%ef%bc%9adarwin-skill%e8%87%aa%e5%8a%a8%e5%8c%96%e6%8a%80%e8%83%bd%e4%bc%98%e5%8c%96%e5%ae%8c%e5%85%a8%e6%8c%87%e5%8d%97/
分析有哪些内容,对我们优化工作流程有价值。并严格根据openclaw/Darwin-Skill最新官方文档进行核对,排除错误及过时信息,制定落地计划,安装和部署GBrain。详细方法,参考文章 >>>
一、项目基本信息
- 项目名称:达尔文.skill (darwin-skill)
- 作者:alchaincyf
- GitHub 地址:https://github.com/alchaincyf/darwin-skill
- 核心定位:像训练模型一样优化你的 Agent Skills,将自主实验循环从模型训练搬到 Skill 优化领域
- 支持平台:Claude Code、Codex、OpenClaw、Trae、CodeBuddy 等所有支持 SKILL.md 格式的 Agent 工具
本文所有内容均基于项目官方 README.md 和 SKILL.md 文件整理,关键信息已标注来源。
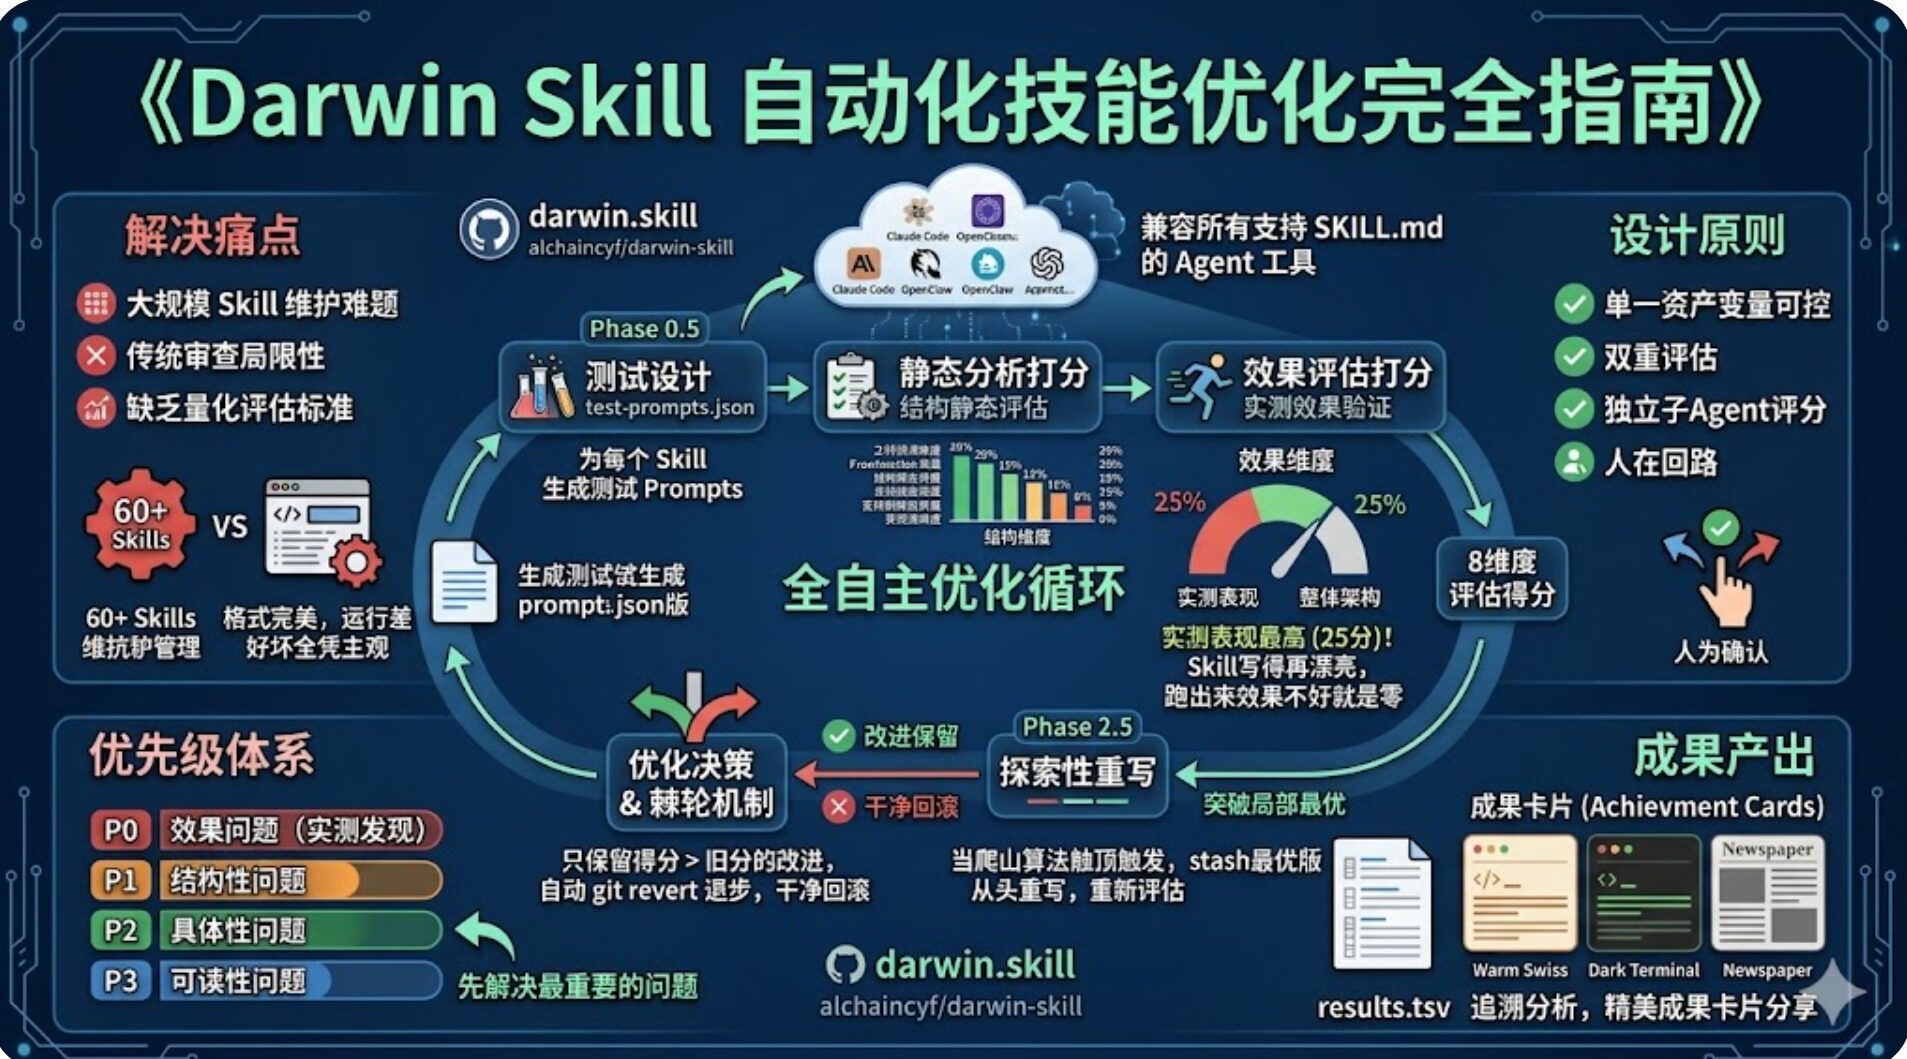
二、核心作用与解决的痛点
1. 核心作用
Darwin Skill 是一个自动化的 Agent Skill 优化系统,它通过自主实验循环不断改进 SKILL.md 文件的质量,同时评估结构合规性和实际运行效果,只保留真正有价值的修改。它就像一个 "技能训练师",让你的 AI 技能越用越好。
2. 解决的核心痛点
随着 Agent 生态的快速发展,越来越多的用户开始使用各种 Skill 来扩展 AI 的能力。但随之而来的是一系列问题:
- 大规模 Skill 维护难题:
当你只有 10 个 Skills 时,手动维护还能应付;但当你有 60 + 个 Skills 时,手动检查和优化变得几乎不可能(来源:README.md) - 传统审查的局限性:
传统的 Skill 审查只检查格式是否正确、步骤有没有编号、路径能不能访问。但一个格式完美的 Skill,实际运行效果可能很差(来源:README.md) - 缺乏量化评估标准:
没有统一的、可量化的 Skill 质量评估体系,好坏全凭主观感受 - 改进无法有效保留:
手动修改 Skill 时,经常出现 "改坏了又改回来" 的循环,无法稳定积累进步
三、设计理念与核心机制
1. 设计灵感来源
Darwin Skill 直接受 Andrej Karpathy 的 autoresearch 项目启发,将 "只保留可测量的改进,其余全部回滚" 的核心机制从代码优化领域移植到 Skill 优化领域。两者的映射关系如下(来源:README.md):
2. 五条核心原则
Darwin Skill 的整个系统设计都围绕这五条原则展开(来源:README.md):
- 单一可编辑资产:每次只改一个 SKILL.md,变量可控,改进可归因
- 双重评估:结构评分 (静态分析)+ 效果验证 (跑测试看输出)
- 棘轮机制:只保留改进,自动回滚退步,分数只升不降
- 独立评分:评分用子 agent,避免 "自己改自己评" 的偏差
- 人在回路:每个 Skill 优化完后暂停,用户确认再继续下一个
3. 8 维度评估体系
项目采用 8 维加权总分制 (满分 100 分),其中结构维度 6 项,效果维度 2 项(来源:README.md)。
注意:README 原文存在数字不一致问题:README 中提到 "结构维度 60 分 (静态分析),效果维度 40 分 (必须实测)",但实际列出的 8 个维度加总为 95 分:
- 结构维度 (6 项,合计 55 分):
- Frontmatter 质量:8 分
- 工作流清晰度:15 分
- 边界条件覆盖:10 分
- 检查点设计:7 分
- 指令具体性:15 分
- 资源整合度:5 分
- 效果维度 (2 项,合计 40 分):
- 整体架构:15 分
- 实测表现:25 分
实测表现权重最高 (25 分),明确提出 "Skill 写得再漂亮,跑出来效果不好就是零"(来源:README.md)。完整的 8 个维度名称和具体权重定义记录在项目的 SKILL.md 文件中,README.md 仅做了摘要性介绍。
4. 完整的优化循环
系统将优化过程分为 5 个主要阶段,在每个阶段内自主运行,但在阶段之间暂停等待人类确认(来源:SKILL.md)。
特别补充:Phase 0.5 测试 Prompt 设计阶段(核心前置步骤)
在正式评估前,系统会先为每个 Skill 设计 2-3 个测试 prompt,覆盖典型用户场景和稍有歧义的场景,保存为{skill目录}/test-prompts.json。这是 "实测表现" 维度打分的前提,没有测试用例就无法进行效果验证。
Phase 2 核心优化循环:
- 找出得分最低的维度
- 针对该维度生成 1 个具体改进方案
- 编辑 SKILL.md 并 git commit
- 子 agent 独立重新评分
- 新分 > 旧分→保留;否则→git revert
- 每个 Skill 完成后暂停,展示 diff + 分数变化,等用户确认
特别补充:Phase 2.5 探索性重写(解决局部最优的关键)
当爬山算法连续 2 个 Skill 在第一轮就触顶(分数涨不动)时,系统会触发探索性重写机制:
- git stash 保存当前最优版本
- 从头重写整个 SKILL.md(不是微调)
- 重新评估后比较两个版本,决定保留哪个
这是 Darwin Skill 能够突破局部最优、实现质的飞跃的关键设计。
5. 棘轮机制详解
分数只能上升。每一轮要么改进 Skill,要么干净地回滚。不会随时间积累局部退化(来源:README.md)。
例如:轮次 2 的 75 分低于当前最优的 78 分,会被自动回滚,有效基线始终锁定在 78,后续改进从 78 继续。
6. 优化策略库(P0-P3 优先级体系)
系统内置了完整的优化策略优先级,确保先解决最重要的问题(来源:SKILL.md):
7. 6 条严格的约束规则
为了保证优化不会改变 Skill 的核心功能,系统规定了严格的约束(来源:SKILL.md):
- 不改变 skill 核心功能 — 只优化 "怎么写" 和 "怎么执行",不改 "做什么"
- 不引入新依赖 — 不添加 skill 原本没有的 scripts 或 references
- 每轮只改一个维度 — 避免多变更无法归因
- 文件体积不超过原始 150%
- 尊重花叔风格 — 中文为主、简洁为上
- 可回滚 — 用 git revert 而非 reset –hard
8. 8 种异常与边界条件处理
为了保证优化流程不会卡死,SKILL.md 详细定义了 8 种异常场景的处理规则(来源:SKILL.md):
9. 成果卡片与日志系统
- 成果卡片生成:优化完成后,系统会生成精美的视觉成果卡片,支持 3 种风格:Warm Swiss(暖白底 + 赤陶橙)、Dark Terminal(近黑底 + 荧光绿)、Newspaper(暖白纸 + 深红)(来源:SKILL.md)
- results.tsv 日志系统:系统会记录完整的优化过程,包含 timestamp、commit、skill、old_score、new_score、status、dimension、note、eval_mode 等 9 列信息,方便追溯和分析(来源:SKILL.md)
四、安装与使用方法
1. 在线安装 (推荐)
npx skills add alchaincyf/darwin-skill2. 离线安装 (无法访问 GitHub 时)
- 下载项目 zip 包:darwin-skill.zip
- 解压后根据你使用的平台,将 SKILL.md 放到对应目录:
- Claude Code 用户:
~/.claude/skills/darwin-skill/(来源:README.md) - OpenClaw 用户:
~/.openclaw/skills/darwin-skill/(基于 OpenClaw 官方目录结构的合理推断,darwin-skill 项目未提供官方说明)
- Claude Code 用户:
3. 使用方法
安装后在任何支持 Skill 的 Agent 工具中,直接说:
- "优化所有 skills"
- "优化某个 skill (如:优化 web-search-skill)"
五、在 OpenClaw 中部署的价值
1. 高度兼容性
OpenClaw 完全支持 SKILL.md 格式,Darwin Skill 在 README.md 中列举了包括 OpenClaw 在内的多个支持平台,因此可以无缝部署。
2. 解决 OpenClaw 生态的核心痛点
- OpenClaw 的 Skill 生态正在快速发展,用户安装的 Skill 数量会迅速增长
- 目前 OpenClaw 社区的 Skill 质量参差不齐,很多 Skill 格式正确但实际效果差
- 缺乏统一的 Skill 质量评估和优化工具
3. 具体价值点
- 提升现有 Skill 质量:通过自动化迭代,将用户已安装的 Skill 从 "能用" 提升到 "好用"
- 降低维护成本:自动处理 Skill 的日常优化和 bug 修复,减少用户手动修改的工作量
- 建立质量标准:8 维度评估体系为 OpenClaw 社区提供了统一的 Skill 质量衡量标准
- 加速生态发展:让开发者可以快速迭代自己的 Skill,提高整个生态的质量
- 保留用户控制权:人在回路机制确保用户可以审核每一个修改,避免出现意外问题
六、可能的风险与缺陷
1. 资源消耗风险
- Token 消耗大:需要子 agent 进行独立评分,每次优化循环都会产生额外的 token 费用
- 时间成本高:每次只改一个 SKILL.md,且需要实测验证效果,优化一个 Skill 可能需要多轮循环,耗时较长
- 计算资源占用:运行测试用例需要调用 Agent 执行实际任务,会占用计算资源
2. 机制设计缺陷
- 人在回路降低自动化程度:虽然保证了质量,但也意味着无法完全无人值守运行
- 评估体系的主观性:8 维度的权重分配是作者设定的,是否适用于所有类型的 Skill 还需要验证
- 过拟合风险:优化可能过度适应 test-prompts.json 中的测试用例,导致在其他场景下效果下降
- 单一修改限制:每次只改一个维度,可能无法解决需要多维度协同改进的问题
3. 技术依赖风险
- 依赖 Git:需要用户环境配置 Git 才能实现版本控制和回滚功能
- 依赖子 Agent:评分和修改生成都依赖 Agent 的能力,如果基础 Agent 能力不足,优化效果会大打折扣
- 测试用例质量依赖:优化效果直接取决于 test-prompts.json 的质量,如果测试用例不全面,可能会遗漏重要问题
4. 潜在的兼容性问题
- 虽然理论上支持所有 SKILL.md 格式的工具,但不同工具对 SKILL.md 的解析可能存在细微差异
- 某些特殊格式的 Skill 可能无法被正确解析和优化
七、综合评判
Darwin Skill 是一个极具创新性和实用价值的 Agent 工具,它首次将模型训练中的自主实验循环思想应用于 Skill 优化领域,解决了 Agent 生态发展中 Skill 质量参差不齐和维护困难的核心痛点。
对于 OpenClaw 用户来说,部署 Darwin Skill 的收益远大于风险:
- 高收益:可以显著提升现有 Skill 的实际效果,降低维护成本,加速 Skill 迭代
- 可控风险:人在回路机制确保用户可以控制整个过程,避免出现不可挽回的问题
- 低门槛:安装和使用都非常简单,不需要复杂的配置