
如果你让 AI 助手读代码,它大概率会给你一个听起来很有道理的答案——然后你花半小时翻源码,发现它把某个函数的作用猜错了。这不是模型不够聪明,而是检索方式本身在丢信息。
Graphify 的官方定位一句话就能说清:"Turn any codebase, with its docs, SQL schemas, configs, and PDFs, into a queryable knowledge graph"——把代码库连同文档、SQL 表结构、配置文件甚至 PDF,一起变成一张能用自然语言查询的知识图谱。
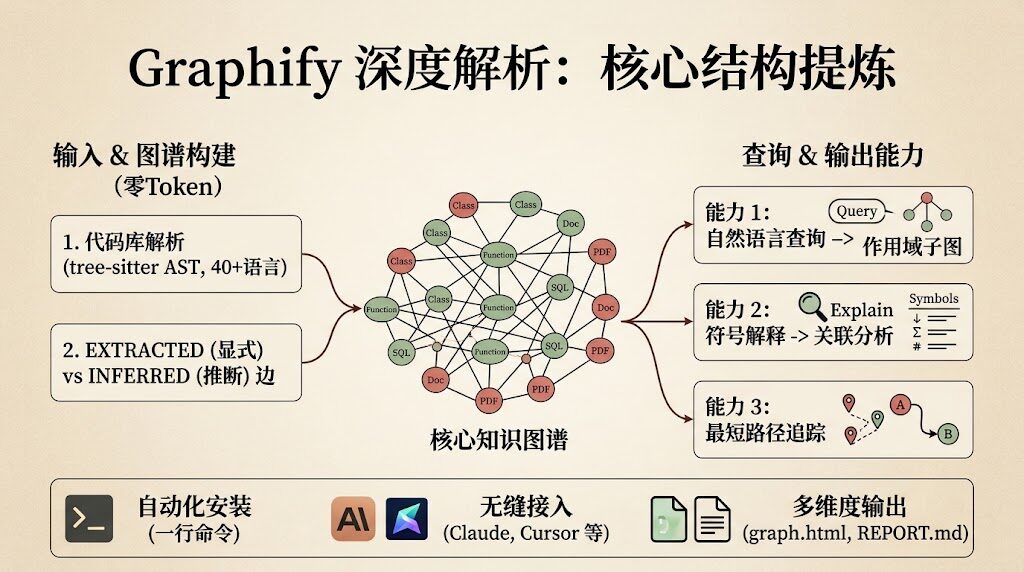
一、核心价值主张:检索,不是猜测
大多数 AI 代码工具走的是向量检索路线:把代码切成片段,转成 embedding 存进向量库,提问时捞回最相似的几段塞给模型。这套流程的问题是,相似不等于正确,模型最后生成的那句话和代码真实逻辑之间隔着一层概率。
Graphify 换了一条路:建图谱,然后遍历图谱。
作者自己的说法是「Every edge is explained」——图谱里的每一条边都能说清楚它是怎么来的。这听起来像是技术吹嘘,但看完全部设计你会发现,它确实是围绕"可解释"这一件事设计的。
二、核心技术架构
2.1 tree-sitter AST 解析:确定性、零 LLM
代码文件交给 tree-sitter 解析成抽象语法树(AST)。如果你不熟这个概念,可以简单理解成:编译器的第一步就是把代码变成一棵结构化的树,函数、类、参数、调用关系全在树上,不含任何模糊语义。
基于这棵树,Graphify 把函数、类、调用、导入、继承、Mixin 这些关系全部结构化提取出来,支持 40 多种编程语言。
关键点在这里:这一步是确定性的,不调用大语言模型。同一个代码库跑两次,结果完全一样。
零 token 消耗构建图谱——这在 2025 年之后是个相当能打的卖点,因为绝大多数竞品按 token 计费构建索引,你数据越多,前期成本越高。
2.2 EXTRACTED vs INFERRED 双重标注
这是我认为整个项目最值得学的设计。
图谱里每一条边(edge)都带来源标注,分两类:
- EXTRACTED:代码里显式写出来的。比如 A 文件 import 了 B、A 类继承了 B 类、A 调用了 B 函数——这种关系是明摆着的,直接提取。
- INFERRED:通过分析推断出来的。比如根据类型推导、上下文关联判断 A 很可能依赖 B,但代码里没有明写。
为什么要分这么细?因为 AI 工具最让人抓狂的就是幻觉。它说 A 依赖 B,你分不清是它真的读到了 import 语句,还是它猜的。有了这个标注,你在看结果时可以一眼分辨:标 EXTRACTED 的是事实,标 INFERRED 的是推断。
作者把这句话写成了产品原则:Every edge is explained。
2.3 图谱查询三大能力
| 命令 | 能力 | 通俗解释 |
|---|---|---|
| graphify query "你的问题" | 返回作用域子图 | 用大白话问,它把相关的那块图捞出来给你 |
| graphify explain "某个符号" | 解释任意符号 | 给它一个函数名,它告诉你这个符号是什么、和谁连着 |
| graphify path A B | 追踪 A 到 B 的最短路径 | 问"这两个东西怎么扯上关系的",它给出一条路径 |
三个命令分别对应三个真实痛点:我想理解某块功能(query)、我想搞懂一个看不懂的名字(explain)、我想知道两个看起来没关系的东西怎么串起来(path)。
2.4 输出三件套:图谱即产品
跑完之后会生成一个目录:
graphify-out/
├── graph.html         # 交互式图谱,浏览器打开,可点击节点、过滤、搜索
├── GRAPH_REPORT.md    # 高亮报告:关键概念、意外关联、建议问题
└── graph.json         # 完整图谱数据,随时查询,无需重读源文件
这里有个很聪明的设计选择:直接产出一个能在浏览器打开的交互式 HTML。
这意味着你不需要懂命令行,也能拿到一张可以点开看的代码关系图。对非技术的人来说,这张图本身就是能交付的产品——你可以把它发给同事看,也可以塞进文档里。多数同类工具只给一个命令行输出或者 JSON,没有可视化交付物。
2.5 非代码文件也能进同一张图谱
代码之外,文档、PDF、图片、视频走另一条路:调用模型做语义处理,再统一映射进同一张图谱。
所以代码部分是完全本地的(tree-sitter,纯本地零成本),文档部分可以配 API Key。这是一个务实的分工——确定性的部分不花钱,需要语义理解的部分才花钱。
2.6 安装:一行命令接进你现有的 AI 工具
uv tool install graphifyy
graphify install
第二条命令会自动检测你机器上的 AI 助手并注册对应 skill,装完之后直接在助手里输入:
/graphify .官方列出的支持平台包括 Claude Code、Cursor、Codex、Gemini CLI、GitHub Copilot 等 20 多个——基本上主流的 AI 编程工具都覆盖了。官网是 graphify.com,文档在 docs.graphify.com。
三、基准测试:数字说话
作者公开了一组基准测试,并且采用了双盲评分方法(两位评审独立打分,90.6% 一致性,Cohen's kappa 0.81),这个方法论在开源项目里不常见,也是可信度加分项。
| 基准项目 | Graphify | 表现对比 |
|---|---|---|
| LOCOMO recall@10 | 0.497 | mem0 为 0.048,supermemory 为 0.149,约 10 倍于竞品 |
| LOCOMO QA 准确率 | 45.3% | supermemory 为 49.7%,接近最优 |
| LongMemEval QA 准确率 | 76% | 与 dense RAG 持平 |
| ERPNext 关键事实覆盖率 | 82.0% | grep/read 为 70.8%,明显更高 |
| 图谱构建 LLM 费用 | 0 | 其他方案按 token 计费 |
怎么读这组数字:召回率(recall@10)上是压倒性优势——能找回 10 倍于竞品的信息量。问答准确率上略逊于最优的 supermemory,但差距不大。长期记忆和传统 RAG 打平。ERPNext 那项是最有说服力的,因为它衡量的是真实业务系统的事实覆盖率。
最后一行是护城河:构建成本为零。
四、和传统 RAG 的对比:什么时候值得换
如果你正在用向量检索做代码问答,这张表可以帮你判断要不要试:
| 维度 | 向量检索(RAG) | Graphify 图谱 |
|---|---|---|
| 结果确定性 | 相似度打分,有概率性 | AST 解析,结构化确定 |
| 关系表达 | 只有语义相似,没有调用链 | 显式记录调用、继承、导入 |
| 结果溯源 | 难判断是读到还是猜的 | 每条边标 EXTRACTED / INFERRED |
| 跨文件路径 | 需要人自己串联 | path 命令直接给路径 |
| 构建成本 | 按 token 计费 | 代码部分为零 |
| 非代码文件 | 一样要 embedding | 走模型语义处理后入同一图谱 |
五、谁适合用,谁可以先不用
5.1 电商和运营场景的适用点
Graphify 的核心是"让 AI 准确理解一整套系统",这个能力对电商业务有直接的迁移空间:
- 多系统串联排查:你的 ERP、订单系统、库存系统、客服工单之间的调用关系,本质上就是一张图谱。哪天出问题了,不用再靠人肉翻日志对时间线。
- 业务规则沉淀:优惠券规则、退款条件、库存扣减逻辑这类散落在代码里的规则,建图之后可以直接问"满减是在哪个函数里判的",答案带来源标注。
- 新人上手成本:新人问"这个字段谁在写、谁在读",explain 一条命令就有答案,不用等老员工有空带。
- 给客户看的交付物:graph.html 是可以外发的可视化关系图,比技术文档更容易被非技术方接受。
5.2 什么时候用不上它
说实话,这几个场景建议先别折腾:
- 你只有几十行脚本:图谱的价值在于规模,小项目直接让模型读文件更快。
- 你主要读文档而非代码:代码部分是零成本优势,文档部分照样要调模型花钱。
- 你需要的是生成代码,不是理解代码:这是代码理解工具,不是代码生成工具,方向不一样。
六、五个值得借鉴的设计
看完整个项目,我认为下面五点比代码本身更有参考价值:
- 用标注解决信任问题:EXTRACTED / INFERRED 这个设计,本质是给 AI 输出加了一层可信度分级。这个思路可以直接搬到任何 AI 生成内容的产品里——标注依据来源,让使用者自己判断该不该信。
- 确定性的部分坚决不用模型:能用解析器解决的绝对不调 LLM。这不是抠成本,是把稳定性做在架构里。
- 图谱即产品:产出
graph.html这种可以直接交付的可视化,而不是只给命令行输出。这决定了非技术用户能不能用起来。 - Skill 即发行格式:
graphify install自动检测环境并注册,用户零配置。这一招比写一堆安装文档有效得多。 - 基准测试公开方法论:双盲评分、公开一致性和 kappa 系数。当一个 AI 项目愿意把自己的评测方法摊开讲,说明它对自己的结果有底气。
附:项目信息速查
| 项目 | 值 |
|---|---|
| 仓库 | Graphify-Labs/graphify |
| 官网 | graphify.com |
| 文档 | docs.graphify.com |
| 安装 | uv tool install graphifyy |
| 支持平台 | 20+(Claude Code、Cursor、Codex、Gemini CLI、GitHub Copilot 等) |