
今天的 GitHub Trending 上,一个项目格外扎眼——XiaomiMiMo/MiMo-Code,上线 9 天,星标数从 0 涨到 9,818 颗。
这是小米在 AI 编码 Agent 领域投下的重磅产品,一个用 TypeScript 写的"会自己记笔记、还会自己拆任务"的 AI 工程师。它到底强在哪?和 Claude Code、OpenClaw 比起来谁更香?今天给你一次讲透。
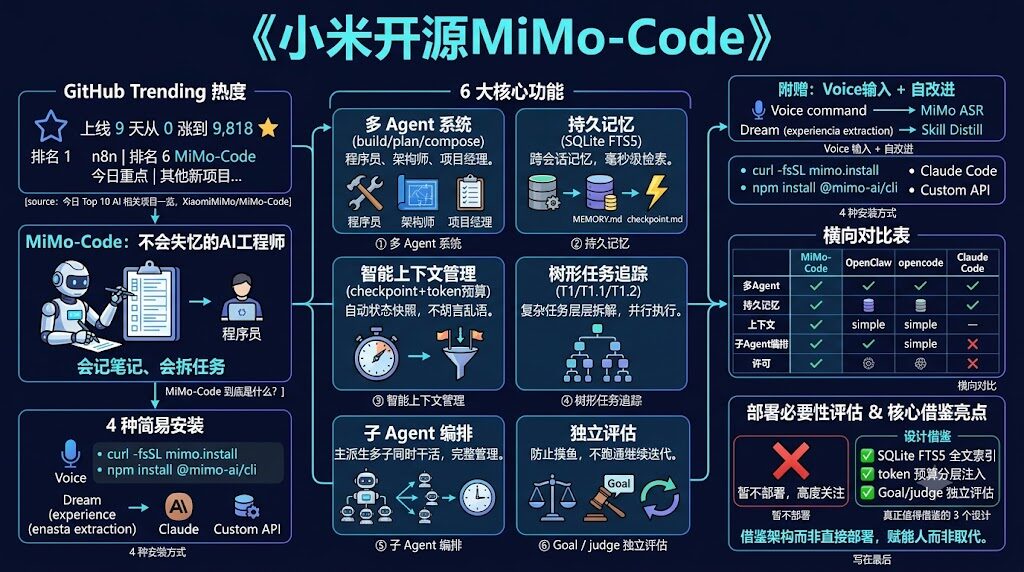
MiMo-Code 到底是什么?
在满屏的 workflow automation、Agent 框架里,MiMo-Code 杀出来只用了 9 天。它不是从零造轮子——它分支自 anomalyco/opencode,在 opencode 的基础上加了三样关键能力:持久记忆、多模式协作、自改进。
一句话定义:一个会跨会话"记笔记"、还能把任务拆成树形结构分头执行的 AI 编码 Agent。
你可以把它理解成一个"不会失忆的程序员"——普通的 AI 编码助手关掉就忘,MiMo-Code 会把所有经验写进本地的 SQLite 数据库,下次接着用。
6 大核心功能详解
① 多 Agent 系统(build / plan / compose)
MiMo-Code 内置三种 Agent 模式,分别对应不同的工作流:
- build 模式:用于开发,写代码、改 bug、跑测试一条龙
- plan 模式:用于分析,先拆任务、出方案,再动手
- compose 模式:规格驱动编排,把 specs(规格说明)和 skill(技能包)组合起来跑自动化流程
通俗讲:build 是"程序员",plan 是"架构师",compose 是"项目经理",三个人配合干活。
② 持久记忆(SQLite FTS5)
这是 MiMo-Code 最核心的差异化能力。它用 SQLite 的 FTS5(Full-Text Search 5,即内置全文搜索引擎)做跨会话记忆:
- MEMORY.md:结构化记忆文件,存重要结论、用户偏好、项目背景
- checkpoint.md:任务检查点,存阶段性进度
- FTS5 索引:让记忆搜索快如闪电(毫秒级全文检索)
对比一下:Claude Code 关掉会话就失忆,Cursor 只能记当前项目——MiMo-Code 是真的"长期记忆",跨项目、跨设备都能追溯。
③ 智能上下文管理(自动 checkpoint + token 预算)
做过大模型应用的人都知道,上下文窗口(context window,即模型一次能"看见"的最大文本量) 满了就容易"胡言乱语"。MiMo-Code 的解法:
- 自动 checkpoint:任务执行过程中自动保存状态快照,崩了能从断点继续
- token 预算(token 是大模型计费的"字"单位,1 token ≈ 0.75 个英文单词)控制:根据任务复杂度动态调整喂给模型的文本量,避免超长上下文
- 任务上下文重建:换会话后能根据 checkpoint 还原当时的工作现场
④ 树形任务追踪(T1/T1.1/T1.2)
MiMo-Code 的任务不是扁平的待办列表,而是树形结构:父任务 T1 下面可以有子任务 T1.1、T1.2,每个子任务可以继续往下分。这样做的好处是:
- 复杂任务能层层拆解
- 并行执行子任务,效率翻倍
- 追踪粒度细到每个叶子节点
⑤ 子 Agent 编排(并行 + 生命周期追踪)
主 Agent 可以派生出多个子 Agent 同时干活,子 Agent 之间能并行、可以取消、有完整的生命周期管理。这跟很多框架的"单线程执行"有本质区别。
⑥ Goal / judge 独立评估(防止 Agent"摸鱼")
MiMo-Code 有一个独立的 judge 模型,专门判断"任务是否真的完成了"。避免 AI 写完代码就报"搞定"——其实根本没跑通。这是个非常工程化的设计:
- 主 Agent 负责干活
- judge 负责评估
- 评估不通过就继续迭代
附赠:Voice 输入 + 自改进
- Voice 输入:TenVAD(语音活动检测)结合 MiMo ASR(自动语音识别),能直接用语音下命令
- Dream 自改进:任务结束后"做梦",自动把经验提取到记忆里
- Distill 打包:把重复经验打包成可复用的 skill(技能包)
4 种安装方式
MiMo-Code 的安装门槛极低,三行命令搞定:
# One-line install
curl -fsSL https://mimo.xiaomi.com/install | bash

# Or install via npm
npm install -g @mimo-ai/cli

# Run
mimo
首次启动会自动引导配置,支持 4 种接入方式:
- MiMo Auto(限时免费):匿名通道,零配置,薅羊毛窗口期
- 小米 MiMo 平台:OAuth 登录(一种授权登录协议)
- 从 Claude Code 导入:一键迁移现有认证
- 自定义 Provider:在 TUI(终端用户界面)里加任意 OpenAI 兼容 API
横向对比:和 OpenClaw、opencode、Claude Code 谁更香?
| 功能 | MiMo-Code | opencode | Claude Code | OpenClaw |
|---|---|---|---|---|
| 多 Agent 系统 | build/plan/compose | 多 provider | 不支持 | Agent 编排 |
| 持久记忆 | SQLite FTS5 | 无 | 无 | GBrain |
| 上下文管理 | 自动 checkpoint + token 预算 | 基础 | 简单 | ContextEngine |
| 子 Agent 编排 | 并行 + 生命周期追踪 | 基础 | 不支持 | sessions_spawn |
| Voice 输入 | TenVAD + MiMo ASR | 无 | 无 | TTS |
| 自改进 | Dream / Distill | 无 | 无 | 手动 |
| MCP 支持 | 支持 | 支持 | 支持 | 支持 |
| 许可 | MIT(最宽松的开源协议,可商用) | MIT | 自定义 | 商业 |
一眼看出的差距:MiMo-Code 的记忆层(SQLite FTS5)≈ OpenClaw 的 GBrain;checkpoint ≈ ContextEngine;子 Agent ≈ sessions_spawn。但 OpenClaw 的 GBrain 多了 typed links(带类型的双向链接),MiMo-Code 没有。typed links 的好处是:知识之间能形成"语义网络",比如"这篇文章引用了那段代码",可追溯、可推理——这是 MiMo-Code 目前缺失的一块拼图。
值得借鉴的 3 个设计
1. SQLite FTS5 全文索引
GBrain 目前用语义搜索(基于向量相似度),加上 FTS5 可以做"关键词+语义"双引擎:FTS5 负责精确匹配的标题、文件名、代码片段,语义搜索负责"意思相近"的概念。混合检索的准确率会显著提升。
2. token 预算分层注入
MiMo-Code 的核心思想:不把全部上下文一股脑喂给模型,而是按任务分层注入——核心信息优先(系统提示、当前任务),次要信息按需(历史对话、外部知识)。这样能用更少的 token 跑更长的任务。
3. Goal/judge 独立评估
主 Agent 干活 + judge 评估,是"防止 AI 摸鱼"的有效机制。OpenClaw 目前没有这层兜底,可以增加"任务完成度自动评估"能力。
💡 落地案例:在 OpenClaw 中借鉴 MiMo 设计
虽然我们不直接部署 MiMo-Code,但可以把它当"灵感库"。我们团队(运营+AI 工具链)规划了 3 步借鉴路径:
| 阶段 | 时间 | 动作 |
|---|---|---|
| 短期 | 1 周 | 将 MiMo 的 token budget 分层注入策略引入 ContextEngine |
| 中期 | 2 周 | 为 sessions_spawn 增加 session checkpoint(状态快照到文件) |
| 长期 | 1 个月 | 探索 GBrain + SQLite FTS5 混合索引可能性 |
你也可以用类似思路:先用别人的开源项目当"对照实验",把里面好的设计模式抽出来,嫁接到自己的工作流里。比直接"换框架"成本低得多。
写在最后
MiMo-Code 9 天破 9000 星,本质上踩中了一个真实痛点:AI 编码助手太"健忘"。Claude Code、Cursor 这些明星产品都解决不了"跨会话记忆"的问题,MiMo 用 SQLite FTS5 + 树形任务追踪给出了一个工程化答案。
但它也暴露了所有"小米系"产品的老问题:商业可持续性存疑。MiMo Auto 免费通道一旦收紧,整个生态就可能塌方。所以不直接部署,只借鉴设计,是最稳妥的策略。
对个人开发者和创业者来说,看 GitHub Trending 不是为了"追新",而是为了看趋势。哪些痛点被解决、哪些方案被验证、哪些设计值得借鉴——这才是开源世界给我们的最大红利。