
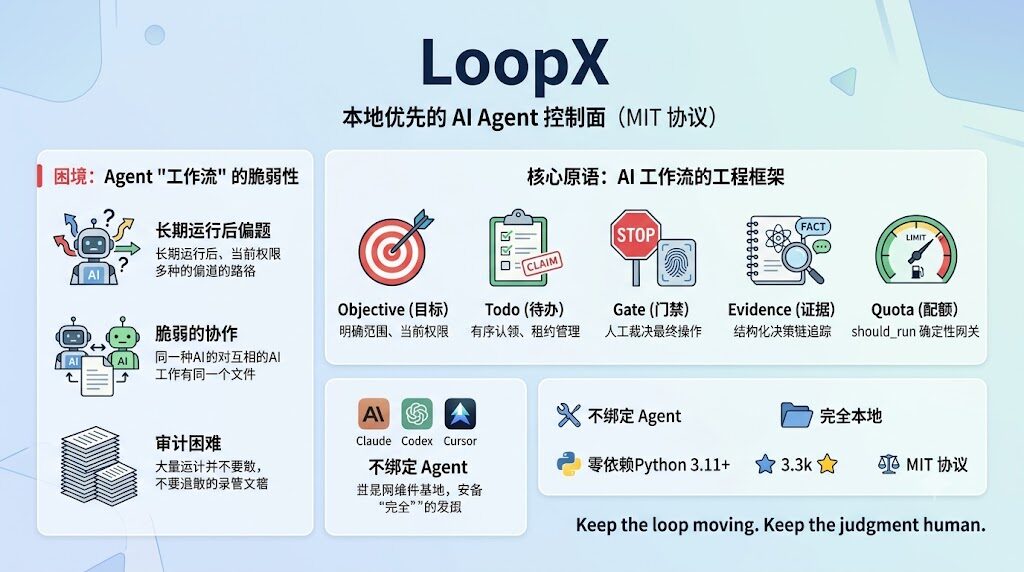
一、为什么你的 AI Agent 跑着跑着就"偏题"了?
最近两年,AI Agent 的能力像坐火箭:写代码、修 Bug、做研究、写 PPT、自动跑 ML 实验……
可一旦你真的让它长时间跑起来,就会发现一个尴尬的事实:模型挺聪明,但"工作流"特别脆弱。
典型的"翻车现场",相信不少人都遇到过:
- 场景一:你出门前让 Claude Code 帮忙"修一下这堆 issue",下班回来一看,它把无关的 5 个文件都改了一通,还给你洋洋洒洒写了 200 行"自认为正确"的代码。
- 场景二:让 Agent 跑一个 ML 实验对比,跑到第三次失败后,它直接换了一个完全不同的 baseline,自己还说"我觉得这样更合理"。
- 场景三:多人协作 / 多 Agent 协作,A 改了文件,B 不知情又把文件改回去,互相打架。
- 场景四:你想看 Agent 到底改了什么、为什么改、证据在哪 —— 它给你留了 3 GB 的对话日志,关键决策散落在第 47 轮的某个工具调用里。
这些问题的本质,其实不是模型不够强,而是没有"工作流控制面"。
LLM 本质上是个"下一刻说什么"的语言模型,它没有"任务进度"、"权限边界"、"审计追踪"这种"工程概念"。要让 Agent 像一个靠谱的远程员工那样跑 8 小时、200 小时,关键不是把它训练得更聪明,而是给它配一套和人类工程团队一样的管理流程:
- 明确"这一轮要做的事是什么、范围多大"
- 明确"什么时候需要人来拍板、什么时候可以自己干"
- 明确"我做了什么、证据在哪、谁负责"
- 明确"今天配额还有多少,能不能继续跑"
GitHub 上 3.3k Star 的开源项目 LoopX,就是为解决这个问题而生的。它的作者给它定的标语是 ——
"Keep the loop moving. Keep the judgment human." (让循环持续运转,让判断留给人。)
接下来,我们就把它拆开来看。
二、LoopX 是个啥?一句话讲明白
LoopX 是一个轻量级状态内核 + agent-agnostic 本地控制平面,专为长时运行 AI Agent 工作而设计。
翻译成人话:它是 AI Agent 的"工头 + 项目经理 + 审计员",但它不亲自干活。
更具体一点,它的核心定位有 4 个关键词:
- 状态内核(State Kernel):
把"目标 / 待办 / 门禁 / 证据 / 配额"这些数据持久化在本地磁盘上。 - Agent 中立(Agent-agnostic):
不绑定某一家的 CLI,Claude Code、Codex CLI、Codex App、OpenCode、Pi、Cursor、Shell 全都能接。 - 本地控制面(Local Control Plane):
所有状态都落在你电脑的.loopx/目录里,不需要云端账号。 - 保留人类判断(Human-in-the-loop):
危险权限、发布、生产写入、最终所有权,永远是人。
它的架构非常简洁,README 里给了一张 ASCII 图:
┌──────────────────────────────────────────────┐
│ Agent  ──▶  Capability  ──▶  Provider        │  ← 执行面
│       ▲                       │              │
│       │   Provider readback   ▼              │
│       │   Capability transition             │
│       │   Kernel                             │  ← 控制面
└──────────────────────────────────────────────┘
              ↓
       LoopX state: objective + gates + todos
+ scope + evidence + quota- Agent:通过主机 / 运行时,计划和执行一个有界动作。
- Provider:调用外部系统,返回观察结果(grep、git、API 都算 Provider)。
- Capability:定义调用方结果,把 Provider 的输出规范化成 LoopX 能理解的格式。
- Kernel:唯一拥有持久状态的部分 —— 待办、门禁、监视器、回写、配额、恢复、调度。
这种"执行面和控制面分离"的设计哲学非常重要:它不抢 Agent 的活。LoopX 自己 README 里也说得很清楚:
"LoopX 不替代你的 Agent 运行时。它只是在外面包了一层'流程壳'。"
三、五大原语:把"AI 工作流"拆成工程概念
LoopX 把长时运行 Agent 的所有"工程概念",浓缩成 5 个原语。这就是它最值钱的"思维模型"。
1. Objective(目标):让 Agent 永远知道自己要做什么
- "当前活跃的目标、显式的范围、当前的权限"。
- 一句话:把"帮我修 issue"这种模糊指令,变成"目标 GOAL-001:修复 OpenViking 的 3 个 P0 崩溃 bug;范围 =
src/cache/*;权限 = 只读 + 修改 cache 目录"。
2. Todo(待办):有序、可认领、可续约
- "有序的用户和 Agent 待办、所有权、声明(claims)、租约(leases)"。
- 每个 todo 都有明确的所有者,避免多 Agent 抢同一份代码改。
claim(认领)/update(更新)/release(释放)三个动词,就是 LoopX 的"团队协作词汇表"。
3. Gate(人工门禁):什么时候必须叫人
- "具体的人工门禁,而不是模糊的'等所有者'"。
- 一个项目要发版,要不要发?是 owner 来决定;要不要合并一个外部 PR?是 reviewer 来决定。LoopX 把这种"必须人类决策"的时刻,结构化记录成 gate,不会被 Agent 自己"自作主张"跳过。
4. Evidence(证据):你做了啥,证据在哪
- "压缩的运行历史、验证、阻塞因素、接受的回写"。
- 这是 LoopX 和普通"聊天记忆"最大的区别。它不是把对话日志贴回去,而是把每一次有效动作、验证结果、阻塞原因、写入回执,做成结构化的证据链。
loopx review-packet一条命令,就能吐出一份给 owner 看的"决策摘要 + 证据 + 未解决的门禁"。
5. Quota(配额):本次该不该跑
- "决定这一次是执行、提问、等待、自愈,还是闭嘴"。
- 这条原语最容易被忽视,但实战最有价值。LLM 没事就"自由发挥"是常态,LoopX 在每次 tick 之前问一句
should_run:今天配额够不够?风险是不是太高?跑下去是不是有意义?够不上阈值就直接 return,让 Agent 别浪费 token。
理解了这五个原语,就理解了 LoopX 90% 的价值 —— 它把"AI 写代码"这件事,强行塞进了软件工程的流程框架里。
四、LoopX 到底解决了什么?三个真实场景
光讲概念太空,我们看 LoopX 自己 README 里展示的 3 个 showcase,时间跨度都是 200+ 小时的真实项目生命周期(注意:是项目历经的墙钟时间,不是模型连续跑了 200 小时):
Showcase 1:开源 issue 修复(OpenViking 贡献序列)
作者本身是 OpenViking(也是 LoopX 文档里点名的合作项目)的贡献者。一个真实的 issue,从发现到修复到合并,跨了几周时间和几十次 LLM 互动。
没有 LoopX 时:
- 对话日志堆在某个 chat 历史里,要找"上次改到哪了"得翻半天。
- 一个 Agent 改了一半下班,第二天另一个 Agent 接着改,代码风格不一致。
- PR 评论和 LLM 推理过程完全脱节,reviewer 不知道"这段是 AI 改的,那段是 AI 觉得不行但 AI 还是改了"。
有 LoopX 后:
- 每次 issue 修复都是一个 Goal,附 scope、evidence。
- Owner 介入的时机被 Gate 显式记录。
- 跨 PR、跨 agent 的修复知识是结构化沉淀的,不是一次性 session。
Showcase 2:Auto ML Experiment(脱敏所有者运行 showcase)
机器学习实验是"AI 越权"的高发区 —— LLM 特别爱"换 baseline"、"调超参",理由还一套一套的。
LoopX 的做法:
- 把"假设、匹配的证据、失败的谱系、运行中的复现、promote/stop gate"都结构化存进 state。
- 每一步实验变更都要先过
should_run,否则记一条"被拒绝的操作",绝不执行。 - Owner 想看进展,跑
loopx review-packet,得到一份"现在跑到哪、卡在哪、该不该继续"的简报。
Showcase 3:Auto Research(多 Agent 协作研究)
最有意思的 showcase:多个 Agent 并行:
- proposer(提议者):提出研究假设。
- executor(执行者):跑实验、拿数据。
- evaluator / promoter(评审者 / 晋升者):判断证据是否足够晋升假设为结论。
LoopX 在这里扮演的是"调度员 + 审计员":
- 谁先动、谁后动,由 todo claim / lease 决定。
- 谁有权限 promote 到下一阶段,由 gate 决定。
- 跑了一晚到底得到了什么结论,由 evidence 决定。
docs/showcases/cases/0619-loopx-self-iteration.md 里还展示了一个"LoopX 自己用 LoopX 改自己代码"的迭代过程 —— 这其实就是"循环工程(loop engineering)"这个新范式的活样本。
五、和"类似项目"对比:LoopX 在哪一层?
很多人会问:"这不就是个任务调度系统吗?" "和 LangGraph、AutoGen、Claude Code 自带的 /loop 比有啥区别?" 我们一个个看:
| 项目 | 定位 | 解决的核心问题 | 与 LoopX 的差异 |
|---|---|---|---|
| LangGraph / LangChain | LLM 工作流编排框架 | 用图结构描述"调用哪个模型、下一步走哪个分支" | 它关心的是单次执行的 DAG;LoopX 关心的是跨多次执行的状态延续。LangGraph 不管你跑完一晚后状态怎么恢复,LoopX 管。 |
| AutoGen / CrewAI | 多 Agent 协作框架 | 让多个 Agent 互相对话、扮演角色 | 它关心的是角色对话协议;LoopX 关心的是持久化任务状态 + 权限边界。LoopX 更"工程化",AutoGen 更"聊天化"。 |
| Claude Code 原生 /loop | Claude Code 内置定时循环 | 让 Claude 反复读取同一个 prompt | 它的循环没有"目标感",跑久了不知道"做完了没";LoopX 包住它("Native /loop gated by LoopX"),用 gate / evidence / quota 给 /loop 加守门员。 |
| Codex CLI /goal | Codex 自己的目标模式 | 让 Codex 自主判断完成度 | 它是 LLM-driven 的"判断完成",LoopX 强调deterministic(确定性)控制面,不靠 LLM 决定要不要继续。这两者在哲学上正好相反。 |
| n8n / Airflow / Temporal | 通用工作流调度 | 长跑任务的可靠执行 + 重试 + 状态恢复 | 它们是生产级任务编排,但假设 worker 是代码;LoopX 假设 worker 是 Agent。Agent 比传统 worker 多了"会乱改东西、会自作主张"的风险,所以 LoopX 加了 gate、scope、human-in-the-loop 这些 Agent 特有的原语。 |
| 传统 issue 跟踪(GitHub Issues / Jira) | 任务记录 | 让人追踪"谁负责、做到哪" | 它们假设执行者是人;LoopX 假设执行者是 Agent,所以证据链、quota、should_run 这些概念才成立。 |
总结一句:
LangGraph / AutoGen 这类是"AI 工作流的运行时",LoopX 是"AI 工作流的工头";Claude Code
/loop是"循环开关",LoopX 是"循环开关上的看门人 + 审计员 + 调度员"。
它的不可替代性在于:当 AI Agent 开始跨天、跨 PR、跨 Owner 协作时,你需要的不是更聪明的 Agent,而是一套不依赖模型智力的"工程脚手架"。LoopX 把这件事做到了本地、轻量、可审计。
六、硬件 / 平台要求:门槛非常低
这是 LoopX 非常"用户友好"的一面 —— 几乎不挑机器。
1. 操作系统
- ✅ macOS(推荐)
- ✅ Linux(推荐)
- ❌ Windows 原生不支持(需要 WSL2 或 Git Bash + 类 Unix 工具)
官方明确说:需要 macOS 或 Linux shell,外加 curl 和 tar。
2. 语言与依赖
- Python 3.11+(唯一运行时依赖)
- 零运行时第三方依赖(除标准库外)
这意味着:装一个 Python 3.11 就能跑 LoopX,不会污染你的依赖环境。
3. 存储
- 状态目录
.loopx/在项目根目录,典型大小几 MB 到几十 MB(取决于你跑了多少 evidence)。 - 默认被
.gitignore忽略,不会污染你的仓库。
4. 网络
- 初次安装需要联网(GitHub raw 脚本 + 克隆仓库)。
- 之后完全离线工作,所有状态都是本地文件。
5. 配套的 AI Agent
LoopX 本身不跑模型,它需要搭配以下之一:
- Claude Code(本期重点讲)
- Codex CLI / Codex App
- OpenCode
- Pi
- Cursor / Shell(手动接入)
没有"最低显存要求"这类东西。Agent 跑模型本身的要求,按你用的 Agent 来定(Claude Code 是 Anthropic API,没有本地硬件门槛;Codex 看你怎么部署)。
6. 推荐使用场景的"理想配置"
虽然 LoopX 本体轻量,但如果你打算跑那种 200+ 小时的 showcase 级任务,建议:
- 一台可以长时间不关机的机器(Mac mini / 家用服务器 / 云主机都行)。
- 一份稳定的网络,避免 Agent 跑到一半断网丢 state。
- 一个外部备份(LoopX state 完全可以 git 管理,但默认 gitignore —— 你可以单独建一个私有仓库同步
.loopx/)。
七、适合谁用?三类人最受益
LoopX 不是"个人写小项目"的玩具。它的甜区是:
1. 长时运行的 AI 工程师 / 研究员
典型画像:
- 用 Claude Code 跑跨天的 issue 修复、benchmark 实验。
- 跑 ML 实验、Auto Research 这类需要"挂机 8 小时"的工作。
- 痛点:"对话日志翻不完"、"Agent 跑飞了不知道"、"配额烧光了没人提醒"。
→ LoopX 直接解决这三大痛点。
2. 多 Agent 协作的团队 / 实验室
典型画像:
- 实验室里 proposer / executor / evaluator 多 Agent 跑研究流水线。
- 团队里多人都用 Claude Code / Codex CLI,要协作 issue、PR。
- 痛点:"谁在改这个文件?"、"这段代码是 AI 改的还是人改的?"、"昨晚那轮跑了什么?"。
→ LoopX 的 todo claim、evidence、review-packet 直接当"团队 Wiki"用。
3. 想要"AI 工程审计"的 Owner / Tech Lead
典型画像:
- 公司里允许工程师用 AI,但担心"AI 偷偷改生产代码"。
- Tech Lead 想要每周 / 每日看一份"AI 干了啥"的简报。
- 痛点:"我不知道 AI 做了什么决定"、"reviewer 不知道 AI 的推理过程"。
→ LoopX 的 gate + review-packet + evidence 就是为这种"治理 / 审计"场景设计的。
反过来,不适合的人:
- 只想写一次性脚本、跑一次 prompt 的人 —— 太重了,直接用 Claude Code / ChatGPT。
- 完全不接受本地化、必须用云端控制面的人 —— LoopX 是 local-first,你的运维模型不一样。
- 在 Windows 上原生用、不想开 WSL 的人 —— 暂时不支持。
八、上手实战:通用安装(不绑定 Claude Code)
在讲 Claude Code 专用流程之前,先把通用安装讲清楚 —— 这样你能更好理解"Claude Code 适配器"是个额外加的 opt-in 层。
方法 A:非克隆安装(推荐绝大多数用户)
一行命令搞定:
curl -fsSL https://raw.githubusercontent.com/huangruiteng/loopx/main/scripts/install-from-github.sh | bash
export PATH="$HOME/.local/bin:$PATH"
loopx doctor
loopx doctor 是健康检查工具,告诉你"装好了、PATH 通了、依赖齐了"。
方法 B:克隆安装(贡献者)
git clone https://github.com/huangruiteng/loopx \~/loopx
\~/loopx/scripts/install-local.sh
loopx doctor
适合要改 LoopX 源码、自己提 PR 的开发者。
项目内连接
在你的项目根目录:
cd /path/to/your-project
loopx connect            # 初始化 .loopx/ 状态目录 + 关联当前项目
loopx status             # 查看当前目标、gate、下一个 todo
loopx start-goal --guided --project . --goal-text "..."
                        # 引导式创建一个新目标
必须的 .gitignore
把以下三行加进项目根目录的 .gitignore:
.loopx/
.codex/goals/
.local/
这是 README 里反复强调的:
"LoopX should reuse existing state rather than overwrite it. Keep .loopx/, .codex/goals/, and .local/ ignored."
核心命令速查
| 命令 | 干什么 |
|---|---|
| loopx doctor | 健康检查 |
| loopx connect | 在项目根目录连接 LoopX |
| loopx status | 看目标、gate、下一个 todo |
| loopx diagnose | 诊断当前目标 |
| loopx review-packet | 生成"给 owner 看的决策摘要 + 证据 + 未解决门禁" |
| loopx start-goal –guided | 引导式创建目标 |
| loopx configure-goal | 检查 / 配置目标能力(默认只读) |
| loopx quota should-run | 本次循环是否应该跑 |
| loopx quota spend-slot | 完成验证后记账 |
| loopx todo claim | 谁负责这一片工作 |
| loopx todo update | 这一片发生了什么变化 |
| loopx refresh-state | 下一轮应该看到什么状态 |
| loopx history | 历史 |
| loopx check –scan-path | 发布前公共 / 私有边界扫描 |
九、Claude Code 专属:怎么让 LoopX 接管你的 /loop
这是本文的重点。LoopX 对 Claude Code 的支持不是"自动的",而是 显式 opt-in 的适配器。
⚠️ 重要:不要直接装"通用 LoopX"就以为 Claude Code 会被接管。Claude Code 适配器是单独的子模块,需要显式启用。
1. 三种安装方式
方式 A:通过通用安装器 + 环境变量(用户作用域)
LOOPX_INSTALL_CLAUDE=1 scripts/install-local.sh- 用户作用域安装 MCP server 和
/loopx命令。 - 无 hooks(即不会自动拦截工具调用)。
- 没有
LOOPX_INSTALL_CLAUDE=1时,安装器会完全跳过 Claude Code 适配器。
方式 B:直接调适配器脚本(推荐项目作用域)
# 仅此项目(推荐)
python3 loopx/claude_goal_mode/scripts/install.py \\
    --scope project --project /path/to/project

# 你所有的 Claude Code 项目(安装时会再次提示)
python3 loopx/claude_goal_mode/scripts/install.py \\
    --scope user

# 预览不写入
python3 loopx/claude_goal_mode/scripts/install.py \\
    --scope project --project /path/to/project --dry-run
install.py 强制要求显式 --scope,避免误装。
方式 C:可选加固模式(--harden)
python3 loopx/claude_goal_mode/scripts/install.py \\
    --scope project --project /path/to/project --harden
--harden 会加一层确定性的 PreToolUse 网关(不是沙箱!),每次工具调用前都问 LoopX 的 should_run:
- 只读工具(
Read/Glob/Grep等)直接放行。 - 其他工具:
should_run=false或 LoopX 不可达时直接拒绝(fail-closed)。 should_run=true时:Edit/Write路径在write_scope内放行,否则拒绝。Bash仅按黑名单拦截破坏性命令。- 未知工具交由 Claude Code 正常权限流处理。
⚠️ 不是强隔离 —— shell 仍可写到范围外或访问网络。高风险工作请用容器 / VM。
安装器从不删除已有权限规则,安全升级。
方式 D:一键连接(设置目标 + 项目作用域安装)
python3 loopx/claude_goal_mode/scripts/connect.py \\
    --project /path/to/project \\
    --goal-id GOAL \\
    --objective "..." \\
--harden装完必须重启 Claude Code 会话,否则 MCP 注册不生效。
2. 装完怎么用
/loopx <task>     # 设置目标 + 写入 .claude/loop.md
/loop             # 原生运行循环(或 /loop 10m 固定节奏)
/loopx status     # 查看目标、状态、todo
/loopx off # 删除 .claude/loop.md关键的"接力关系"是:
/loopx是 LoopX 提供的命令,写.claude/loop.md、注册目标、设置 gate。/loop是 Claude Code 原生命令,被 LoopX gated(门控)。 先/loopx <task>定任务,再用/loop触发实际循环。 这就是 README 说的 "Native Claude Code/loopgated by LoopX"。
3. 卸载
claude mcp remove --scope <user|project> loopx        # MCP server
rm <scope>/.claude/commands/loopx.md                  # /loopx 命令
如启用 --harden,需手动从 <scope>/.claude/settings.json 删除 PreToolUse 块和 statusLine。
4. 为什么 LoopX 在 Claude Code 上"不用 /goal"?
LoopX 是确定性(无 LLM)控制面。在 Claude Code 上,运行循环用原生 /loop;LoopX 提供控制面协议。不使用 /goal(Codex App 的 /goal 是 LLM-driven 的"判断完成",与 LoopX 的确定性网关冲突)。
这就是 LoopX 的哲学:"流程判断"不靠 LLM,靠状态机。
5. 一条命令搞定(懒人流程)
如果你想"先试试看",这是最简单的流程:
# 1. 装 LoopX(不装 Claude 适配器)
curl -fsSL https://raw.githubusercontent.com/huangruiteng/loopx/main/scripts/install-from-github.sh | bash
export PATH="$HOME/.local/bin:$PATH"

# 2. 在项目根目录连接
cd /path/to/your-project
loopx connect

# 3. 装 Claude Code 适配器(项目作用域 + 加固)
python3 \~/loopx/loopx/claude_goal_mode/scripts/install.py \\
    --scope project --project "$PWD" --harden

# 4. 一键创建目标 + 完成连接
python3 \~/loopx/loopx/claude_goal_mode/scripts/connect.py \\
    --project "$PWD" \\
    --goal-id GOAL-001 \\
    --objective "修一下 README 里失效的链接"

# 5. 重启 Claude Code 会话
# 6. 在 Claude Code 里:
/loopx 修一下 README 里失效的链接
/loop 10m跑一晚之后,loopx review-packet 就能拿到"昨晚它干了什么"的简报。
十、它的"哲学":为什么这套设计值得借鉴
写到最后,你会发现 LoopX 其实不是"又一个 AI 工具",而是一种新的工程范式:
1. 流程判断 vs 模型判断
LLM 是"下一刻说什么"的语言模型。LoopX 把所有"是否继续、谁来改、谁能改、做了啥"这类流程判断,从 LLM 手里拿回来,变成确定性代码。
2. 状态可恢复 > 状态可记忆
对话日志只是"记忆",断了就断了。LoopX 的 .loopx/ 目录是"持久状态",进程崩了、机器关了、人换班了,状态还在。
3. 人类保留最终裁决权
这是它在"全自动 AI Agent"狂热里最冷静的态度 —— AI 不是老板,AI 是工具。
4. Agent 中立,工具中立
LoopX 不绑定 Claude、不绑定 Codex、不绑定 GPT。这是反 lock-in 的设计哲学,也是它能跟 OpenViking、NoKV 这些项目合作的原因(README 里都点名了)。
5. Local-first
.loopx/ 全在你本地,不上传云端、不依赖 SaaS。在企业合规、隐私敏感场景下,这是唯一可行的方案。
如果要给这套哲学起个名字,README 里已经起好了:
Loop Engineering(循环工程)
它的意思是:把 AI Agent 的"持续运行"当成软件工程问题来解,而不是模型问题。
十一、总结:谁该现在就试,谁该等等再看
现在就试
- 你已经在用 Claude Code / Codex 跑跨天的工程任务。
- 你对"AI 偷偷改了生产代码"这件事有警惕。
- 你愿意花 15 分钟搭一套"工程脚手架",换未来几周的省心。
等等再看
- 你只是偶尔用 Claude Code 写一次性脚本。
- 你接受"AI Agent 是黑盒"这件事,不在乎过程。
- 你不愿意接受"非 Windows 原生"的前提。
一句话带走
LoopX 不是让 AI 更聪明,而是让 AI 更像个靠谱的远程员工:有目标、有边界、有日志、有下班时间、有找老板签字的流程。
附:关键链接
- 仓库:https://github.com/huangruiteng/loopx
- 当前 Star:约 3.3k
- Forks:约 248