
用过大语言模型的人大概都有一个共同的痛点:AI 记不住你。每次新对话,它像个陌生人;你问过的上下文、做过的决策、讨论过的方案,下次又要从头解释。这种"金鱼记忆"严重限制了AI在真实工作场景中的价值。
Supermemory(supermemoryai/supermemory)正是为解决这一问题而生。它给自己的定位是:AI的记忆与上下文引擎,LLM的长期记忆层。GitHub星标 647,2026年6月2日数据,还在快速增长。
今天就来深度拆解这个项目,看看它凭什么能同时登顶三大基准测试,以及对我们的实际工作有什么启发。
Supermemory是什么?
简单来说,Supermemory为AI接上了一个"外接大脑"。它不是另一个聊天机器人,而是一个记忆基础设施——
你跟AI的每一段对话、每一份文档、每一次讨论,它会自动提取其中的事实和偏好,整理成结构化的记忆。当AI下次需要时,只需50毫秒就能把相关上下文拉出来注入对话。
这意味着:AI不只是回答问题,它是真正"认识你"的。
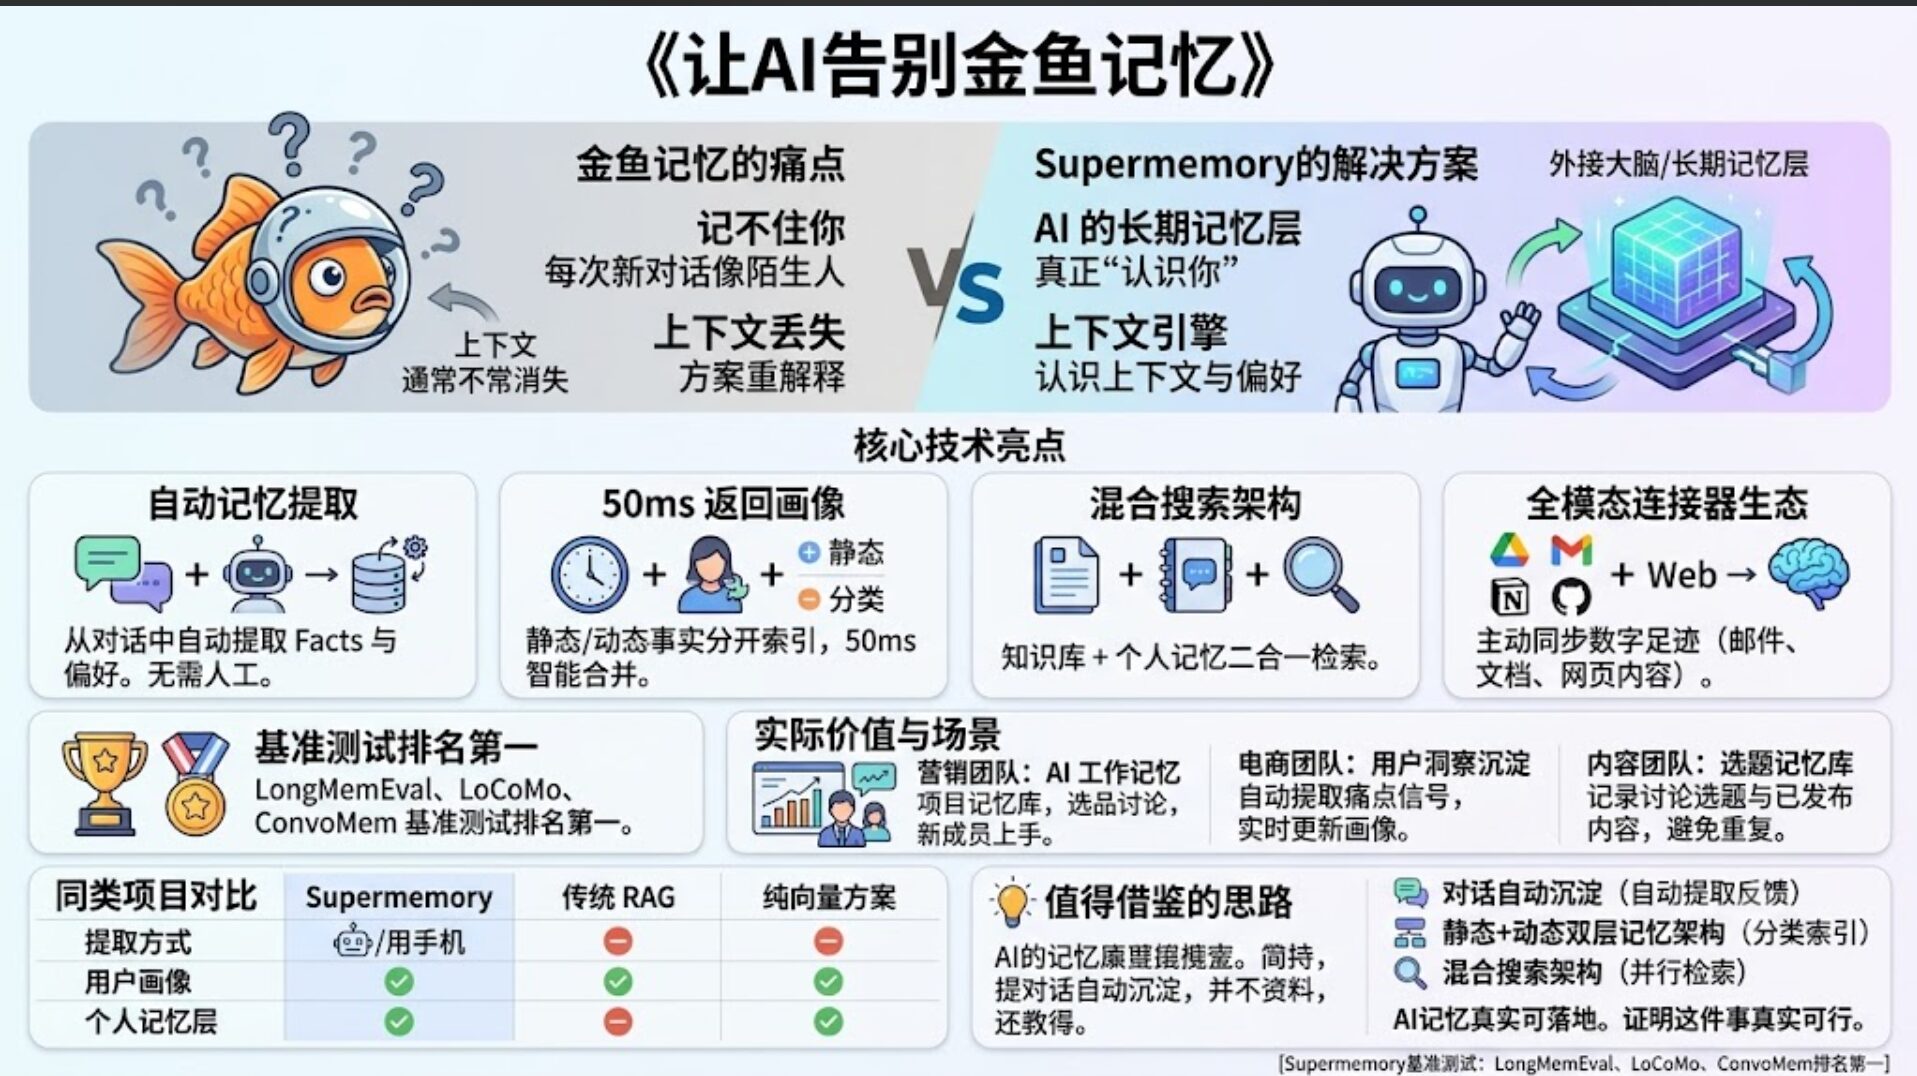
核心技术亮点
1. 自动记忆提取——不用手动整理
传统知识库的建立需要大量人工整理:上传文档、打标签、做分类。Supermemory的做法完全相反——你只管正常对话,它自动提取有价值的事实。
比如你说:"我们这次A/B测试转化率提升了15%,主要是把CTA按钮从绿色改成了红色。"Supermemory会自动识别这是可沉淀的事实,写入记忆库,而不是消失在对话历史里。
2. 50ms返回用户画像
Supermemory将记忆分为两类:
- Static Facts(静态事实):用户长期偏好、项目背景、团队成员信息——几乎不变的信息
- Dynamic Facts(动态事实):当前项目进展、最近讨论的问题、下一步行动计划——随时更新的信息
两类记忆分开索引,查询时智能合并,响应时间只需50毫秒。这个速度在实际使用中几乎感知不到延迟。
3. 混合搜索:知识库+个人记忆二合一
大多数RAG系统只能检索"公共知识库"——一群人共享的文档和资料。Supermemory在此基础上增加了个人记忆层:
用户问:"上次我们讨论的那个增长方案,现在进展如何?"AI不仅能检索知识库里的相关文档,还能调出你个人的对话记忆,给出完整上下文。
4. 全模态连接器生态
Supermemory支持连接多种数据源:
- Google Drive / Gmail(邮件和文档)
- Notion
- GitHub
- 网页内容
这些连接器的作用是:让Supermemory主动同步你已有的数字足迹,而不需要你手动导入内容。
三大基准测试第一,靠什么?
Supermemory在三个基准测试中排名第一:
- LongMemEval:长程记忆检索
- LoCoMo:本地上下文记忆
- ConvoMem:对话记忆理解
其核心优势在于:记忆提取的自动化程度和检索响应速度。传统方案依赖人工标注和复杂Pipeline,Supermemory把这两步都压缩到了极致。
对运营和电商人的实际价值
场景一:营销团队的"AI工作记忆"
营销团队经常同时推进多个项目:618大促、社群活动、新品上市……每个项目都有大量讨论、决策和调整。
用Supermemory,AI可以记住:
- 618活动的预算分配和时间节点
- 上次选品讨论中被否决的方案及原因
- 各渠道负责人的沟通偏好
新来的运营或AI助理,无需翻阅大量历史文档,直接就能上手。
场景二:电商团队的"用户洞察沉淀"
客服对话、用户调研、社群反馈——这些数据每天大量产生,但真正被结构化沉淀的少之又少。
Supermemory可以对接这些数据源,自动提取用户反馈中的高频痛点和需求信号,形成持续更新的用户画像,比传统调研更实时。
场景三:内容团队的"选题记忆"
内容团队最怕的就是"重复炒冷饭"——花了时间写了篇选题,发现半年前已经写过。
Supermemory维护一个"选题记忆库",记录所有讨论过的选题方向、已发布内容和用户反馈,新选题时可以快速检索是否有重合。
与同类产品的横向对比
| 维度 | Supermemory | 传统知识库+RAG | 纯向量数据库方案 |
|---|---|---|---|
| 记忆提取方式 | AI自动从对话提取 | 人工上传和标注 | 手动chunking |
| 用户画像 | 自动构建 | 无 | 无 |
| 个人记忆层 | ✅ 独立索引 | ❌ 共享知识库 | ❌ 共享知识库 |
| 部署难度 | 低(云端SaaS) | 中 | 高(需配置Pipeline) |
值得借鉴的思路
Supermemory有三个设计思路值得关注,即便你暂时不部署这个产品,也可以借鉴到自己的系统里:
1. 对话自动沉淀
传统知识管理是被动的——需要人主动整理。Supermemory证明了AI可以主动帮你整理。
对于运营团队来说,这个思路可以落地为:让AI自动从客服对话、社群讨论中提取用户反馈的关键信息,写入结构化的笔记或CRM系统。
2. 静态+动态双层记忆架构
把"不变的偏好"和"随时变化的项目状态"分开索引,这个设计让检索更高效,也更容易维护。
电商运营可以借鉴:把商品的基础信息(属性、规格)和动态信息(库存、价格波动、活动进度)分开管理,按需组合调用。
3. 混合搜索架构
Supermemory的RAG+Memory并行检索,解决了"公共知识"和"个人上下文"割裂的问题。
对有私域运营的电商团队来说,这个思路可以延伸为:搜索时同时检索品牌知识库+用户个人画像,让客服回复既专业又个性化。
要不要部署?
Supermemory目前以云端SaaS形态为主,数据会经过其服务器处理。对于医疗、金融等对数据隐私要求极高的行业,直接部署需要谨慎评估数据合规性。
对于数据隐私要求相对灵活的运营/电商场景,可以关注其开源版本和自托管方案。
总体来说,Supermemory的核心价值在于证明了"AI记忆"这件事是真实可落地的——即便你不用它的产品,这个方向也值得投入。
链接资源
- GitHub:supermemoryai/supermemory
- 官方文档:supermemory.ai/docs
有同学问OpenClaw是否可以用Supermemory——确实已经有社区开发者做了插件,有兴趣的可以自行研究。这里就不展开了。