
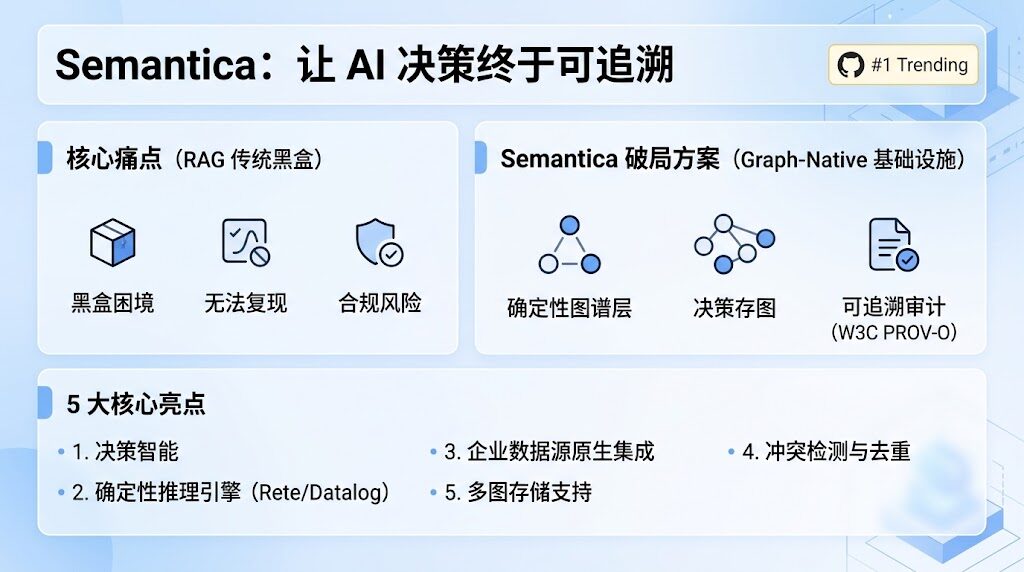
一、传统 RAG 的痛点:AI 决策为什么"无痕迹"
如果你用过 ChatGPT、知识库问答、Agent 工具,你大概率遇到过下面这些场景:
模型给了一个答案,但你想知道"它为什么这么答"——找不回证据;两个人问出不同答案,你复现不出过程;医疗、金融、法律这种强合规场景,老板问你"这个答案有没有依据",你给不出一条溯源链。
这种"AI 决策无痕迹"的问题,本质上来自传统 RAG(Retrieval-Augmented Generation,检索增强生成)的架构。
黑盒困境:模型给答案不给依据
RAG 的标准链路是:
用户提问 → Embedding 相似度匹配 → Top-K 文档 → LLM 生成答案这套链路最大的问题是:决策过程不存储。向量数据库只管"哪个 embedding 最近",不记录"为什么这个答案用这些数据"。
调试困境:复现不出来
当用户反馈"这个答案不对"时,工程团队想复现问题——结果发现向量数据库里只存了 embedding,没有存"哪份文档被引用过"。复现链路就此中断。
合规困境:审计过不了
对个人开发者来说,这只是"调试困难";对企业来说,这是合规审计的硬伤。金融、医疗、法律场景的合规审查,往往要求"每条结论都能溯源到证据原文",传统 RAG 几乎做不到。
二、Semantica 是什么:Graph-Native AI 决策基础设施
semantica-agi/semantica 是 2026-08-15 GitHub Trending 第 1 名,单日涨 1,181 颗星、总星 7,695 颗(Python 项目)。
它的定位很明确:给 LLM / 向量库 / Agent 框架加一层"确定性图谱层",让每一笔 AI 决策成为图上的一等公民节点——可查询、可追溯、可审计。
通俗点说:
- 传统 RAG = 黑盒对话
- Semantica = 把"对话过程"全部存成图,哪天被监管查、复盘、找 bug,都能从图里捞出来
项目背景
semantica-agi 是 AGI(通用人工智能)领域的开源组织,semantica 是他们面向"决策智能"推出的核心基础设施。项目用 Python 写,主打"企业级图谱 + AI 决策可追溯"。
谁适合关注它
- 你正在做企业级 RAG,想给答案加溯源链
- 你用 LangGraph / AutoGen 等 Agent 框架,想让多 Agent 决策可复盘
- 你在做医疗 / 金融 / 法律 / 合规咨询类 AI,需要审计 trail
- 你想试试"Graph + Vector 混合检索",但不想从零搭一套
三、5 大核心亮点
Decision Intelligence(决策智能)
每笔 AI 决策都是图上的一个节点,带有时间戳、上下文、证据链。导出格式遵循 W3C PROV-O(万维网联盟溯源本体标准),可以直接对接审计系统。
相比传统 RAG 的"答案 + 不透明证据",Decision Intelligence 把每条决策变成可查询的图节点——你可以随时问"3 个月前那个回答的依据是什么",系统能直接返回完整推理链。
确定性推理引擎
不用 LLM,靠图论算法就能推理:
- Forward Chaining(前向链):从已知事实推导出新事实
- Rete 算法:高效模式匹配,规则引擎常用
- Datalog:数据库式逻辑查询语言
- SPARQL:W3C 标准的图查询语言
好处:推理过程可复现、可解释、不烧 token。在业务规则密集的场景(如合规规则、风控规则),确定性推理比 LLM 更可控。
企业数据平台原生集成
直接对接:
- Databricks Unity Catalog(湖仓一体的元数据管理)
- Snowflake(云数仓)
不用先把数据导出到 SaaS,数据原地就变成图节点。这对已经在 Databricks / Snowflake 上跑业务的公司来说,迁移成本几乎为零。
冲突检测 + 去重
同一实体有多条矛盾描述时(如"张三是经理"和"张三是总监"),标记并提示解决,而不是静默覆盖。这是传统 RAG 几乎不做的事——传统向量库默认"后写入的覆盖先写入",结果就是同一实体在数据库里有矛盾描述,谁也不知道。
多图存储
- RDF 三元组库:Oxigraph / Blazegraph / Jena
- 属性图数据库:Neo4j / Neptune
- 向量库:FAISS
可以根据场景挑引擎,不绑定单一厂商。如果你的团队已经在用 Neo4j,semantica 能直接接管;如果你在搞语义网,Oxigraph / Blazegraph 也能直接用。
四、vs 传统 Vector RAG 对比
| 维度 | Vector DB + RAG | Semantica |
|---|---|---|
| 检索方式 | Embedding 相似度 | 图遍历 + 语义搜索 |
| 决策历史 | 不存储 | 一等公民节点,可查询 |
| 溯源能力 | 无 | W3C PROV-O 导出 |
| 冲突处理 | 静默覆盖 | 检测 + 标记 + 解决 |
| 合规导出 | 不支持 | PROV-O / SHACL / OWL / RDF |
| 推理方式 | 靠 LLM | Forward Chaining / Rete / Datalog / SPARQL(确定性) |
| Token 成本 | 高(每次推理都要 LLM) | 低(确定性推理不烧 token) |
| 适用场景 | 个人项目、聊天机器人 | 企业合规、多 Agent、风控规则 |
五、实战:30 秒上手
安装非常简单。
第一步:安装
pip install semantica
semantica doctor
semantica doctor 会检查环境是否齐全。
第二步:构造决策图
最简代码示例——构造一个决策图:
from semantica import SemanticGraph, Decision

# 初始化图谱
graph = SemanticGraph()

# 记录一笔决策
decision = Decision(
    query="客户张三是 KOL 吗?",
    evidence=["订单 ID 10086 消费 > 10 万", "近 30 天复购 5 次"],
    conclusion="是 KOL",
    confidence=0.92,
    timestamp="2026-08-15T10:00:00Z",
)
graph.add_decision(decision)

# 导出 W3C PROV-O 溯源(可直接给审计看)
graph.export_prov("decision_audit.ttl")
第三步:导出审计文件
30 秒就能跑出一个可被审计的 AI 决策节点。导出的 decision_audit.ttl 是标准 RDF Turtle 格式,监管机构可以直接用 Protégé 等工具打开核对。
六、什么场景适合?什么场景不适合?
适合
- 金融、医疗、法律、合规咨询:必须有溯源链
- 企业知识库问答:要回查"这条答案用了哪份资料"
- 多 Agent 协同:Agent 之间需要共享决策上下文
- 复杂业务规则:Forward Chaining 比 LLM 更可控
不太适合
- 纯创意写作:不需要溯源
- 小规模个人项目:成本大于收益
- 无合规需求:传统 RAG 已经够用
七、你也可以怎么用
如果你正考虑在企业内部署 AI 知识库,最简单的"借鉴价值"是:
第一步:先做决策记录
哪怕不上 Semantica,也建议在知识库里加一个"决策记录"表,至少能溯源到"这条答案是基于哪几份资料生成的"。
第二步:引入冲突检测意识
定期跑一次 review,标记矛盾陈述。哪怕没有 semantica 这类工具,定期 review 也能避免"同一实体有矛盾描述"。
第三步:小步试点
先拿一个低风险场景(如内部 FAQ)试 Semantica,跑通后再扩展到核心业务。
GitHub 地址:https://github.com/semantica-agi/semantica
如果你的团队正为"AI 决策无痕迹"头疼,semantica 是 2026 年值得关注的一个答案。