
让 AI 去查数据、算指标,最大的风险不是它算不出来,而是它算出一个看起来很像样的错数字。营收少一位、毛利算错口径、投产比翻个跟头,后面基于这个数的判断全盘走偏,而且往往很难发现——因为它给的结果太完整了。算错的数字一文不值!
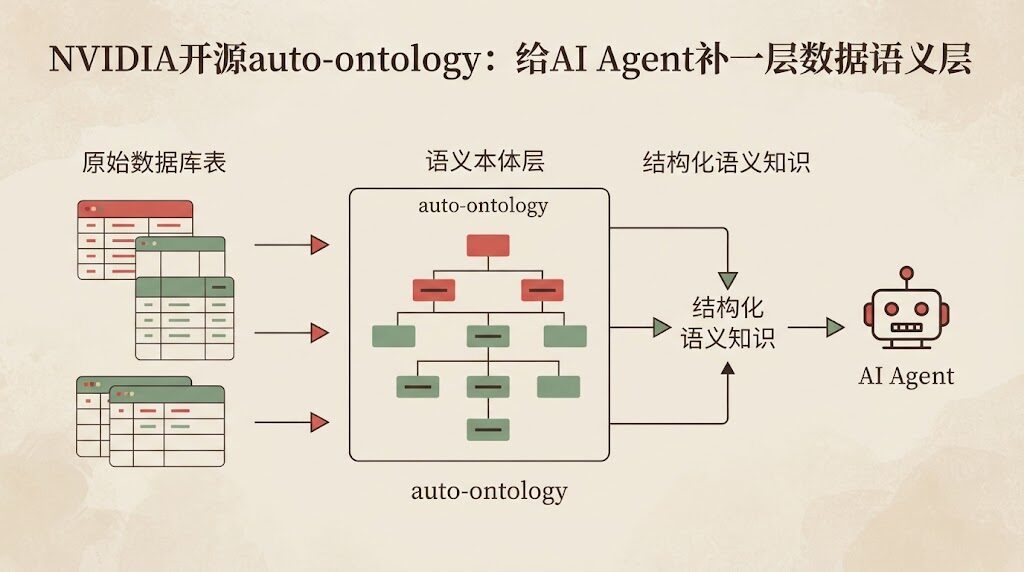
NVIDIA 刚开源的 Auto Ontology 就是冲着这件事去的。它在数据库和 AI Agent 之间插入一层「数据语义层」:先把这套数据里有什么、某个指标到底什么意思、这份数据能不能算、该怎么算、这个数从哪来、还有哪些相似项讲清楚,再让模型动手写 SQL。
如果你每天都要让 AI 出数、跑选品、复盘投放,或者让客服机器人查订单,这层就是答案可信度的地基。
项目基本盘
auto-ontology 项目README 开头就把问题定义得很准:Agent 可以检索文档、可以查数据库,但可靠性才是 agentic analytics 的门槛——更快答出来的营收数字,如果数字是错的,一文不值。
要补齐的是那层上下文:数据在哪、它是什么含义、能不能用、怎么用、来源是什么、还有什么相似项。Auto Ontology 就是一个开放库,从企业元数据里自动把这层建出来,跨系统对齐口径定义,再通过 MCP、CLI 和 API 暴露给任何 agent harness(Claude Code、OpenClaw、Cursor 这类都能接)。
官方在 README 里还写明:项目目前不接受外部 PR,团队自维护;有集成需求要走 issue 模板。这一点对你判断「能不能长期依赖」很关键。
三阶段工作流:自动生成 → 人工认证 → 回答
整个项目的骨架是三个阶段:先生成本体,人去认证,然后 agent 才从本体里回答问题。
阶段一:自动起草(Generate)
- Read sources:抽取各表 schema、对列做画像、采样样本值,汇入 catalog
- Name entities:逐表抽取业务术语,并映射到具体的列
- Resolve relationships:从主外键和实际数据推断表之间的 join 关系(含桥表),并从查询历史里给 SQL 属性出建议
- Write ontology:术语、关系、SQL 属性写入 Postgres,文本 embedding 存进 pgvector 供后续检索
这一步的价值在于把「让模型自己拍脑袋猜表结构」换成「从真实 schema 和样本值里推导」。猜十次错十次,推导一次错一次还能修。
阶段二:人工认证(Certify)
- 用真实问题在 Chat 或 MCP(
check_answerable/ask_question)里试跑 - 在 UI 或 API 里修改术语、描述、SQL 属性
- 名称、描述、SQL 属性都确认无误后,显式认证
这一步是整个设计里最容易被低估、但对公认真实性最关键的一环。草稿本体不可信,认证过的才可信。README 里有一句话点得很透:被认证的修正和使用痕迹会回流本体,共享上下文随着每次提问一起变好。也就是说你每问一次、每修一次错,这套口径就沉淀一分,不用每次重新教。
阶段三:回答五步(Answer)
- 分类意图 + 抽取问题里的实体
- 用 embedding 检索候选术语、列、SQL 属性
- 基于候选写 SQL
- 拿真实数据校验过滤值和查询本身,校验失败就修 SQL
- 执行查询,返回答案、SQL 和执行步骤
第 4 步单独拎出来讲:很多 NL2SQL 系统是在「模型写完 SQL → 直接执行 → 出数」,中间没有任何验证。这一步把真实数据拉进来先验一遍过滤值(比如「闪驱盘」这个商品名到底存不存在于表里),校验不过就地修 SQL 再跑。相比事后人工发现口径错了再回头翻日志,这一步省掉的是一整轮返工。
三类定义:整个项目的骨架
本体里装的东西分三类,是理解这个项目必须先记住的结构。
| 类型 | 内容 | 为什么关键 |
|---|---|---|
| Terms(术语) | 业务概念(如 Customer、Invoice Line)+ 描述 + 同义词 + 映射到的列 | 解决「同一个词在不同系统里指不同东西」 |
| SQL attributes(SQL 属性) | 术语下人工审阅过的 SQL 表达式,如毛利率、滚动汇总 | 口径固化:agent 复用同一表达式,每次指标算法一致 |
| Relationships(关系) | 表如何 join,含桥表,从键和数据推断 | join 路径是 agent 写 SQL 最容易错的地方 |
SQL attributes 这一类尤其值得注意。「毛利率怎么算」「退货率按单量还是按金额」这类口径,如果散落在各个脚本和提示词里,每个 agent 各实现一遍,漂移几乎不可见。做成术语下的一个受审表达式之后,agent 复用它,同一个指标每次算法都一致。
三个设计决策:这套东西真正的差别在哪
决策一:check_answerable —— 先判「能不能答」,再答
这是最值得抄的一处设计。
README 的官方示例用的是 Wide World Importers(微软的样例销售库):有人问「2015 年 6 月,USB food flash drive – sushi roll 这个商品的广告支出回报率是多少」。agent 先跑 check_answerable,返回:
check_answerable -> coverage 0.5; no term covers "ad spend"然后 agent 明确回话:这个产品的营收能算,但这份数据里没有广告支出,所以算不出 ROAS——你要六月营收,还是广告支出在别的系统里、我去接上?
这不是一句好听的免责声明,而是一条机器可判定的拒绝回答路径。数据不支持的时候,agent 被允许(甚至被要求)明确说「不支持」,而不是给一个看起来合理的错数。对数字敏感的生意来说,这条路径比多算对一个数值钱得多。
决策二:每个答案都带 SQL、步骤和原始行
Chat 界面里每个答案都显示生成的 SQL,可以查看原始行、下载 CSV、看图表。用户可以拿那段 SQL 回到源库复算。
「答案 + 可复核过程」被打包成一个交付单元,而不是两件事。出一份投放复盘结论,如果只给数字,接收方没法判断这个数怎么来的;附上 SQL 和原始行,复核成本从「重新问一遍业务方」降到「跑一条查询」。
决策三:认证是显式状态,不是「写下来就算数」
术语有草稿态和已认证态之分,只有被人工确认过的定义才允许被 agent 当权威复用。再叠加上一条「修正与使用痕迹回流本体」,就形成了一个闭环:越用越准,且准的过程有记录。
工程栈一览
| 组件 | 技术 | 端口 | 角色 |
|---|---|---|---|
| Frontend | Next.js 16(React 19、TypeScript、Tailwind CSS 4)、Better Auth、Prisma | 3000 | Web UI、认证、API 网关 |
| Backend | FastAPI(Python 3.12+)、LangChain | 3001 | NL-to-SQL agent、catalog、ontology API |
| Ingestion | FastAPI(Python 3.12+) | 3002 | 摄取 + 语义编译 |
| MCP server | FastMCP | 3003 | 只读 agent 工具(走 public API) |
| 数据库 | PostgreSQL 17 + pgvector | 5432 | catalog、ontology、向量库 |
| 凭据 | HashiCorp Vault(可选) | — | 连接凭据存储 |
前端一套现代化后台,后端两个 Python 服务各司其职,数据库用 PostgreSQL 17 加 pgvector 同时承担 catalog、ontology 和向量库三个角色,部署层面用 Docker Compose 就能拉起来。
MCP 工具按能力分族,readiness 单独成工具
这个分类法很干净,值得单独抄:
| 能力族 | 工具 | 作用 |
|---|---|---|
| Readiness | check_readiness | 这个部署到底能不能回答任何东西 |
| Terms | search_terms、get_term、get_term_columns、get_term_sql_attributes、get_sql_attribute、describe_table | 术语与列的查询与建模 |
| Answerability | check_answerable | 本体是否覆盖这个问题 |
| Questions | ask_question | 答案、SQL 和原始行 |
每个用户登录后按自己的权限执行每次调用。check_readiness 被独立成一个工具很关键:它把「环境是不是根本没连上数据源」这类问题变成一次显式调用,而不是等到提问失败才回头猜原因。
MCP server 是只读的,走 public API,配置一个环境变量指向部署地址就能接进现有 agent 工具链:
AUTO_ONTOLOGY_API_URL=http://localhost:3000 \
  uvx --from "git+https://github.com/NVIDIA/auto-ontology.git#subdirectory=mcp" auto-ontology-mcp
三个开箱即用的 agent skill
仓库自带三个 skill,入口是根目录的 AGENTS.md:
nvidia-ontology-setup:安装、连数据源、编译本体、验证就绪nvidia-ontology-management:查、建模、认证、导入导出、发布nvidia-ontology-query:提问并校验 SQL、行和答案
分工是「准备 → 治理 → 使用」。装好之后让 agent 自己按 skill 走,比手写一堆胶水脚本更省事。
REST API:一条问答接口
向 Web 应用同源发 POST /api/chat/completions 就能提问,API token 在用户菜单的 API Tokens 里生成。响应是服务器推送事件流(server-sent event stream):result 事件带答案,data: [DONE] 收尾。调用方式是流式的,命令行用 curl -N 就能拿到逐段输出。
支持十种数据源
PostgreSQL、MySQL、Databricks、Snowflake、ClickHouse、Trino、Apache Kyuubi、HeavyDB、DuckDB、SQLite。
这个列表覆盖了从传统关系库到 MPP、湖仓、联邦查询和嵌入式分析引擎的多类后端。对很多团队来说,这意味着不需要为了接语义层先把数据搬进某个特定数据库。
四个模型角色分离,各自独立配置
| 角色 | 用途 |
|---|---|
| REASONING | 主聊天 / NL-to-SQL 模型 |
| NON_REASONING | 较轻的模型,用于实体抽取 |
| EMBED | 文本 embedding 模型(摄取与查询必须一致) |
| RERANK | 检索流程里的重排模型 |
每个角色用三元组配置(endpoint + API key + model),任一字段没设就回落到对应的 DEFAULT_MODELS_*;*_API_KEY 还能回落到旧的 NVIDIA_API_KEY 以兼容既有部署。默认值是 nvidia/nemotron-3.5-lightning-30b-a3b 加上 nemotron-3.5-embed-1b 和 nemotron-3.5-rerank-8b。
值得单独点出来的是 EMBED 那一行括号里的话:embedding 模型在摄取侧和查询侧必须一致。换了 embedding 模型却不重建索引,检索结果会悄悄跑偏——这是很多自建向量库方案里最常见的坑之一,项目直接把这条约束写在了配置表上。
开放标准:兼容 Apache Ossie
Auto Ontology 兼容 Apache Ossie 这个语义模型交换标准,仓库的 ossie-converters 目录里有对应转换器,可以导入导出 Ossie YAML。语义层要能长期用,导出能力基本是刚需——不然模型换个平台,整套口径就锁死在这个框架里了。
值得警惕的两点
一、身份信任边界有一处硬伤
README 明写:FastAPI 信任前端转发过来的 x-auto-ontology-user-id 头作为用户身份;而 ingestion 服务的端点(ingest、delete、reset、compile)自身没有任何认证。官方给的处置是「3001 和 3002 只放在私有网络,所有客户端走 3000 网关」。
这是典型的「用网络隔离兜住身份模型缺陷」——部署纪律守得住就没问题,一旦有人把 3001 暴露到可达网络,就是任意写。自己搭的时候,别把这两个端口放进任何公网可达的路径。
二、预测功能会外发数据
启用 KumoRFM 后,agent 会把连接的表上传给这个托管服务。上限由 KUMO_MAX_TABLES(默认 20)和 KUMO_MAX_ROWS_PER_TABLE(不设置则不限制)控制。官方措辞是「启用前请审查这会发送什么,并完成组织的数据评审」。
把表交给外部服务这件事,开关参数 + 显式 opt-in + 先审数据,三件套缺一不可。注意 KUMO_MAX_ROWS_PER_TABLE 默认是不限制行数,这一条比表数上限更需要自己设。
电商从业者拿它能干什么
对电商运营来说,这层语义层最直接的用法不是「让 AI 更聪明」,而是让 AI 出的数能和你的口径对上。
举个具体的:某天让 AI 算「本月毛利率」,不同团队、不同脚本、不同 prompt 里的算法可能并不一致——有的按含税价,有的按不含税价,有的把运费算进成本,有的把退款冲减掉。最终报表上的毛利率可能差好几个点,而每一个数字单独看都「像是对的」。语义层做的事,就是把「毛利率」这个词钉死成一条被审过的 SQL 表达式,所有人都引用同一条,算法不再漂。
类似地:
- 选品评分:评分规则写成 SQL 属性,换人换 AI 重算,结果一致
- 退货率:口径明确是按单量还是按金额,按哪个时间字段统计
- 库存周转:跨表 join 关系固化下来,不再每次让 AI 猜哪张表是主表、桥表怎么走
- 投放复盘:广告支出来不在投放库里时,agent 会直接说「这份数据算不出 ROAS」,而不是硬拼一个数出来
最关键的一点是:这套东西让「AI 说做不到」变成一件可信的事。你没法要求模型永远答得上来,但你可以要求它在数据不够时明确降级,而不是静默地近似一个看起来很像样的答案。静默近似是真正致命的,因为它不报错。
跟几类常见方案比一比
现在市面上让 AI 接触业务数据,大致四条路线:
| 方案 | 做法 | 数据可信度怎么来 | 适合谁 |
|---|---|---|---|
| 直接给 AI 数据库权限 | 让模型自己写 SQL 查库 | 靠模型自己判断,没有任何校验 | 一次性探索、内部脚本 |
| 纯 Prompt 约定口径 | 在提示词里写清楚「毛利率怎么算」 | 靠提示词,模型一多就漂,版本一改就忘 | 单一场景、单人使用 |
| 传统语义层 / BI 工具 | 人工建模、人工维护指标定义 | 口径由人维护,稳,但建模成本高、不给 agent 用 | 已有 BI 体系的组织 |
| 本体 + 认证 + 可答性检查(本文) | 自动生成本体 → 人工认证 → agent 只从认证过的定义里取口径 | 口径显式、有状态、带认证记录,答不了就明说 | 多 agent、多数据源、口径要复用的场景 |
最直白的区别在第三行和第四行:传统语义层把口径锁在 BI 工具里给报表用;Auto Ontology 把口径做成给 agent 用的资产,通过 MCP / CLI / API 直接暴露。这两者其实不冲突——语义层本来也该是可编程的,只是多数工具没把 agent 当一等公民。
而和前两行比,差别在于失败方式:直接给权限的方案会在数据不足时编一个数;纯提示词的方案会在 prompt 被截断或换人后悄悄改口径;这个项目把「能不能答」变成一次显式检查,把「口径对不对」变成一次显式认证。代价是前期要搭环境和做认证,收益是错数不再悄无声息。
可以直接借鉴的几条做法
抛开部署本身,这套设计里有几条是任何团队搭 agent 数据链路都能用的:
- 认证要成为知识资产的显式状态,而不是「写下来就算数」。草稿和已认证要分开,只有已认证的才允许被当成权威引用
- 口径建成「术语下的受审表达式」,而不是散落在各个脚本和提示词里。同一指标每次算法一致,才谈得上可信
- 给事实型产出加一个前置的可答性探针。覆盖率不足时必须显式降级或中止,禁止静默近似——这能直接对治「看起来干完了其实在空转」的失败模式
- 结论必须附可复核过程。答案 + SQL + 步骤 + 原始行,打包成一个交付单元,而不是只给结论
- MCP 工具按能力族分组,并把「就绪检查」独立成一个工具。先确认能力已就绪,再调用
- 模型角色分离 + 端点/密钥/模型三元组配置,并明确约束「embedding 模型在摄取侧和查询侧必须一致」
- 信任边界要靠有认证的网关兜住。所有客户端过有认证的通道,不要靠「文件在不在」这种隐式判据认身份
- 数据外发三件套:上限参数 + 显式 opt-in + 先审数据。默认不限制行数的开关尤其要自己设上
这类项目串起来看的一个趋势
近两年开源 agent 生态的重心明显在移动:早期解决的是「能不能跑起来」,现在越来越多项目在解决「能不能治理」——谁批准、谁能写、谁来判定、口径以谁为准、答案凭什么可信。
Auto Ontology 补的是「语义层」这一格:模型层(路由)、记忆层、权限层、工具投递协议、编排治理各有人做,而「指标到底是什么意思、这份数据能不能答」长期空着。它把最后两问做成了显式机制——口径以谁为准,靠认证状态;答案凭什么可信,靠可答性检查加可复核过程。
这也是为什么它值得看一眼:目录结构、组件选型都可以抄,但「先判能不能答、再认证口径、每次回答附上可复核过程」这套做法,才是数字生意里真正值钱的部分。
上手路径
如果想试,README 的 Quickstart 用的是 Wide World Importers 样例库:需要 Docker Compose v2、uv 和一个 nvapi- 开头的 NVIDIA API key,clone 之后 cp .env.example .env,填几个密码和连接串,docker compose up 就能在 3000 端口看到 Web UI,再从 AGENTS.md 入口用那三个 skill 走一遍「安装 → 治理 → 提问」。
想接自己的 agent:起 MCP server,指向 AUTO_ONTOLOGY_API_URL,在客户端配置里加一条工具定义即可。
需要注意的是上面提到的两处硬伤(3001/3002 的身份信任边界、KumoRFM 的数据外发),自己部署时把这两个端口留在私有网络,预测功能默认关掉。
小结
Auto Ontology 不是又一个「让 AI 更会写 SQL」的项目。它更像是给 agent 数据链路补了一层此前普遍缺失的地基:口径有定义、定义有认证、认证有记录、答案有出处、答不了有交代。
对数字敏感的团队来说,这套「显式承认不知道」的设计,比多算对几个百分点的指标更有价值。