
billion-context 不提供模型,也不提供应用,而是专门解决 AI 编程助手的一个老大难——上下文撑不了几天。
长寿命的编码助手真正的瓶颈,往往不是模型能力不够,而是上下文的寿命:工具输出每轮累积几千 token,几周下来就撞满窗口。主流补救办法基本都是「遗忘」的变体——滑动窗口直接丢弃最老的轮次;阈值触发的自动压缩把全部历史压成一块不可逆的摘要;外置记忆只留「说过什么」,丢掉「为什么这么改」的来龙去脉。
billion-context(下面简称 BC)的自我定位是一句话:「10 万 token 的小上下文就够了,token 用量降到五分之一,一个会话可以连着跑几个月,累计吃掉几十亿 token。」
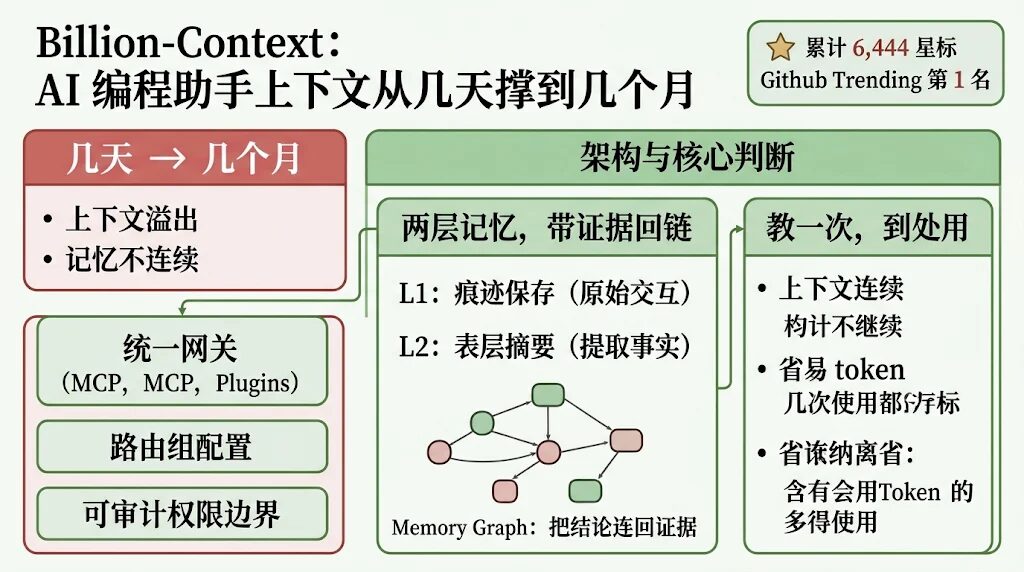
一句话讲清:它的核心动作是「折叠」
BC 把这个动作叫折叠(the fold):模型自己判断该压什么、什么时候压、压多少;被压掉的内容不丢弃,而是蒸馏成一块块可逐块恢复的摘要,放在会话开头;最近大约 50K token 保持原文。
压缩由模型自己触发,代理端只负责执行,一共给了模型四个自管工具:
compress——把一段消息区间折叠成详细摘要decompress——需要精确细节时,把压缩过的区间还原回来search_context——在压缩摘要和可见消息里做关键词检索acp_status——看上下文占用情况,以及哪些区间还能压
底层内核是一个独立仓库 acp-kernel,暴露的核心接口是 processTurn(state, messages, config):宿主负责模型 I/O 和工具分发,内核负责全部上下文簿记。
摘要不是一坨,而是一棵 LSM 树
BC 把摘要分了层。常驻空间里 tier-1 占 92%、tier-2 占 7%、tier-3 不到 1%。有意思的是比例反过来看:tier-2 加 tier-3 只占 8% 的常驻空间,却承载了 37% 的历史内容——每往上一层,单块代表的跨度就放大约 4–5 倍。
论文里管这个结构叫「散文上的 LSM 树」:年轻代吸收写入,老一代保存压实后的历史,而且压实是增量的,不是把全部历史重做一遍。任何一块摘要都能被还原成原始消息,摘要和原文之间始终留着血缘关系。
最关键的一步:只压增量,不压整段
这是整个项目最值钱的一条洞察。
传统阈值压缩每轮都把约 80% 的窗口重做成一份 30–50% 窗口大小的摘要,早期内容每轮都被再摘要一次,衰减是几何的(ρ≈0.4–0.6),四轮之后只剩 3–13%,最终趋近于零。
BC 的折叠每轮只压「上次压缩之后新增、并且任务已经消费过」的部分,触发门限是增长量——阈值 50K token,有效下限 22.5K。结果是每段内容一生只被折一次:tier-1 块的留存率停在约 1/8(工具输出为主的块约 1/24),不随轮数复合衰减。生产数据里,1,711 个 tier-2 块只有 60 个被再次蒸馏,占 3.5%。
换句话说,传统方案是每轮重新遗忘一遍,BC 是每段内容只遗忘一次。
生产数据:四个半月跑出来的数字
规模:三个宿主,四年半
这部分是论文里最硬的证据,样本是跨三个宿主、四个半月的真实使用:
- 4,843 个会话启用了折叠(其中 917 个留有完整用量记录)
- 174,327 次模型调用,累计 187.6 亿输入 token(17.5 亿新鲜 + 170.1 亿缓存读),三个宿主合计约 247 亿——项目名就是这么来的
- 在 204,800 token 的窗口模型上零违规;马拉松会话跑到 8,584–12,049 次调用、累计 10–15 亿 token,平均上下文约 120K
- 生产中共压缩 2.29 亿 token,其中 62% 集中在消息数超过一千的会话上——而这类会话只占全部会话的 1.3%
最后这条值得单独拎出来:上下文管理是个「马拉松现象」,短会话基准根本观测不到它的价值。
效果:压缩比与缓存命中的真实数字
压缩本身的开销也很克制:单次压缩的输出中位数只有 185 token(97.5% 的情况不超过 2K),计费 token 降低 31–54%,重新获取已压缩内容的调用减少 63%(约 2.7 倍)。另外,健康会话的前缀缓存命中率能维持在 95–97%,而压缩动作本身的开销不超过 2%。
基准测试不是自己给自己打分
项目方另外跑了一组 1,500 项的跨基准评测(LongMemEval-S、ContextBench、MemoryAgentBench),对照组是完整上下文加三路 RAG:
- ContextBench 拿到第一:Utilized F1 0.3097,成本比 full 低 58.3%
- LongMemEval-S 比最好的 RAG 高 16.6%:79.20% vs 62.60%,独立会话成本比 full 低 71.1%
- MemoryAgentBench 在 1.48M token 的 TTL 上 100% 存活,而 full 在 199/199 的用例上全部失败
三个基准同时赢过「不压缩」和「检索增强」,这种组合在上下文管理类项目里并不常见。
工程纪律:可能比内核更值得抄的一层
内核再怎么精巧,一周后没人维护就白搭。这个仓库在工程纪律上的做法,恰恰是更容易迁移到别处的部分。
文档与代码同 PR:一条不留退路的硬规矩
仓库主作者在 2026-11-08 定了一条硬规矩:任何改动模块边界、数据流、表结构、调度车道或线上路径的 PR,必须在同一个 PR 里更新对应的文档页、图和总表——不存在「文档回头补」这回事。
CI 机器强制:不靠人自觉
这条规矩还配了 CI 强制检查,而不是靠人自觉:
- 架构总览文档必须列全仓库全部被跟踪的
src/文件,不许有缺失,也不许有幽灵条目 - 模块总表里每一行,都要英文和
.zh-CN两页成对存在,且不存在表外的孤儿页面 - 每一页引用的图(SVG 加 PNG 备选)文件必须真实存在
- SVG 基础良构要过校验——曾经有一次英文图因为一个没转义的
&直接渲染成破图 - 双语强制:每个模块的文档都有中英各一份
文档双语,中文版甚至更完整,含译注澄清与仓库改名说明。
还有一个细节挺有意思:架构图里用红色盒子明确标出「右侧三个红盒是结构性痛点」,并在底部诚实标注「六段固定链」是尚未实现的提案。愿意在自己图上标红自己的问题,比一份全绿的架构图可信得多。
这套东西对你有什么用
如果你每天用 Claude Code、Codex、OpenCode、pi 这类工具跑长任务,BC 值得看的不是「要不要装」,而是这几条可以直接搬走的方法论:
五条可以直接搬走的做法
- 增量门控取代固定阈值:只在「任务已消费过的新增量」上动手,而不是每轮重做整段历史
- 摘要要带原文血缘:每个摘要记住自己来自哪几段原文,需要时能整块还原
- 压缩判断写成封闭判定词表:过压、欠压两种失败模式 + 唯一判据「这段内容当前任务步骤还需要吗」,让压缩决策可检视、可版本化
- 压缩时注入、压完即删:临时提示用完立刻移除,不在上下文里留垃圾
- 文档与代码同 PR + CI 机器强制:把「多改一处要同步 N 处」的人工纪律变成机器校验
最后一条对任何维护 AI 知识库、技能库或长期文档仓库的团队,几乎是零成本高回报。
什么时候你用不上它
边界也得说清楚,下面几条是真会劝退人的:
- 短会话用不上。62% 的压缩量集中在占 1.3% 的超长会话里,日常问两句、跑个十几轮的任务,装它是纯负担。
- 单作者维护 + 553 个未关闭 issue(不含 PR),迭代很快,但 bus factor 是实打实的风险。
- 许可字段是 NOASSERTION,README 和论文都自称 MIT,商用前建议先澄清。
- 和宿主自身的 compaction 深度耦合,同一段历史不能被两个压缩器各压一次,官方反复强调两种接入方式互斥。
- 支持的客户端是代理/插件层,覆盖 Claude Code、Codex、OpenCode、pi、dsh、kimi、hermes、zcode、Gemini、Qwen Code 等,但不包含 OpenClaw——想接就得自己写适配或做中间人代理,改造成本和风险都不太可控。
- 引入量不小:2,263 个文件、其中测试文件就有 1,275 个,是一整套方案而不是一个小库。