
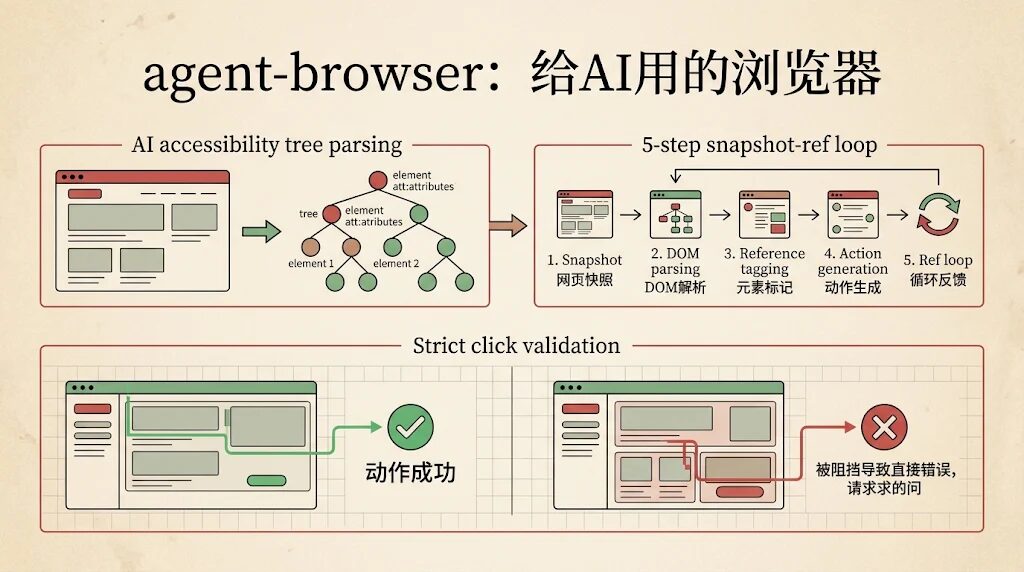
它是什么:一个专门给 AI 用的浏览器命令行
一句话定位
vercel-labs/agent-browser 是一个用 Rust 写的浏览器自动化命令行工具,它的默认使用者不是人,而是 AI Agent。它的自我描述很清楚:Browser automation CLI for AI agents。Vercel Labs 把它做成一条窄接口——不试图变成通用浏览器 SDK,而是只保留「让 Agent 一步一步驱动一个真实浏览器」这条最短路径。
主循环长什么样
它的工作方式是固定的一个循环:先打开页面,再把当前页面压缩成带标记的紧凑文本,然后按标记执行动作,接着重新读取页面确认结果,如此往复。
agent-browser open example.com
agent-browser snapshot -i
agent-browser click @e1
agent-browser get url
agent-browser close
open 打开页面,snapshot -i 输出当前页面上可交互元素的一行行清单,每一行都带一个标记(形如 @e1),click @e1 就是点它,get url 读回当前地址,close 收尾。
一次只走一步
这个循环里最关键的不是命令本身,而是「每一步都很短」。浏览器在两条命令之间保持打开状态,于是每一次操作都只是一次很短的 shell 调用——不需要把整个浏览器状态搬来搬去,也不需要在两次调用之间重新握手。
对比一下常见的做法:一次性写一大段脚本、把所有选择器提前算好、一次性跑完再看结果。agent-browser 反其道而行,强制你(或你的 Agent)每次只做一步、每步之后都读一次页面。这让「页面已经变了」这件事变得可被发现。
它和常见自动化方案差在哪
同类工具里,Playwright、Puppeteer 面向的是「开发者写确定性脚本」,Selenium 同理;RPA 工具面向的是「人配置录制回放」。agent-browser 面向的是第三种场景:一个需要边看边决定的 Agent。
它的命令行是给模型消费设计的——输出是紧凑文本而不是人类友好的表格,错误是显式报错而不是尽力而为的静默失败。这两条决定了它和你熟悉的浏览器自动化库不是同一类东西。
五分钟装起来跑通
三种安装方式
最常规的是用 npm 全局安装,然后单独执行一次安装命令去下载 Chrome for Testing:
npm install -g agent-browser
agent-browser install
也可以用 Homebrew;在 Linux 上需要补齐系统依赖库,官方为此准备了带依赖的安装开关:
brew install agent-browser
agent-browser install --with-deps
零安装试用
如果只是想看一眼它到底能干什么,不想在机器上留下全局包,它支持直接用 npx 拉起来跑单条命令:
npx agent-browser open example.com这条路径适合快速验证,也适合在 CI 或临时环境里用。
第一个循环
装完之后值得完整跑一遍上面那个五步循环,重点观察两件事:第一,snapshot -i 的输出到底长什么样——它是可交互元素的清单,不是整页 HTML;第二,click @e1 之后页面可能已经变了,所以 get url 这类读回动作不是可选的。
ref 是它最核心的抽象
snapshot 把页面压成紧凑文本
snapshot 是整条链路的入口。它把当前页面压成一份紧凑的文本表示,每一行对应一个元素,并给每个元素配一个 ref。
对 Agent 来说,这个格式有两个好处:一是短,页面状态可以反复读进上下文而不至于爆掉;二是可寻址,模型读完之后可以直接说「点第 3 个那个」,不需要自己解析 DOM 树。
ref 的时效契约
这是整个项目里最该记住的一条规则:ref 描述的是 snapshot 那一刻的页面。导航之后、DOM 变化之后,旧的 ref 就失效了,必须重新 snapshot 再用。
换句话说,ref 不是浏览器里某个元素的永久句柄,而是某一帧快照上的临时坐标。这个设计看起来麻烦,但它换来的是一个很重要的性质——模型永远知道自己在操作哪一帧的页面,不会拿着一个过期坐标去戳一个已经不在那儿的按钮。
不止 ref
ref 是默认寻址方式,但不是唯一方式。除了 ref,还可以直接用 CSS 选择器、文本匹配、XPath,以及一套语义定位器:
agent-browser find role button click --name "Submit"语义定位器按无障碍角色和可见名称去找元素,对「同一个页面有多个长得一样的按钮」这类场景更稳。实际用法里常见的是组合:先用语义定位找到大致区域,再用 ref 精确点击。
失败必须可见
点击失败就是失败
这是 agent-browser 最有价值的一条设计契约:目标元素被遮挡、被禁用、被隐藏,或者位于当前视口之外时,点击会明确报错,而不是报告成功。
它的官方文档直接点名了 consent banner(Cookie 同意弹窗)这类遮挡物,要求使用者先把遮挡层处理掉、重新取一次快照,再重试。
四种失败形态
落到具体行为上,这四种情况都不是「点了但没反应」,而是明确的失败:
- 元素被别的元素盖住,点击落到了别的东西上;
- 元素处于禁用状态,本轮不参与交互;
- 元素被隐藏,视觉上存在但不可见;
- 元素在视口之外,需要先滚动才能操作。
每一种都会走报错路径,而不是被当成一次成功返回。
这条设计为什么值钱
浏览器自动化的历史事故里,有一类特别难查:脚本报告「点击成功」,于是流程继续往下走,实际上页面根本没变,最后在很远的地方以一个看似无关的错误爆掉。
而「假装成功」这个问题在 AI 场景里会被放大。一个会自己声称完成的工具,会把错误藏进上下文里,让模型基于错误的中间状态继续决策。对 Agent 来说,最有价值的工具语义是「拒绝谎报成功」——失败要显式、能被读回、能触发换一条路。agent-browser 把这一点写进了默认行为,而不是交给使用者自己注意。
会话、生命周期与状态
每条命令发给一个后台守护进程
它的架构不是「每次调用起一个浏览器」,而是所有命令都发给一个后台 daemon,daemon 再通过 CDP 去驱动浏览器。这样做的好处很直接:浏览器能在两条命令之间保持打开,于是每一步真的只是一次短命令。
用 session 隔离多个浏览器
同一个 daemon 可以同时持有多个浏览器实例,靠 --session 参数区分。你可以让一个 session 跑主流程,另一个 session 跑后台检查,两者互不干扰。
空闲一小时后的收尾行为
在 headless 模式下,如果开启了 session persistence,daemon 在一小时没有收到命令后会先把状态保存下来再退出,而不是直接被杀掉。这意味着长时间挂着的任务不会因为进程被回收而丢状态。
引擎与供应商是可插拔的
默认引擎是 Chrome for Testing,但你可以换:
- 用
--cdp或--auto-connect接管一个已经在跑的 Chrome,而不是另起一个; - 用
--engine切到 Lightpanda、Obscura 等别的引擎; - 驱动 iOS 模拟器里的 Mobile Safari;
- 或者接云浏览器供应商,比如 Browserbase、Browserless、Browser Use、Kernel、AgentCore。
换引擎和换供应商都只是换一个入口参数,核心的快照—动作—回读循环不变。
给 AI 准备的技能与 MCP
核心技能可以单独拉取
仓库里内置了给 agent 用的技能包,可以只取核心那份:
agent-browser skills get core核心技能涵盖主循环、ref 用法、等待机制、常用工作流、排障与安全约定。它还可以只拉某一份参考(--ref commands),或者拉全量参考与模板(--full)。此外还有 electron、slack、dogfood 等专项技能。
技能可以装进 agent 的技能目录
一种方式是用 skills 工具直接添加:
npx skills add vercel-labs/agent-browser另一种更轻的做法,是在 agent 的说明文件里写一句「用 agent-browser 做浏览器自动化,首次使用前先 skills get core」。
也可以直接跑 MCP server
agent-browser mcp这条命令起的是 stdio 模式的 MCP server,所以任何支持 MCP 的宿主工具都能把它当工具源接进来,不必额外做适配。
命令族很完整
从命令行的帮助输出可以看到它覆盖的家族相当宽:
- 导航与读取:open、back、read、snapshot、get、is;
- 交互:click、fill、type、press、hover、select、check、scroll、drag、upload、find;
- 等待:wait;
- 捕获:screenshot、pdf、record、download、diff;
- 页面与网络状态:cookies、storage、network、eval、clipboard;
- 标签页、frame 与弹窗;
- 调试与性能:console、errors、trace、profiler、vitals、react、a11y;
- 会话与认证:session、state、auth、profiles、confirm、deny;
- agent 与集成:skills、mcp、webmcp、flow。
对一个「让 Agent 驱动浏览器」的定位来说,这份命令表已经覆盖了从读到写、从调试到复用的完整面。
仓库结构透露出的设计意图
顶层目录分工清晰
这个仓库的目录结构本身能看出作者的意图。cli/ 放 CLI 实现(164 个条目),docs/ 是文档站(142 个),packages/ 放包与面板(139 个),examples/ 是示例(106 个),skill-data/ 是技能数据(42 个),evals/ 是评测用例(25 个),benchmarks/ 是基准(9 个),另有 docker/ 与 scripts/。GitHub tree 实测一共 677 个条目。
核心技能是薄壳加一份路由表
skill-data/core/ 的结构值得单看:一份 SKILL.md,加上一份 references/ 目录,里面分 authentication、commands、profiling、proxy-support、session-management、snapshot-refs、streaming 等若干主题。
因为核心 SKILL.md 每次使用都会加载,所以它只放主循环、ref、等待、常用任务、排障、安全和一张路由表;具体 flag、选项、边界情况全部放进对应的 reference,改动时补一行路由即可。这是「默认只给结构,细节按需展开」的一个具体实现。
评测用例直接测 agent 的行为
evals/cases/ 里的用例是写给 agent 看的,测的是行为而不是功能:命令用法、上下文占用、参考路由、技能加载、技能选择,分别对应 command-usage、context-footprint、reference-routing、skill-loading、skill-selection。
也就是说,这个项目会检验「agent 到底会不会用、会不会选对技能、上下文有没有超标、参考有没有被正确路由」。这在工具类项目里并不常见。
写在仓库里的工程契约
一处改动要同步五处
它的贡献指南里有一条硬性要求:任何新增或修改用户可见的特性(flag、命令、行为、环境变量),必须同时更新五个地方——cli/src/output.rs 里的帮助输出、README(当安装、快速上手或命令分组表有变化时)、skill-data/core/ 下的参考文档与核心技能(核心工作流变化时)、docs/content/docs/ 的文档页面、以及相关源码里的行内注释。漏掉任何一处,都算没做完。
CLI 与 MCP 必须对等
另一条是:任何对 CLI 命令、flag、行为、输出、环境变量或解析语义的改动,都要同步更新 MCP server。这一条堵住了「命令行能用了但 MCP 那侧还停留在旧世界」的漏洞。
一些看起来琐碎的写作规范
包管理只用 pnpm;文档和代码里不用表情符号;文档里不把双连字符当破折线用;命令行颜色统一走 cli/src/color.rs 并尊重 NO_COLOR 环境变量,不许硬编码 ANSI 色码;命令行 flag 一律 kebab-case。
另外还要求写散文(README、变更日志、提交信息、issue、PR)时走仓库自带的写作技能,而不是随手写。
这些条目单独看都很小,但它们合起来决定了文档能不能被稳定地自动消费——对面向 agent 的项目来说,这恰恰是核心资产。
什么时候你用不上它
它和你已有的浏览器能力重叠
如果你已经在用别的浏览器自动化方案(自带浏览器工具的 AI 助手、脚本化的无头浏览器、或者录制回放式的 RPA),那么再引入一套浏览器编排,多半会和管理已有的会话、登录态互相抢资源。这类重复建设通常得不偿失。
安装链比一般工具宽
它的安装要经过 npm 或 npx,还要下载一份 Chrome for Testing,产物涉及 Rust 构建。相比纯 Node 或纯 Python 工具,供应链面更宽,在受控环境里需要额外评估。
项目还在高频迭代
524 个 open issue 意味着它仍在快速变化。今天的命令形态、默认行为,明天可能就变了。把它接进生产链路前,要预留出跟随上游更新的成本。
生态位很垂直
它服务的是编码 agent 的浏览器自动化场景。如果你的日常工作和这个场景没有交集,那它的收益主要来自方法论,而不是工具本身。
怎么读这个项目
它真正有借鉴价值的是那份契约与结构,而不是那份二进制:
- 动作类工具拒绝谎报成功;
- 引用类状态必须声明时效;
- 技能与运行时版本绑定,用薄壳加路由表控制上下文;
- 给 AI 写行为测试;
- 一处改动、多处同步的发布清单;
- 引擎可插拔,但插拔点放在边界而不是内核。
把这几条落到自己已有的工具链上,可能比直接换一套工具更划算。