
一句话定位
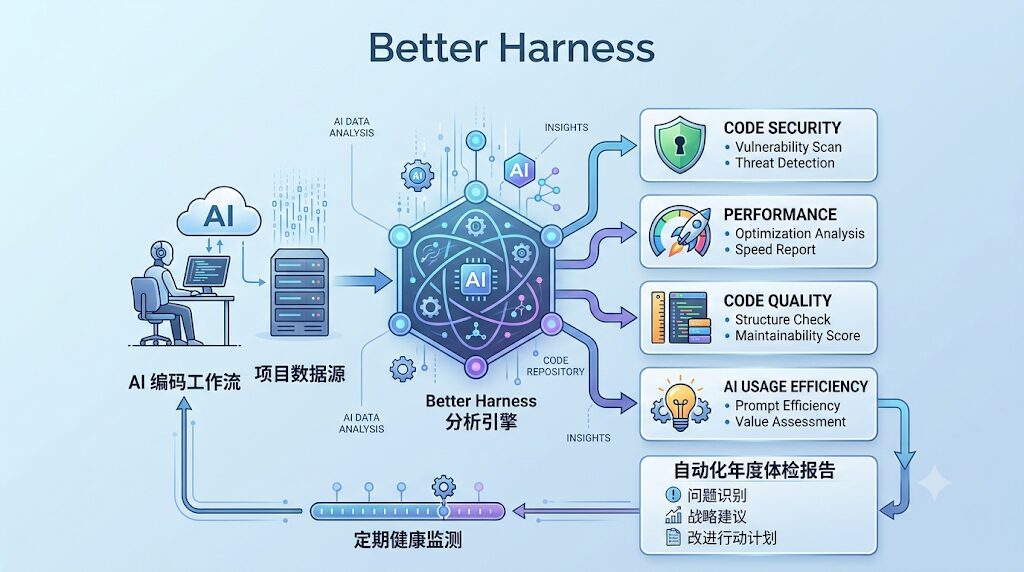
Better Harness 是一台给"AI 编码工作流"用的体检仪。 它不写代码,也不替你调 prompt——它审计你的 coding agent 工作流哪里做得好、哪里有窟窿,然后给出一份带证据、带修复方案的体检报告。
打个比方:Claude Code / Codex / Cursor 是车手,Better Harness 是赛车维修工程师。它不上赛道飙车,但能告诉你刹车片该不该换、换了能快多少秒。
为什么你需要它?
AI coding agent 改代码的速度已经快到惊人。但改完之后的流程——目标有没有对齐、验证做没做、经验有没有沉淀——往往是真正的薄弱环节。Better Harness 把最容易翻车的五种情况总结成了下面这张清单:
| 翻车类型 | 具体表现 |
|---|---|
| 🎯 目标模糊 | agent 信心十足地解决了错误的问题 |
| 🧭 执行路径随意 | 工作沿着他人都无法复现的路径推进 |
| ✅ "能运行"没有证据 | 验证不完整或完全缺失,"看着像过了" |
| 🚢 速度压过保障 | 审查、CI、审批被绕过 |
| 🧠 经验没沉淀 | 同一个坑下次任务再踩一次 |
只看最终的 diff,这些系统层面的问题会被全部错过。你要看的是整个工作流——这正是 Better Harness 想要帮你做的事。
项目速览
| 项目 | 数据 |
|---|---|
| 全名 | @qoderai/better-harness |
| 当前版本 | 0.3.0 |
| 首发日期 | 2026-07-21(项目极新,不到 10 天) |
| GitHub Stars | 597(增速极快) |
| License | MIT |
| 主语言 | JavaScript(需 Node.js ≥ 22.20.0) |
| 出品方 | Qoder(阿里旗下的 AI IDE) |
| 中文文档 | 自带 README.zh-CN.md |
为什么是 Qoder 出品? Qoder 自己就是一个 coding agent 桌面 IDE——他们显然已经在日常工作中踩够了"agent 跑飞了"的坑,才把经验抽象成这个工具。
它怎么工作:Agent Work Loop 模型
Better Harness 提出 Agent Work Loop——一个评估 coding agent 工作流的 5 维度模型,每个维度配 3 个具体检查点:
任务理解 → 受控执行 → 变更验证 → 可靠交付 → 经验沉淀
 ↑                                                ↓
└──────────── 下一轮工作从中受益 ←──────────────┘| 维度 | 它回答的问题 | 靠什么支撑 |
|---|---|---|
| 任务理解 (Task Understanding) | agent 是否知道目标、"完成"的定义? | AGENTS.md、spec、DESIGN.md、Rules |
| 受控执行 (Controlled Execution) | 工作是否沿可复现的路径进行? | Skill、命令、MCP 工具、沙箱边界 |
| 变更验证 (Change Validation) | 是否有证据表明变更确实有效? | 测试、lint、Hook、诊断日志 |
| 可靠交付 (Reliable Delivery) | 速度是否绕过质量检查? | 人工审查、审批、CI/CD、回滚路径 |
| 经验沉淀 (Learning Capture) | 下次任务能否从本次任务中受益? | Loop Discovery、Skill、Memory |
这套模型来自 Martin Fowler 那篇 *Harness Engineering* 文章的工程化落地(forward-and-feedback loop),不是凭空发明的概念。
证据的 6 个状态:克制式评分
Better Harness 不说谎——它不糊一个总分。每个证据被标注成明确的状态:
| 状态 | 含义 | 评分上限 |
|---|---|---|
| Missing | 确认缺失 | 59 |
| Present | 机制存在 | 74 |
| Wired | 可被触发 | 84 |
| Exercised | 在某次任务中被实际使用 | 94 |
| Outcome-supported | 后来有可比的改善结果 | 100 |
| Unobserved | 观察不到(≠ 不存在) | — |
| Not applicable | 确认不适用 | — |
这是它最大的优点:宁可标 Unobserved 也不臆测。这种克制让报告可信——你不会被一个虚高的分数骗到以为自己的工作流没问题。
注意:配置存在 ≠ 能力生效。一个 AGENTS.md 躺在仓库里不代表它真的在引导 agent——必须 Exercised 才能拿高分。
怎么装?按你用的 host 分情况
Better Harness 适配 4 种主流 coding agent,以及一些间接路径。
Claude Code(最推荐)
打开你的 Claude Code(或基于它的桌面 fork),在一个新 session 里输入:
/plugin marketplace add QoderAI/better-harness等几秒,再输入:
/plugin install better-harness@better-harness然后关闭当前 session,新开一个(插件变更后需要新 session 让 host 重载插件清单)。验证:
/better-harness不带参数——它会显示帮助。
Codex Desktop / Codex CLI
- Desktop:Settings → Plugins → From Marketplace → 搜索
better-harness→ 安装 - CLI:
codex plugin marketplace add QoderAI/better-harness→codex plugin add better-harness@better-harness
Qoder Desktop / CLI
无需安装——Qoder 内置了 Better Harness。打开你的项目直接用。
Cursor
从源码加载:git clone 后用 cursor-agent --plugin-dir 指向本地仓库。详细见官方 README。
OpenClaw 用户怎么用?
OpenClaw 没有出现在 README 显式支持的 host 列表里(官方只列了 Claude Code / Codex / Qoder / Cursor 四家),但有三种适配路径:
- 纯 CLI 路径(最省事):Better Harness 的核心入口
node scripts/better-harness.mjs report --no-sessions是完全 host 无关的——任何项目根目录都能跑,5 秒出结果。你可以把生成的findings.json/report.md/report.html直接在 OpenClaw 的会话里喂给你的主 agent,让它按 5 维度框架给出修复建议。 - 当作 Skill 引入:OpenClaw 的扩展体系本身就支持 Skill / Hook / Plugin 三层(参见 OpenClaw 文档)。Better Harness 的 5 维度评估模型本身就是一份"过程规范 Skill"——你完全可以把
models/agent-work-loop.md翻译成 OpenClaw Skill 格式,作为项目级 Skill 加载,让 OpenClaw 的 agent 在每次任务结束时跑一次自检。 - 当作 Plugin 引入:OpenClaw 支持通过 npm 包方式安装 plugin(
openclaw plugins install <npm-package>)。Better Harness 的 npm 包@qoderai/better-harness理论上可以作为 OpenClaw plugin 的后端,但需要写一个薄薄的 OpenClaw adapter 把 evidence-bundle 命令和 report 生成接到 OpenClaw 的工具调用协议上。这一步目前还没人做过,欢迎 PR。
最简单的路径:先走方案 1(纯 CLI),拿到报告后人工消化。如果你用得顺手,再考虑方案 2 把模型沉淀为 Skill。
怎么用?五种姿势
姿势 1:标准体检(在 coding agent 里)
打开你的项目目录,新开一个 session,输入:
/better-harness review this project's AI coding workflow and generate a report中文版:
/better-harness 审查此项目的 AI 编码工作流并生成报告它会做这些事:
- 收集证据:调用
node scripts/better-harness.mjs harness evidence-bundle收集三类证据——
- session 证据(你这个项目的 session 历史摘要)
- project 证据(
AGENTS.md、Skills、MCP、Memory、Hooks、Commands 等) - agent 定制证据(lint / inventory / integrity)
- 并行评估:启动三个只读子 agent 分别评估上述三个证据域
- 整合输出:主 agent 整合 + 给每个 finding 分配一个 Agent Work Loop 维度
- 渲染报告:产出
findings.json+report.md+report.html
报告默认输出到 <项目>/.claude/better-harness/<日期>/<时间>/。
姿势 2:快速体检(5 分钟版)
/better-harness review this project (quick mode)quick mode 只看 3 个资产 + 最近 7 天。normal mode 看 5 个 + 30 天。
姿势 3:纯 CLI(不依赖任何 agent host)
cd /path/to/your/project
node /path/to/better-harness/scripts/better-harness.mjs report --no-sessions
5 秒出结果,给你一份 Quickstart 输出,包含 Project 概况 + 下一步建议。
姿势 4:本地预览 Canvas 报告
npm run preview -- --open仅本地预览工具,不是分享服务。
姿势 5:构建可分发的 host 插件
node scripts/packaging/build-host-plugin.mjs产物写到 dist/plugins/better-harness/。
实际产出举例
跑完 /better-harness 后你会看到类似这样的 finding:
Finding 1(Task Understanding / goal-understanding) – 影响:未来 5 次类似任务可能重复踩同一个上下文坑 – 预期输出:在
AGENTS.md中补上"完成"的定义 + 验收清单模板 – 修复方案:[AI 自动生成的范围明确的修复计划] – 验收:npm test+ 重新跑/better-harness看分数变化
你会得到一个有 owner、有边界、有验证手段的修复任务——而不是"AI 建议你改一下"这种空话。
适合谁?
✅ 强烈适合
- 团队 Lead / Tech Lead:想搞清楚团队里 AI coding 的"成熟度在哪一格",避免"我以为我们用得挺好"
- 资深 Claude Code / Codex 用户:插件堆了 30+ 个,不知道哪些真有用、哪些是死重
- 追求 harness engineering 方法论的人:Martin Fowler 那篇 *Harness Engineering* 文章的实践落地工具
- 多 host 混用用户:同时用 Claude Code + Codex + Cursor,better-harness 能横向对比
⚠️ 评估后再说
- 刚用 Claude Code 一周:先建立自己的
AGENTS.md/ spec 习惯,否则 better-harness 扫不出东西 - 只用 agent 写一两行代码:ROI 太低
❌ 不适合
- 期待"装上就涨 productivity"的人——这是审计工具,不是加速工具
- 不愿读报告的人——报告可能很长(HTML + Markdown 都有),需要你愿意花 15-30 分钟消化
跟常见栈的关系
Better Harness 几乎不跟你已有的工具冲突——它站在更高层级做总评:
| 现有栈 | 作用 | 跟 better-harness 的关系 |
|---|---|---|
| claude-mem(跨 session 记忆持久化) | 存"做了什么" | ✅ 互补:mem 记事实,better-harness 评质量 |
| superpowers(过程 skill 库:TDD / debugging) | 给 micro 流程("先 brainstorm 再写代码") | ✅ 互补:superpowers 是过程指南,better-harness 是体检报告 |
| loop-engineering / harness engineering 方法论 | 思路框架 | ✅ 完美对齐:better-harness 就是这个方法论的工程实现 |
| ruflo(多 agent 编排) | 编排多 agent 协作 | 🟡 不同维度:ruflo 管协作,better-harness 评单 agent 成熟度 |
| Cursor / Codex / Qoder 等其他 host | 各家 IDE | ✅ 横向覆盖:同一份报告,4 家 host 都能跑 |
结论:Better Harness 不是你现有栈的替代品,而是最高层级的体检工具——它站在 superpowers(过程)+ claude-mem(记忆)+ 你的 IDE(host)之上做总评。
已知问题(透明披露)
跑 npm test 时社区报告的常见情况:
- 833 个测试,绝大多数通过;偶发 1 个失败
- 失败用例:
Claude and Codex instruction ledgers keep their active filenames separate - 现象:Windows 路径下多算了一个
ancestor:CLAUDE.md入口 - 影响:仅该测试的断言失败;评估功能本身不受影响(CLI 已验证可用)
- 状态:8 天前的新项目,预计作者会修
态度:装上用,遇到 bug 顺手在 GitHub 提 issue,不要阻塞你的正常评估工作。
结论
价值评分:8.5 / 10
| 维度 | 评分 | 说明 |
|---|---|---|
| 方法论价值 | 10/10 | 5 维度 + 6 状态评估模型是行业级抽象 |
| 工程诚实度 | 10/10 | 不臆测、不夸大,Unobserved ≠ Missing |
| 跨 host 通用性 | 9/10 | 4 大主流 coding agent 全覆盖;OpenClaw 可走 CLI 路径 |
| 与现有栈协同 | 9/10 | 跟 claude-mem / superpowers / loop-engineering 都是补位 |
| 安装难度 | 8/10 | Claude Code 上 1 行命令;其他 host 路径略有差异 |
| 文档完整度 | 9/10 | 自带中文 README + 11 个 references + 完整 docs |
| 项目成熟度 | 6/10 | 不到 10 天的新项目,偶发 test bug;早期但增速快 |
推荐下一步
- 装上:在 Claude Code 里跑两步命令(marketplace add + plugin install),新开 session 验证
- 跑一次:选一个你熟悉的项目跑
/better-harness,看 5 维度评分 - 横向对比:换 2-3 个项目各跑一次,看看自己的"工作流成熟度"分布在哪个区间
- 沉淀经验:把高频 finding 转化为
AGENTS.md的硬性规范或新的 Skill
不推荐场景
- 你刚装 Claude Code 一周,先建立自己的
AGENTS.md/ spec 习惯再说 - 你只用 AI 写一两行代码,ROI 太低
附录:核心概念速查
| 概念 | 一句话解释 |
|---|---|
| Harness Engineering | Martin Fowler 提出的方法论:把 agent 的"工作环境"当工程对象来设计 |
| Agent Work Loop | Better Harness 的 5 维度评估框架 |
| Evidence States | 6 个证据状态(Missing → Outcome-supported),用来给每个发现标可信度 |
| Feedforward / Feedback | 工作开始前的引导(AGENTS.md / spec)+ 工作结束后的信号(test / lint / hook) |
| Loop Discovery | 从已完成任务里提炼可复用模式,下一轮任务直接受益 |
| OpenClaw Adapter | 把 better-harness 接入 OpenClaw 工具调用协议的薄壳(暂无官方实现,社区可贡献) |
*本文基于 2026-07-29 GitHub 主分支(commit e50861e)。Better Harness 仍处于早期阶段,建议每两周重跑一次体检看 5 维度分数变化。*