
一、模型基本信息
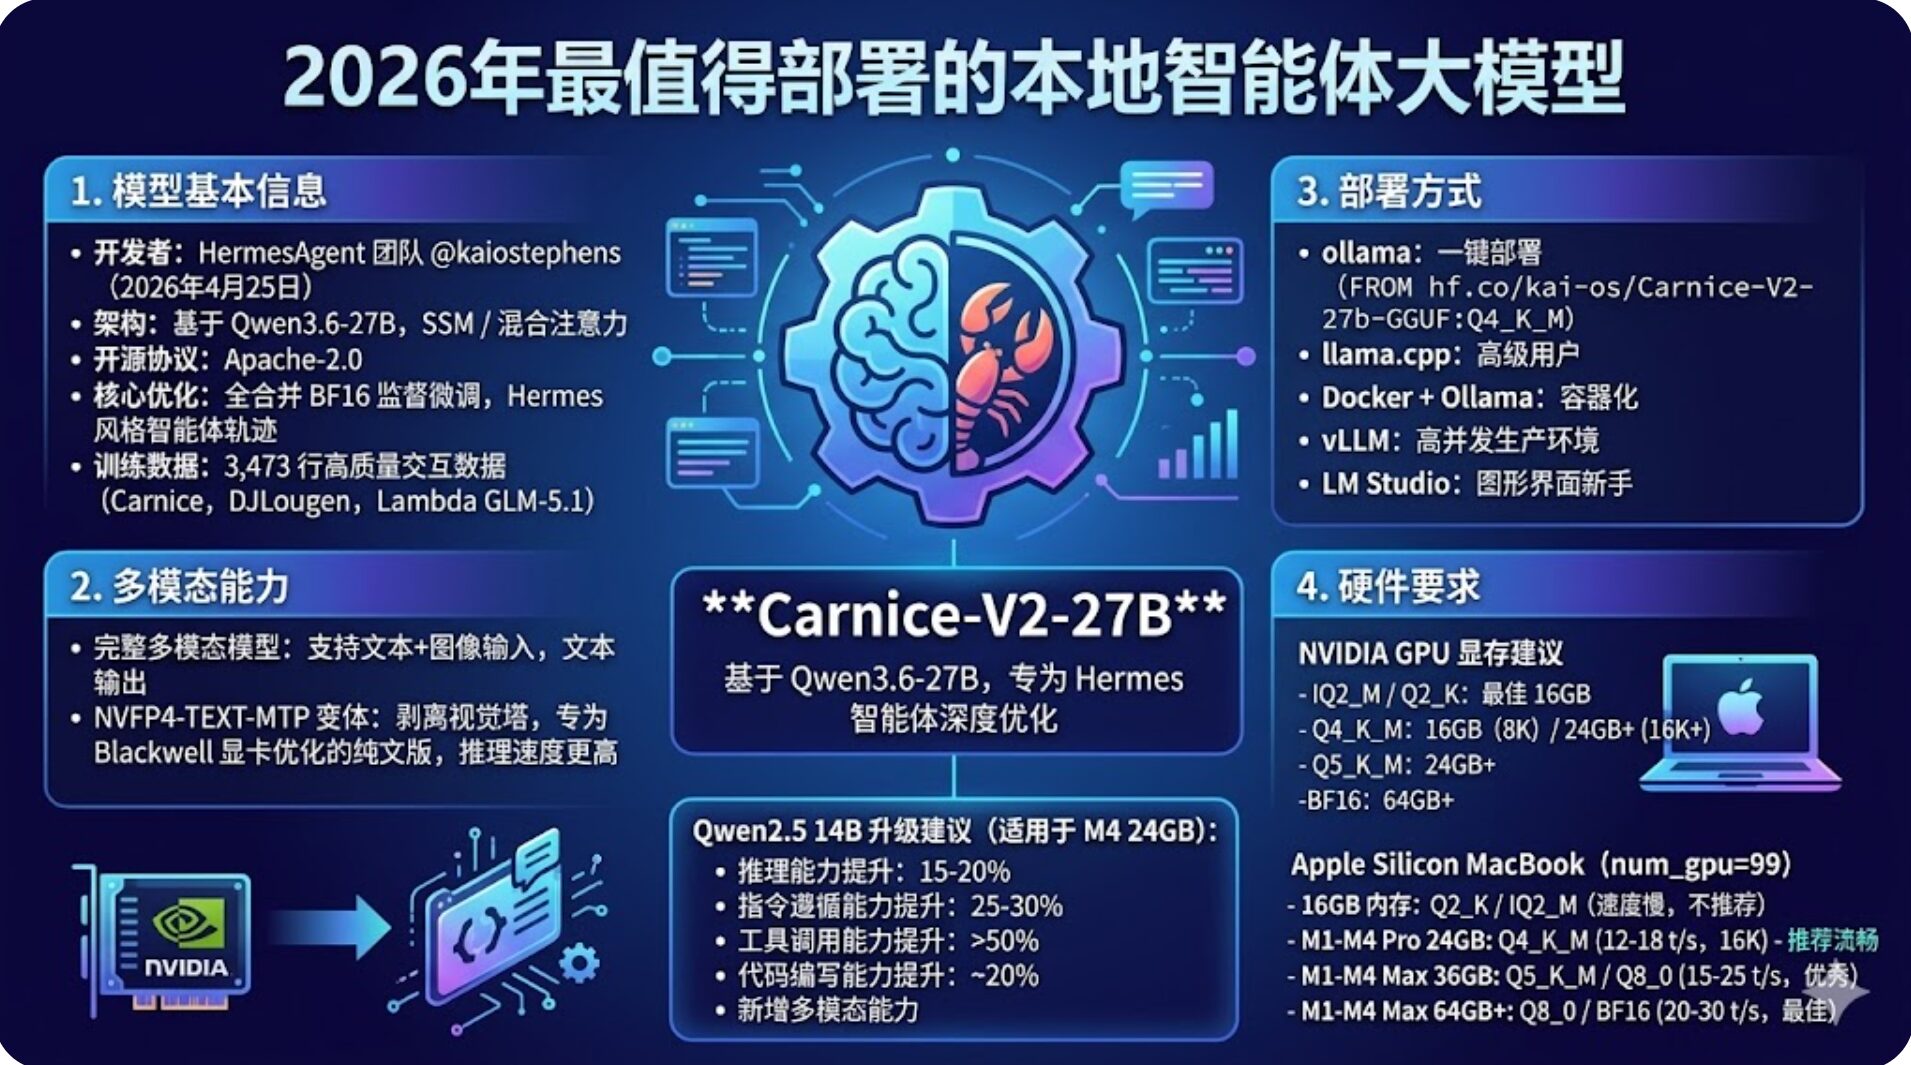
Carnice-V2-27B 是由 HermesAgent 团队的 @kaiostephens 于 2026 年 4 月 25 日发布的开源大语言模型。它基于通义千问最新的 Qwen3.6-27B 进行全合并 BF16 监督微调,专门针对 Hermes 风格的智能体轨迹进行了深度优化。
这款模型采用 Apache-2.0 许可证,完全开源且可用于商业用途。与许多只提供 LoRA 适配器的微调模型不同,Carnice-V2-27B 提供了完整的合并权重,大大降低了部署复杂性。它继承了 Qwen3.6 架构的混合注意力 / SSM 层设计,在保持高效推理的同时提升了长文本处理能力。
在训练过程中,团队使用了 3,473 行高质量的智能体交互数据,分割为 6,554 个训练窗口。这些数据包括专门的 Carnice 数据集、DJLougen Hermes 数据以及 Lambda GLM-5.1 Hermes 数据,确保了模型在工具调用和任务规划方面的出色表现。
二、多模态能力
Carnice-V2-27B 是一款完整的多模态模型,支持同时处理文本和图像输入并生成文本输出。它完整继承了基础模型 Qwen3.6-27B 的视觉能力,提供了专门的 AutoModelForImageTextToText 加载接口。
对于不需要视觉功能的用户,团队还提供了一个纯文本变体 Carnice-V2-27b-NVFP4-TEXT-MTP,它剥离了视觉塔,专门为 NVIDIA Blackwell 显卡进行了优化,在纯文本任务上能提供更高的推理速度。
三、部署方式
Carnice-V2-27B 支持多种部署方式,满足不同用户的需求:
- Ollama:最简单易用的部署方式,适合大多数普通用户
- llama.cpp:底层推理引擎,性能更好,适合高级用户
- LM Studio:图形界面操作,无需命令行,特别适合新手
- Docker + Ollama:容器化部署,便于环境隔离和管理
- vLLM:高性能推理引擎,适合生产环境和高并发场景
Ollama 一键部署(官方推荐)
现在 Ollama 支持直接从 HuggingFace 拉取模型,无需手动下载文件和创建 Modelfile,一条命令即可完成部署:
ollama run hf.co/kai-os/Carnice-V2-27b-GGUF:Q4_K_M高级自定义部署(可选)
如果你需要自定义模型参数,可以创建 Modelfile 进行更精细的配置:
- 创建 Modelfile:
FROM hf.co/kai-os/Carnice-V2-27b-GGUF:Q4_K_M
TEMPLATE "{{ .System }}\n\nUSER: {{ .Prompt }}\nASSISTANT:"
PARAMETER num_gpu 99
PARAMETER temperature 0.7
PARAMETER num_ctx 8192- 创建并运行模型:
ollama create carnice-v2-27b -f Modelfile
ollama run carnice-v2-27b
四、硬件要求
NVIDIA GPU 硬件要求
Apple Silicon MacBook 硬件要求
重要提示
16GB 内存的 MacBook 不建议运行 27B 级别模型,即使是最低量化版本也会导致系统频繁交换到磁盘,速度极慢且影响整体稳定性。对于 NVIDIA 16GB 显卡用户(如 RTX 4060 Ti 16GB),Q4_K_M 版本在 8K 上下文下可以勉强运行,但建议关闭其他占用显存的应用。
需要注意的是,KV 缓存会占用额外的内存空间。8K 上下文大约需要 2GB 内存,16K 上下文则需要约 4GB 内存。在 Apple Silicon 上,将 num_gpu 设置为 99(所有层都在 GPU 上运行)几乎总是正确的选择,因为统一内存架构不需要在 CPU 和 GPU 之间复制权重。
五、与主流本地模型对比
与基础模型 Qwen3.6-27B 的对比
Carnice-V2-27B 在保持 Qwen3.6-27B 所有基础能力的同时,在智能体相关任务上有显著提升:
与其他同级别模型的对比
与不同尺寸模型的对比
7B-14B 级别模型如 Llama 3.1 8B、Qwen2.5 14B 等,硬件要求更低(8-12GB 显存),但在复杂推理、长文本处理和智能体任务上的表现明显不如 27B 级别模型。
34B-70B 级别模型如 Llama 3.3 70B、Qwen2.5 72B 等,能力更强,但硬件要求也显著提高(32GB+ 显存),在普通家用电脑上运行困难。
六、M4 24GB MacBook 最佳配置与升级建议
对于使用 M4 芯片 24GB 内存 MacBook 的用户,强烈推荐选择 Q4_K_M 量化版本。这个版本的文件大小约为 16.5GB,在 M4 24GB 上运行时,内存占用约为 17.5GB,剩余约 1.8GB 用于 KV 缓存和系统开销,可以安全地支持 8K-16K 上下文长度。
预期性能
在 M4 24GB MacBook 上,Carnice-V2-27B Q4_K_M 的生成速度约为 12-18 tokens / 秒,首字延迟在 150-250ms 之间,单张图片分析约需 2-3 秒。
与 Qwen2.5 14B 的对比
如果你目前正在使用 Qwen2.5 14B,升级到 Carnice-V2-27B 会带来全方位的明显提升:
- 通用推理能力提升约 15-20%,复杂逻辑题和数学计算的错误率显著降低
- 指令遵循能力提升约 25-30%,几乎不会偏离指令要求
- 工具调用能力提升超过 50%,多步工具调用几乎不会出错
- 代码编写能力提升约 20%,能够生成更长、更复杂的代码块且 bug 更少
- 新增多模态能力,可以分析图片、图表、截图和手写文字
- 对话自然度提升约 10%,回答更连贯,更少重复
唯一的缺点是速度会稍慢一些,Carnice-V2-27B 的速度大约比 Qwen2.5 14B 慢 20-30%,但这个差距在日常使用中基本可以忽略。
M4 专属优化建议
- 部署前关闭 Safari、Chrome 等内存占用大的应用,确保有足够的统一内存
- 使用最新版 Ollama(0.4+),对 M4 芯片有专门优化,速度提升约 15%
- 保持系统版本为 macOS 15.4 或更高,Apple 在最新系统中对大模型推理进行了多项优化
七、安全建议
- 验证模型来源:只从官方 HuggingFace 仓库下载模型文件,避免运行来源不明的第三方 GGUF 文件
- 及时更新软件:保持推理引擎(Ollama、llama.cpp 等)为最新版本,修复潜在的安全漏洞
- 保护本地服务:不要在公共网络上暴露本地推理服务,防止未经授权的访问
- 权限管理:不要给予本地推理服务不必要的系统权限
八、总结
Carnice-V2-27B 是目前最优秀的面向智能体任务的开源大模型之一。它基于最新的 Qwen3.6-27B 进行微调,保留了完整的多模态能力,同时在指令遵循和工具调用方面有显著提升。
对于拥有 24GB 显存 NVIDIA GPU 或 24GB 统一内存 Apple Silicon MacBook 的用户来说,Carnice-V2-27B 是一个极佳的选择。它提供了出色的综合能力,完全开源免费,能够满足大多数个人和小型团队的本地 AI 需求。
如果你主要使用模型进行日常聊天和简单问答,Qwen2.5 14B 已经足够好。但如果你经常需要处理复杂任务、编写代码、使用工具调用或者需要多模态能力,Carnice-V2-27B 绝对值得升级。