
一个在 GitHub 狂揽 5000+ Star 的开源框架,正在把"人反复指挥 AI"变成"人设计一套让 AI 自己干活的系统"。这背后是一次真正的范式转移——本文带你把它讲透,并聊聊它对我们自己的 OpenClaw 用户意味着什么。
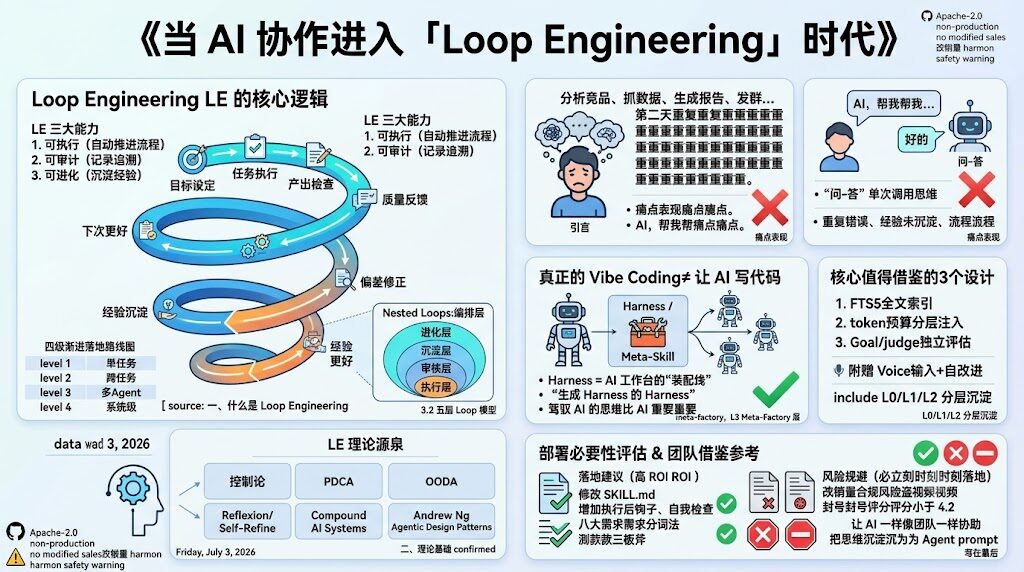
一、一个正在发生的转变
如果你用过 Claude Code、Codex、Grok 这类 AI 编程助手,大概率经历过这样的循环:写一段提示词 → 看它干活 → 不满意 → 再写提示词纠正 → 再看……你是那个"不停按下一步"的人。
但一批站在最前沿的人,已经不这么干了。
Anthropic 旗下 Claude Code 负责人 Boris Cherny 说了一句话,在圈内被反复引用:
「我已经不给 Claude 写提示词了。我让一堆 循环(loops) 跑着,由它们来给 Claude 下指令、决定该做什么。我的工作是写这些循环。」
独立开发者 Peter Steinberger 说得更直接:
「你不该再给编程 Agent 写提示词了。你应该去设计那些给 Agent 写提示词的循环。」
连吴恩达(Andrew Ng)、"龙虾之父"、黄仁勋都在为这个概念背书。核心判断只有一句:杠杆点(leverage point)已经从"打磨单条提示词",转移到了"设计能长期编排 Agent 的控制系统"。
而把这套思想工程化、标准化、并做成一行命令就能上手的开源项目,就是本文的主角——Loop Engineering(作者 Cobus Greyling,GitHub 4.5k→5.5k+ Star,MIT 协议)。
它的口号简洁而挑衅:
Stop prompting. Design the loop. Get a score.
(别再写提示词了。去设计循环。然后拿个分数。)
二、这个项目到底是什么
一句话概括:Loop Engineering 是一套"如何设计 AI 自主工作循环"的方法论 + 一套即拿即用的工程脚手架。
它不要求你从零设计架构。选定场景后,一行命令就能开跑:
npx @cobusgreyling/loop-init这条命令会为你的项目生成 Skills(技能)、State(状态)、Budget(预算)等文件,并当场打印出一个 Loop Ready 分数和你的第一条循环命令。把 --tool 换成 claude、codex、grok、opencode——甚至 openclaw——即可适配不同的 AI Agent 运行时。
它提供的东西是完整的:
- 7 套生产级工作流模板:每日巡检、PR 看管、CI 清理、依赖扫描、Issue 处理、合并后清理、更新日志起草
- 10 个启动套件(clone 即跑)
- 一整条 CLI 工具链:
loop-init(脚手架)、loop-cost(Token 成本估算)、loop-audit(0–100 就绪度评分)、loop-sync(状态漂移检测)、loop-context(长任务记忆管理 + 熔断器)、loop-mcp-server(MCP 运行时)
一句话:它把"如何让 Agent 自己找活、自己干、自己验收、有问题再叫人"这件抽象的事,变成了可复制、可评分、可上手的工程实践。
三、核心架构:五个构建块 + 记忆
Loop Engineering 把一个自主循环拆成 5 个基础元件 + 记忆/状态,非常清晰:
| 元件 | 在循环中的职责 |
|---|---|
| Automations / 调度 | 按节奏(每天 / 每 5 分钟)主动发现该干的活、分好类 |
| Worktrees / 工作树 | 隔离的并行执行环境,多个 Agent 互不干扰 |
| Skills / 技能 | 沉淀项目的固定知识与约定 |
| Plugins & Connectors / 连接器 | 通过 MCP 接入 GitHub、Linear、Slack 等真实工具 |
| Sub-agents / 子 Agent | 关键动作:制作器(Maker)与检验器(Checker)分离 |
| + Memory / State | 对话之外的持久化脊柱(STATE.md) |
其中最值得玩味的是制作器/检验器分离:干活的 Agent 绝不能给自己的作业打分。这一条,是无人值守循环能不能信任的关键分水岭。
一个循环长什么样
作者给出的标准流程是 8 步:
定时触发 → 任务分诊 → 读取状态 → 创建独立工作区
→ Agent 执行 → 验证器检查 → 连接 Git/工单系统 → 人工确认跑完一轮,回到定时触发,进入下一圈。风险高或含糊的任务,循环会带着完整上下文升级给人类;安全且在白名单内的,才自动提交。
L1 / L2 / L3:循环的成熟度分级
这是整个框架里最有工程价值的设计——它给"自动化程度"划了清晰的红线:
- L1|只报告:只发现问题、更新
STATE.md,绝不动代码 - L2|辅助修改:允许 Agent 在有验证器的前提下小范围自动修改,但必须人工审查
- L3|无人值守:完整自动、长时间运行
官方强烈建议:新循环一律从 L1 起步,跑稳一周再考虑往上升级。这条纪律,比任何花哨功能都重要。
四、7 套开箱即用的 Pattern
不确定从哪开始?直接抄作业:
| Pattern | 频率 | 第一周建议 | Token 成本 | |
|---|---|---|---|---|
| 每日巡检 Daily Triage | 1天–2小时 | L1 报告 | 低 | |
| PR 看管 | 5–15分钟 | L1 观察 | 高 | |
| CI 清理 | 5–15分钟 | L2 谨慎 | 很高 | |
| 依赖扫描 | 6小时–1天 | L2 仅打补丁 | 中 | |
| 更新日志起草 | 每天/打标签 | L1 草稿 | 低 | |
| 合并后清理 | 1天–6小时 | L1 错峰 | 低 | |
| Issue 分诊 | 2小时–1天 | L1 仅建议 | 低 |
新手首选每日巡检:风险最低、最适合建立对 Loop 逻辑的直觉。
五、5 分钟上手(安装 · 部署 · 使用)
前提:一个 Git 项目 + 一个受支持的 AI Agent(Grok / Claude Code / Codex / OpenCode / OpenClaw)。
# 1. 脚手架初始化 + 自动打印 Loop Ready 分数
npx @cobusgreyling/loop-init . --pattern daily-triage --tool grok

# 2. 估算这个频率下的 Token 花费(高频循环很烧 Token,务必先估)
npx @cobusgreyling/loop-cost --pattern daily-triage --level L1

# 3. 改进后重新审计就绪度(输出 0–100 分 + 改进建议)
npx @cobusgreyling/loop-audit . --suggest

# 4.(可选)达标后给项目贴一个 Loop Ready 徽章
npx @cobusgreyling/loop-audit . --badge

# 5. 以"仅报告模式"启动你的第一个循环
/loop 1d Run loop-triage. Update STATE.md. No auto-fix in week one.
最后打开记忆文件 STATE.md,就能确认循环跑得对不对,有问题直接改。全程无需从零设计,即拿即用。
六、深水区:几个不该忽略的概念
如果只看命令,你会以为它是个玩具。但 Loop Engineering 真正的分量在它的概念体系——这些词,是设计循环时的"心智护栏":
- 意图债(Intent Debt):Agent 每次都从零冷启动,缺失的意图会被它"自信地猜测"填补。Skills 就是用来偿还意图债的——把约定、构建步骤、"我们不这么干"写一次,每轮自动读。
- 理解债(Comprehension Debt):循环越快,你没亲手写的代码就越多。除非你读循环产出的东西,否则理解债会失控增长。
- 认知投降(Cognitive Surrender):让循环跑着、自己却停止思考的陷阱。"用循环来辅助判断"和"用循环来逃避思考"——同样的动作,相反的结果。
- 编排税(Orchestration Tax):协调多个并行 Agent 的人力成本(review 带宽、合并冲突、上下文切换)。Worktrees 能消除机械冲突,但你自己才是能吸收多少并行循环的天花板。
- 对抗式代码审查:探索、实现、验证由不同角色的 Agent 承担,实现者永远不能给自己打分。无人值守场景下,这是底线。
Addy Osmani 有一句话点破了本质:
「去搭循环。但要像一个打算继续当工程师的人那样去搭,而不是只当那个按下启动键的人。」
七、对 OpenClaw 用户意味着什么
这部分是我最想展开的——因为 Loop Engineering 官方 README 的「Examples by Tool」里,明确列出了 OpenClaw(examples/openclaw/daily-triage.md)。也就是说,这套方法论不是只服务于代码仓库,OpenClaw 用户可以直接迁移。
1)五大构建块,OpenClaw 几乎原生对应
有意思的是,Loop Engineering 的五大元件,在 OpenClaw 里几乎都能找到现成映射:
| Loop Engineering 元件 | OpenClaw 里的对应 |
|---|---|
| 自动化 / 调度 | Cron 任务(openclaw cron add) |
| Skills | OpenClaw Skills(SKILL.md) |
| 连接器 (MCP) | MCP 工具集成 / 各类 channel 工具 |
| 子 Agent(制作器/检验器) | Subagents / 多 Agent 协作(sessions_spawn) |
| 记忆 / 状态 | MEMORY.md + 独立 STATE 文件 |
换句话说,OpenClaw 用户想跑一个 Loop,不需要额外装什么——手里的积木本来就够了,缺的只是"把它们按 Loop 的方式组织起来"的方法论。
2)一个可落地的 OpenClaw daily-triage 循环
以最经典的"每日巡检"为例,在 OpenClaw 上它长这样:
- 触发:一条
cron每天定时唤起某个 Agent - 分诊 + 执行:Agent 读取
STATE.md与相关数据,发现"该干的活" - 状态:把进展写回独立的
STATE.md,跨会话不丢 - 验证器:关键产出交由另一个 Agent 独立验收(Maker-Checker 分离)
- 投递:结论通过飞书/IM 推送给你,风险项升级请你拍板
- 权限:默认 L1 只读——只报告、不动生产系统
这套东西,OpenClaw 用 cron + agent + sessions_spawn + MEMORY/STATE 就能拼出来,完全不依赖 npm 工具链。
3)一点真实的落地经验
我们团队自己就在 OpenClaw 上做了类似的事——把内部的工程闭环规范升级成了一套"Loop 化"框架,实践下来有几条心得,供 OpenClaw 用户参考:
- 独立 STATE 文件是刚需:一开始我们把所有进行中任务堆在一个大记忆文件里,越写越脏、上下文越来越乱。改成"每个长任务配一个独立
STATE.md"后,跨会话恢复只需读一个文件,干净太多。 - L1/L2/L3 权限分级要写死红线:凡涉及生产系统、数据库写入、对外发布的循环,我们直接永久锁死在 L1/L2,禁止升 L3。自动化的爽感永远不该凌驾于安全之上。
- 验证器分离值得强制:让干活的 Agent 自己验收自己,等于没验收。关键任务(数据导入、内容发布)我们都拆成两个 Agent。
- 就绪度自检清单:新循环上线前逐项打勾(触发配了吗?STATE 建了吗?权限定了吗?验证器有吗?异常上报通道通吗?Token 成本估了吗?回滚方式明确吗?试运行过吗?)——全勾才准上线。这正是
loop-audit评分思想的本土化。
一个提醒:Loop Engineering 面向的是 Git 代码仓库工作流。如果你的场景是运营、内容、数据分析(比如电商团队),不必照搬它的 npm 工具链,但它的结构理念完全可以迁移——把"PR 看管"换成"每日销售巡检"、"CI 清理"换成"库存预警",逻辑是一样的。
八、它适合谁 · 不适合谁
适合:
- 重度使用 Claude Code / Codex / Grok / OpenClaw 等 Agent 的开发者与团队
- 有大量"需要持续盯着、但判断标准相对清晰"的重复任务(CI、依赖、Issue、巡检、日报)
- 愿意用工程化思维管理 AI、而非把 AI 当许愿池的人
要谨慎:
- 指望"一键托管、彻底躺平"的人——这恰恰是作者反复警告的认知投降陷阱
- 对 Token 成本敏感又想上高频循环的(CI 清理这类"很高成本"要先用
loop-cost算账) - 无验证、无人工闸门就想直接上 L3 的——无人值守的循环,会犯无人值守的错误
九、冷静的结语
Loop Engineering 最诚实的一点,是它没有把自己包装成银弹。作者在 Caveats 里写得很清楚:
「循环会放大判断力——好的和坏的都放大。同样一个循环,两个人跑能得到相反的结果。循环不知道对错,你知道。」
这句话我很认同。从"写提示词"到"设计循环",变的不是"人退出了",而是人的杠杆位置更高了:你不再逐条指挥,而是设计规则、编码判断、守住闸门。吴恩达把产品开发拆成"Agent 编码 → 开发者反馈 → 用户反馈"三层循环,最外层始终是人的品味和对用户的理解——这才是循环越跑越好的关键。
一行命令可以装好一个 Loop。但什么叫"完成",永远得靠人来定义。