
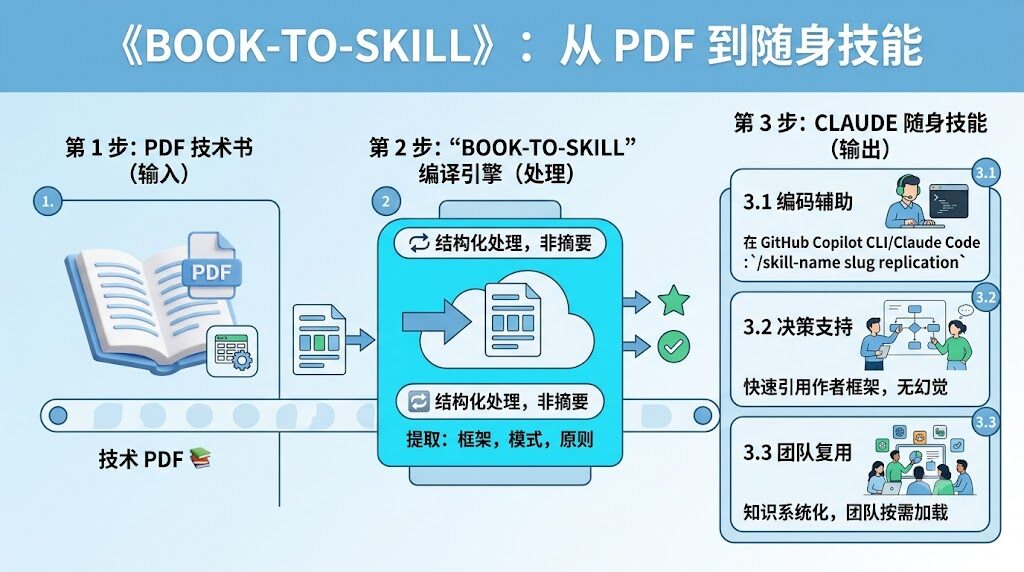
book-to-skill 是个 GitHub 今日爆款(+1,421⭐ 累计 13,006⭐)的开源工具,专门做一件事:把一本厚厚的 PDF/EPUB 技术书,编译成 Claude 这类 AI Agent 可以"按需加载"的随身技能,从此不用每次对话都把整本书塞进上下文。
为什么你会需要它
如果你手上已经买了不少技术书(《代码大全》《设计数据密集型应用》《Working Backwards》……),大概率遇到过这种场景:
- 三周前翻过的某个概念,今天想用 Agent 帮你实现,发现 Claude 完全不记得
- 把 PDF 直接拖进对话,Agent 要么产生幻觉,要么说"我没有这本书的内容"
- 即便不幻觉,每次都要消耗巨量 Token 重复塞整本书,钱包和响应速度双向遭罪
book-to-skill 解决的就是最后一公里:让 Agent 像读过你的书架一样回答问题,但不需要把整本书带在身边。
它怎么做到的(30 秒读懂原理)
核心思路借鉴了程序语言的"编译时 vs 运行时"分离:
| 阶段 | book-to-skill 做什么 | 类比 |
|---|---|---|
| 编译时(一次性) | 深度分析整本书,提取作者的核心框架、每章摘要、术语表、设计模式、快速决策表 | 像把一本书读完做思维导图 |
| 运行时(每次对话) | 只加载与当前问题相关的 SKILL.md + 对应章节 | 像考试时只翻目录对应那一页 |
输出是这套结构化文件(运行时存在本地):
SKILL.md:这本书的核心框架(~4K Token)chapters/:按章节拆分的可加载内容(每章 ~1K Token)glossary.md:术语解释patterns.md:通用设计模式/算法cheatsheet.md:快速决策表
兼容性方面:遵循 Agent Skills 开放标准,所以生成结果可以直接被 Claude Code、GitHub Copilot CLI、Amp 等多个 Agent 加载,不必重复编译。
关键数字:Token 节省 24~51 倍
作者用三本真实技术书做了实测:
| 方法 | 回答一个问题需要 | vs book-to-skill |
|---|---|---|
| 直接把整本书塞给 Claude | 119K~256K Token | 1× |
| 用 discovery loop 找相关章节 | 12K~77K Token | — |
| book-to-skill(编译后按需加载) | ~5K Token | 24×~51× 节省 |
资料来源:作者用 Think Python 2、Working Backwards、AI Engineering 三本书实测
换算成钱和速度:
- 钱:在 Claude Sonnet 这个价位,每节省 100K Token 大概省 $0.30~$1。多次对话累计下来,相当可观
- 速度:上下文越小,首字返回越快,长上下文衰减(俗称"上下文失忆")越不容易发生
book-to-skill vs RAG:两个完全不同的思路
这两者经常被一起提及,但工作时机和定位完全不同:
| 维度 | RAG | book-to-skill |
|---|---|---|
| 工作时机 | query time(查询时检索) | compile time(编译时预处理) |
| 输出 | 一堆相似文本片段 | 预提取的框架、原则、反模式 |
| 适用场景 | 宽而浅("哪本书提到 X") | 窄而深("这个框架怎么用") |
| Token 成本 | 每次查询都要重新检索 | 编译一次,永久复用 |
两者其实互补:RAG 帮你"找哪本书相关",book-to-skill 让你"精通某本书的具体用法"。比如有一个 RAG 项目叫 memory-search-v2,做的是前者;book-to-skill 做的是后者。配合用效果更好。
你能用它做什么场景
按上手难度从低到高:
| 场景 | 描述 | 适合谁 |
|---|---|---|
| 个人技术书库管理 | 把你买过的所有 PDF 技术书一次编译,Agent 永久可查 | 程序员、独立开发者、技术博主 |
| 团队知识沉淀 | 让团队 Agent 具备"读过"公司某本规范手册的能力 | Tech Lead、文档负责人 |
| 电商运营干货 | 把《精益创业》《增长黑客》这类书编译,Agent 帮你做运营决策 | 电商运营、独立站老板 |
| 小语种学习 | 编译一本英文原版教材,让 Agent 用中文给你讲解 | 自学者、家长 |
上手指南(5 分钟跑通)
book-to-skill 是个命令行工具,Python 写的:
# 1. 装
pip install book-to-skill

# 2. 编译一本书(自动分流:技术书走 Docling,文字书走 pdftotext)
book-to-skill compile path/to/your-book.pdf --output ./my-skills/

# 3. 在 Claude Code 里加载
# 让 Claude Code 读 ./my-skills/SKILL.md,它就知道这本书讲了什么
支持的文件格式:PDF、EPUB、DOCX、TXT、Markdown、HTML、RTF、MOBI,基本涵盖了你在市面上能买到的所有电子书格式。
为什么要按"Agent Skills 开放标准"
这是一点容易被忽略但很关键的细节:
如果你自己写一套私有格式让 Agent 加载,那你跟某个 Agent 工具就锁定了 —— 换工具要重做。
book-to-skill 选的是 Anthropic 等公司推动的 Agent Skills 开放标准,同一份编译结果:
- ✅ Claude Code 直接读
- ✅ GitHub Copilot CLI 直接读
- ✅ Amp 直接读
- ✅ 未来遵循同一标准的 Agent 工具都能读
不会因为换 Agent 而要重新编译所有书。
同类项目对比
| 工具 | 定位 | 与 book-to-skill 的关系 |
|---|---|---|
| NotebookLM | Google 出品,上传 PDF 后对话 | 闭源、只在自己平台、不导出 |
| ChatGPT 自定义 GPTs | 上传 PDF 训练专属 GPT | 闭源、按 GPT 计费、不开源 |
| SmolLM/RAG 项目 | 通用文档检索 | 适合宽而浅,与 book-to-skill 互补 |
| book-to-skill | 开源、编译一次、永久复用、跨 Agent | 适合窄而深、可与 RAG 搭配 |
如果你已经习惯用 NotebookLM 或自定义 GPT,但又嫌它们锁死在自己平台里,book-to-skill 是一个更开放的替代。
你可能不需要它的场景(反面参考)
诚实地说:
- 你的日常工作只需要查 1~2 本书 → 直接把 PDF 拖进对话也许更简单
- 你的内容是 Web 文章、YouTube 字幕这类非结构化素材 → 用传统 RAG 检索更划算
- 你需要的不是"AI 帮你读书",而是"AI 帮你整理读书笔记" → 这是另一个赛道(笔记 AI)
💡 真实可参考的落地场景
一个用得起来的最小例子:你花了三周读完《Working Backwards》(Amazon 工作方法论),但日常工作里想用"从小往大倒推需求"这个方法时总是想不全。这时候:
- 用
book-to-skill compile working-backwards.pdf --output ./wb-skill/编译一次(约 5~10 分钟,机器活儿) - 在 Claude Code 里说:"用 wb-skill 帮我设计一个新功能的 PRD"
- Claude 会基于作者 Capos 的核心框架、决策原则、反模式给你出方案 —— 就像真的读过这本书
整个过程 Token 消耗只有 5K 左右,不到塞整本书的 1/24。
写在最后
book-to-skill 本质上是在回答一个问题:Token 经济。
每次对话都把整本书塞给 Agent,本质是"重复劳动"—— Agent 每聊一次都要重新"读"一遍。编译时一次性分析,是把"理解"和"使用"在时间轴上分开,是把重计算放在前面、把轻计算留给运行时。
这个思路完全可以迁移到你自己的 Agent 工作流设计:哪些是"每次都要重新理解"的?能不能提前编译?编译一次能省多少 Token?
具体到 book-to-skill 这一份,是 24~51 倍。
- 项目地址:github.com/virgiliojr94/book-to-skill
- License:开源(具体见 GitHub)
- 兼容性:Claude Code / GitHub Copilot CLI / Amp(遵循 Agent Skills 开放标准)
- 支持格式:PDF / EPUB / DOCX / TXT / Markdown / HTML / RTF / MOBI