
一个被运营圈低估的信号
过去两年,国内 AI 圈卷的是"谁的模型更大、跑分更高"。但 2026 年的风向悄悄变了——大家开始关心"怎么把大模型塞进客户的笔记本里"。今天突然冲榜的项目,正是这股风向下最典型的代表:它把"中文预训练"和"模型压缩"这两个工程难题,压到了前所未有的低点。
对于内容创作者、电商运营、跨境创业者来说,这个项目的真正价值不在于"又一个 AI 模型",而在于它让中文 AI 应用的预训练成本和部署成本同时下降。本文给你一份完整的拆解。
VoxCPM 到底是什么?
VoxCPM 是 OpenBMB(Open Lab for Big Model Base)团队推出的中文 AI 模型项目。它做的事情分两步:
- 第一步:在大量中文语料上预先训练一个"基础模型"。
"预训练"可以理解成:让 AI 把整个中文世界里能找到的公开文本"读一遍",学会中文的语法、语义、上下文。VoxCPM 用的是当前最主流的 Transformer 架构(你可以把它想象成 AI 的"大脑骨架")。 - 第二步:让用户在这个基础上做"二次开发"。
你不用从零训练一个 AI 模型,而是直接在 VoxCPM 上"装修"——加任务、加数据、压缩体积——快速满足自己的业务需求。
说人话就是:别人花几个月、几百万人民币从零训练一个 AI 大模型,而 VoxCPM 把"地基"提前打好,你直接盖房子就行。
4 个核心能力,每个都瞄准运营人痛点
1. 大规模中文预训练
VoxCPM 已经在海量中文语料上"读过书"了。这意味着它天生懂中文的语法、语义、上下文,不需要你再喂大量中文数据给它"补中文课"。这对做中文内容、做小红书/公众号/抖音脚本的运营人来说,是直接可用的底座。
2. 多任务适配器(Multi-task Adapter)
同一个底层模型,可以同时用于文本生成、智能问答、内容摘要、分类打标等多个任务。不用为每个场景单独训练一个模型。这对中小团队来说,省下的不只是算力,更是"养一个算法团队"的人力成本。
3. 自定义微调(Fine-tuning)
你可以在 VoxCPM 的基础上,用自己行业的业务数据继续训练,让它专门懂你的行业。比如:医疗、法律、电商、教育、本地生活。每个垂直领域都可以"养"出一个懂行话的 AI 助手。
对电商运营来说,意味着你可以训练一个"比你自己还懂你店铺产品"的内容生成助手。
4. 模型压缩与加速
这一点是 VoxCPM 最值得关注的地方,也是它能冲到 Trending 第 3 的核心原因。它用了两项关键技术:
- 量化(Quantization):
把模型参数从高精度数字(FP32)简化成低精度数字(INT8/INT4),模型体积可以压缩 4-8 倍,几乎不损失精度。 - 知识蒸馏(Knowledge Distillation):
让小模型去"模仿"大模型的行为,保留 90% 以上能力,但只需要 10%-20% 的算力。
结果就是:一个原本需要 4 张 A100 显卡才能跑的大模型,经过 VoxCPM 的压缩方案后,可能只需要一张消费级显卡,甚至一块 MacBook 的 M 系列芯片就能流畅运行。
和同类项目比,VoxCPM 处在什么位置?
| 项目名称 | 模型规模 | 语言支持 | 核心优势 | 适合谁 |
|---|---|---|---|---|
| OpenBMB / VoxCPM | 大规模(具体未公开) | 中文为主 | 高效的模型压缩与量化技术 | 想做中文 AI 应用、又担心部署成本的中文团队 |
| Hugging Face / Bloom | 176B 参数 | 多语言(46种) | 跨语言能力强,社区活跃 | 需要多语言切换的国际化产品 |
| 阿里通义 / Qwen 系列 | 7B / 14B / 72B 等 | 中英双语 | 问答、代码、数学强;中文社区成熟 | 需要稳定中文对话 + 编程辅助 |
| 智谱 / ChatGLM2-6B | 62 亿参数 | 中文为主 | 小体积、单卡可跑、中文对话流畅 | 预算有限、想本地部署的中小团队 |
一句话总结:VoxCPM 不一定是中文能力最强的,但它在"大模型压缩到本地可跑"这条工程路线上做到了极致。如果你关心的是"成本"和"能不能塞进小设备",它就是当下最值得关注的中文 AI 项目之一。
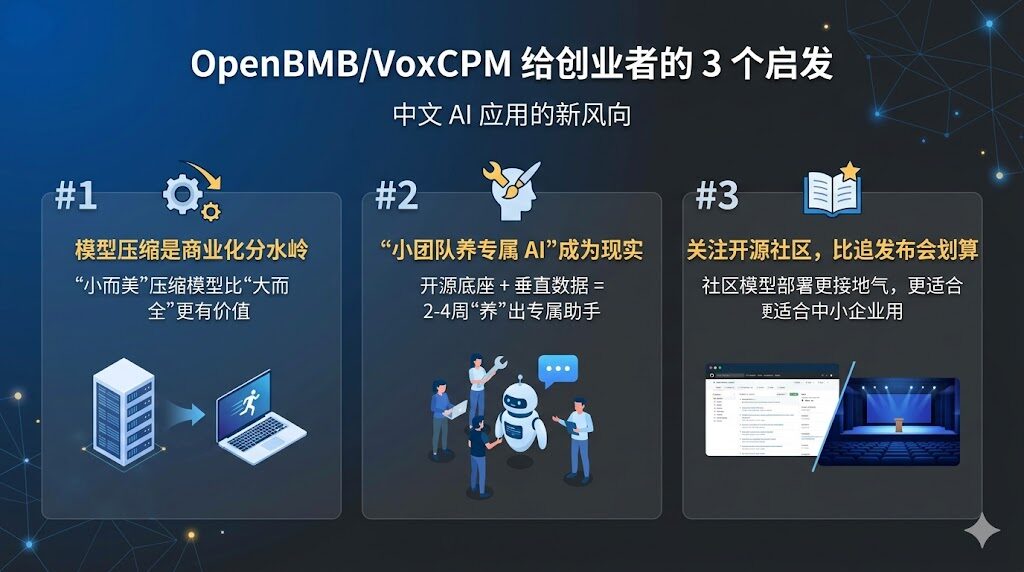
对创业者 / 运营人的 3 个实际启发
启发 1:模型压缩是中文 AI 创业的下一个分水岭
过去两年,大家卷的是"谁的模型更大、跑分更高"。但 2026 年开始,真正决定商业化成败的是"模型能不能在客户的设备上跑起来"。你的客户是医院、学校、工厂、零售门店——他们没有 A100 显卡集群。
VoxCPM 这类项目证明:"小而美"的压缩模型,比"大而全"的千亿参数模型更有商业落地价值。这是 AI 创业者的下一个机会窗口。
启发 2:自定义微调让"小团队养专属 AI"成为现实
过去微调一个大模型需要几百万人民币 + 算法团队。现在基于 VoxCPM、Qwen、ChatGLM 这类开源底座,一个 2-3 人的小团队,用几千块钱的显卡租赁 + 几百条行业数据,就能在 2-4 周内"养"出一个专属的垂直 AI。
对内容创作者来说,这意味着:你完全可以训练一个"永远不疲倦、永远按你风格写"的 AI 内容助手。
启发 3:关注开源社区,比追发布会更划算
VoxCPM 一夜涨 408⭐不是偶然,而是 OpenBMB 团队长期投入中文 AI 开源生态的结果。OpenBMB、清華 KEG、智谱 Hugging Face——这些社区产出的模型,往往比大厂的发布会版本更适合中小企业用,因为它们的工程文档、部署教程、社区答疑更接地气。
💡 落地案例:什么情况下你真的需要它?
如果你的业务场景是——日常文案写作、小红书笔记生成、客服问答、电商详情页优化——现有的 Ollama + qwen2.5 本地部署方案已经能覆盖 90% 的需求,暂时不需要为 VoxCPM 单独投入资源。
但如果你正在做——医疗、法律、教育这类强专业领域的中文 AI 产品,或者你的客户对"数据不能出本地"有强合规要求——那 VoxCPM 的模型压缩方案值得深入研究,它可能是你把"本地化大模型"塞进客户笔记本的关键技术。
无论哪种情况,你都可以用类似思路去评估任何一个 GitHub Trending 项目:先看它解决什么工程难题,再看你的业务场景是否真的撞到这个难题。撞上了 → 深入研究;没撞上 → 收藏观察。